Поки роблю LiteLLM (див. LiteLLM: AI Gateway для LLM – overview можливостей), то з’явилась ідея окрім сервісів типу нашого Backend API – помоніторити і Claude Code девелоперів. Чисто інтересу заради – аби побачити що там взагалі є і хто як використовує нашу Anthropic Organization, бо у багатьох там підписка за 200 баксів, яку оплачує проект (в мене дешманська за 20 😥 )
Насправді ця ідея в мене з’явилась давно, але зараз до неї повернувся, бо активно пиляю моніторинг AI, і коли почав робити LiteLLM – то згадав і про Claude Code.
Але моніторити Claude Code з LiteLLM рішення не дуже – бо у нас subscriptions, а LiteLLM вміє тільки в API – тому роутити Claude Code через нього просто для того, аби отримати метрики і трейси така собі затєя.
Втім, Claude Code має власний вбудований моніторинг – вміє слати і трейси, і метрики, і логи в OpenTelemetry форматі, а тому можна просто скористатись ним.
Головна проблема тут була в тому, як всіх девелоперів змусити налаштувати свої інстанси – але і тут знайшлось рішення.
Хоча в більшості гайдів, які читав все ж використовують OpenTelemetry Collector, який отримує дані від Claude Code і передає до бекендів – але стек OpenTelemetry у нас поки на паузі, ще не дійшли руки, тому роблю простіше – і шлю дані відразу до VictoriaMetrics.
Всі дані Claude Code передає в форматі OpenTelemetry – але всі сервіси VictoriaMetrics чудово з ним працюють без додаткових налаштувань.
Claude Code Telemetry Config
Всі налаштування задаються через змінні оточення, з цікавих додаткових параметрів:
OTEL_LOG_USER_PROMPTS: логувати промпти юзерів – цікаво, але не треба 🙂
OTEL_LOG_TOOL_DETAILS та OTEL_LOG_TOOL_CONTENT: записувати додаткові дані про використання Tools, Skills, MCP, etc
OTEL_LOG_RAW_API_BODIES: зберігати повний зміст API запитів та відповідей – можна глянути, що там відбувається “під капотом”
А зі змінною OTEL_RESOURCE_ATTRIBUTES можемо додати кастомні атрибути.
Ще можна глянути параметри для OTEL_METRIC_EXPORT_INTERVAL – як часто Claude Code буде відправляти дані, по дефолту він їх накопичує 60 секунд і потім шле пачкою.
Поїхали тестити.
Testing locally
Спочатку глянемо локально, як воно працює і що там цікавого є – а потім додамо до нашої організації і розкатаємо на всіх юзерів.
Запускаємо в тому ж вікні термінала claude, і за пару хвилин маємо метрики.
Так як це OTel – то формат запиту буде {__name__="claude_code.token.usage"}:
З цікавих метрик тут:
claude_code.cost.usage: умовна вартість використання – умовна, бо у нас subscriptions, але Claude все одно рахує кількість токенів і знає, скільки б це коштувало при роботі напряму через API
claude_code.token.usage: власне, кількість токенів
claude_code.lines_of_code.count: скільки коду нагенерив Claude
claude_code.pull_request.count: скільки Pull Requests
Для мене і проекту цей моніторинг не такий важливий – тому не буду витрачати час на створення власної борди, як роблю зазвичай, а візьму щось готове і трохи поправлю під себе.
VictoriaMetrics та OpenTelemetry vs Prometheus naming
Єдиний момент з готовими дашбордами в тому, що вони використовують метрики в Prometheus-форматі, а так як в мене дані від Claude Code йдуть напряму до VictoriaMetrics – то і імена там будуть в OTel форматі.
Але можна додати опцію usePrometheusNaming – тоді VictoriaMetrics буде зберігати їх в звичайному форматі, див. Label sanitization.
Але взагалі на проекті ця тема з’явилась коли ми зрозуміли, що використання LLM стає важливою частиною нашого продукту – але на відміну від інших компонентів в мене нема ніякого моніторингу того, як взагалі LLM використовується, скільки токенів витрачає кожен із сервісів, скільки помилок ми отримуємо.
Тому почали все це діло “обмазувати” трейсингом для отримання даних від наших сервісів. На додачу у нас є окремий самописний OpenAI Exporter, який з OpenAI API збирає дані по токенам і витраченим грошам.
Втім, коли все “обмазали” і почали отримувати дані з різних систем в єдиний бекенд – VictoriaMetrics/VictoriaTraces – та робити дашборди в Grafana і метрики з VMAlert, то виявилась одна неприємна річ: різні компоненти використовують різні бібліотеки для роботи з LLM, різні бібліотеки для створення spans, по різному створюють атрибути – а тому доводиться робити різні дашборди, різні алерти.
Варіанти рішення тут, звісно, є: або переписувати код всіх систем з використанням однакових бібліотек – або створювати кастомні атрибути для спанів, щоб вони були однакові в усіх сервісах.
Але це, по-перше – багато змін в коді, по-друге – не хочеться обмежувати девелоперів правилами типу “використовуй тільки цю бібліотеку” або “завжди додавай такі атрибути до спанів”.
Тому вирішив подивитись на інший підхід: нехай всі роблять те, що хочуть – але всі запити від всіх систем відправляти через єдиний шлюз, AI Gateway – а він вже сам буде створювати і трейси, і метрики – і тоді у всіх буде загальний контекст у вигляді загальних атрибутів/лейблів/метрик.
Крім того, загальний гейтвей вирішить ще пачку задач – і централізований менеджмент доступів, і бюджети з лімітами, і failover між OpenAI/Anthropic, якщо одна система впала.
Сьогодні подивимось на те, що таке LiteLLM взагалі, поганяємо локально в Docker, а потім, якщо сподобається (а so far – подобається, хоча деякі питання виникли) – то запустимо в Kubernetes та інтегруємо з нашим існуючим стеком моніторингу – VictoriaMetrics, VictoriaLogs, VictoriaTraces, Grafana.
Отже, що таке таке LiteLLM: це система для створення єдиного шлюзу, яка через себе проксює всі запити до LLM і різних провайдерів – Backend API може слати запити до AWS Bedrock для RAG, клієнтські AI Agents можуть слати запити до OpenAI або Anthropic, і навіть Claude Code девелоперів можна зароутити через цей шлюз та отримати картину того, хто і скільки токенів використовує (правда, у випадку з Claude Code питання використання API, бо LiteLLM наче не вміє працювати через subscription – тільки API).
При цьому ми спокійно залишаємо вже існуючі метрики та трейси, які вже створюються із сервісів – бо вони вже звичні девелоперам і трохи інтегровані в наш моніторинг. А на додачу до них – отримаємо нові, з загальним контекстом для всього нашого проекту та AI/LLM в ньому.
Є також LiteLLM Python SDK – можна мати всі можливості LiteLLM прямо з коду без необхідності піднімати окремий proxy service.
З цікавих можливостей LiteLLM:
Admin Web UI: єдиний веб-інтерфейс для моніторингу і налаштувань
Alerting & Monitoring: з коробки маємо логи, метрики, алерти, інтеграцію з Prometheus/VictoriaMetrics та системами типу Phoenix/Langfuse
Cost tracking: з коробки автоматично моніторить витрати на роботу з моделями, повертає метрики та трейси з вартістю, можна налаштовувати бюджети на різні ключі, команди, юзерів
Centralized authentication: єдина система для управління доступами – групи, юзери, ключі, окремі бюджети і ліміти, та навіть обмеження доступу до LiteLLM по IP
Skills Registry: тримаємо всі скіли в одному місці – але це начебто тільки для Claude Code
MCP Gateway: можна мати всі налаштовані MCP servers на LiteLLM – і клієнти типу VSCode, Cursor, Claude Code просто звертаються до нього
Agent Gateway: можна мати проксі для agent-to-agent комунікації і моніторити всю цю активність
LLM Response caching: LiteLLM може тримати кеш відповідей від LLM – на той самий запит від клієнта повертати закешовану відповідь, а не робити новий запит до LLM
Memory: зберігання налаштувань і контексту між сесіями
Vector Store: LiteLLM може грати роль проксі до різних Vector Stores і записувати додаткові дані для моніторингу
Guardrails: захист конфіденційних даних – prompt injection, маскування даних юзерів
Policies: є набір готових політик, можна створювати власні
Load Balancing: автоматичне балансування між різними провайдерами та/або моделями в залежність від навантаження чи пріорітетів
Model Health Status: перевірка статусу LLM і виключення з роутінгу тих провайдерів, які недоступні
Fallbacks: автоматичний роутинг запитів, якщо модель чи провайдер недоступні
Traffic Mirroring: цікава можливість – відправляти запити одночасно до двох різних моделей, аби порівнювати результати їхньої роботи
Для чого це нам?
Кожного разу, коли хочеться запустити щось новеньке – треба спитати себе “А яку, власне, проблему ми вирішуємо”?
Конкретно в нашому випадку це:
менеджмент доступів: замість 100500 API ключів в OpenAI/Anthropic – мати налаштовані групи в LiteLLM, кожен з власними бюджетами і лімітами
моніторинг: мати загальні метрики, логи, трейси з загальними лейблами/атрибутами
failover: мати можливість автоматично переключитись на іншого провайдера, якщо на поточному вперлись в ліміти (або якщо Claude знову впав)
Запуск LiteLLM з Docker
Для повноцінної роботи Лайт потрібна база даних – в ній будуть зберігатись всі юзери та групи, налаштування моделей, бюджетів, витрати на LLM, див. What is stored in the DB.
Тому з Docker створимо два контейнери – сам Gateway та PostgreSQL для нього.
model_name: ім’я, яке отримуємо в запиті від клієнта (як ми його будемо вказувати в коді, наприклад client.chat.completions.create(model="gpt-4o-mini")
Тут PostgreSQL з health check, який використовується інстансом LiteLLM, а через змінну оточення DATABASE_URL для LiteLLM передаємо connection string для підключення до бази даних.
Генеруємо ключ для $LITELLM_MASTER_KEY – в OpenAI форматі, з префіксом sk- (“secret key”):
Заходимо на http://0.0.0.0:4000 – тут посилання на Admin UI та документація по API самого LiteLLM (Swagger Docs можна відключити з NO_DOCS=true, див. environment variables – Reference, але вцілому її цікаво глянути – бо можливостей в API дуже багато):
Логінимось в адмінку – дефолтний логін “admin“, пароль – $LITELLM_MASTER_KEY, який створювали вище:
І попадаємо в дуже приємний інтерфейс:
Вже маємо метрики, але ендпоінт саме /metrics/ – зі слешем в кінці (хоча в документації вказаний як /metrics):
$ curl -s http://localhost:4000/metrics/
...
# HELP litellm_in_flight_requests Number of HTTP requests currently in-flight on this uvicorn worker
# TYPE litellm_in_flight_requests gauge
litellm_in_flight_requests 1.0
По різним налаштуванням пройдемось далі – зараз давайте створимо “клієнта” – простенький скрипт, який звертається до OpenAI через LiteLLM.
Demo Python App – AI Client
Пишемо скрипт, який використовує OpenAI і передає один промпт:
#!/usr/bin/env python

import os
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:4000",
    api_key=os.getenv("LITELLM_MASTER_KEY"),
)

response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "Say hello in one sentence"}],
)

print(response.choices[0].message.content)
print(f"Tokens: {response.usage}")
Тут:
base_url для OpenAI: замість дефолтного OpenAI ендпоінта api.openai.com перевизначаємо ендпоінт нашого інстансу LiteLLM
model: ім’я моделі, як ми його задавали в параметрах LiteLLM – model_list.model_name
$ ./demo-llm.py
Hello! How can I assist you today?
Tokens: CompletionUsage(completion_tokens=9, prompt_tokens=12, total_tokens=21, completion_tokens_details=CompletionTokensDetails(accepted_prediction_tokens=0, audio_tokens=0, reasoning_tokens=0, rejected_prediction_tokens=0), prompt_tokens_details=PromptTokensDetails(audio_tokens=0, cached_tokens=0))
Переходимо в адмінку > Usage – і вже маємо дані по запитам:
Трейси дивимось в Logs:
Та нові метрики:
 $ curl -s http://localhost:4000/metrics/ | grep "# HELP lite"
# HELP litellm_in_flight_requests Number of HTTP requests currently in-flight on this uvicorn worker
# HELP litellm_proxy_failed_requests_metric_total Total number of failed responses from proxy - the client did not get a success response from litellm proxy
# HELP litellm_proxy_total_requests_metric_total Total number of requests made to the proxy server - track number of client side requests
# HELP litellm_proxy_total_requests_metric_created Total number of requests made to the proxy server - track number of client side requests
...
# HELP litellm_total_users Total number of users in LiteLLM
# HELP litellm_teams_count Total number of teams in LiteLLM
Тепер, як маємо сам LiteLLM та клієнта – можна подивитись що ж можемо з LiteLLM цікавого робити, і перше, що цікавить особисто мене – це моніторинг.
Monitoring, OpenTelemetry та Traces
Метрики будемо збирати з VMAgent або OTel Collector, логи – просто аутпут, який, якщо в Kubernetes, то збираємо з Promtail, vlagent, OTel filelog, whatever.
Цікаві метрики розберемо далі, але сьогодні їх збирати не будемо – бо зараз все локально в Docker, документація по всім доступним метрикам – Prometheus metrics.
А от глянути як можна писати трейси до VictoriaTraces можемо.
Замість або на додачу до “otel” можна вказати “langfuse” або “arize” для Phoenix (див. Arize Phoenix: сервіс моніторингу LLM – запуск в Kubernetes) – тоді трейси будуть відправлятись в кілька сервісів – тестив, працює, зручно, прикольно.
Перезапускаємо контейнери, в логах маємо побачити, що експортери активні:
$ ./demo-llm.py
Hello! How can I assist you today?
Tokens: CompletionUsage(completion_tokens=9, prompt_tokens=12, total_tokens=21, completion_tokens_details=CompletionTokensDetails(accepted_prediction_tokens=0, audio_tokens=0, reasoning_tokens=0, rejected_prediction_tokens=0), prompt_tokens_details=PromptTokensDetails(audio_tokens=0, cached_tokens=0))
І в VictoriaTraces шукаємо спани по {"resource_attr:service.name"="litellm"}:
Або відразу в Grafana з групуванням:
LiteLLM Span Attributes
Атрибутів прям дуже багато – просто відразу маємо все, без всяких інструментаріїв в коді.
gen_ai.response.finish_reasons: чому зупинилась генерація
Access Management
Основна концепція – можемо мати різні Organizations (але це Enterprise feature), кожна Organization може містити кілька Teams, в кожній Team – тримаємо Users, а кожен User може створювати власні API Keys – див. User Management Hierarchy.
Users логіняться у Web UI або API, а API Keys використовуємо для сервісів.
Аутентифікація та доступ
Основний метод – API Keys для сервісів або юзерів, які працюють з LiteLLM через API – там звичайні паролі для юзерів, які користуються Web UI.
Є підтримка аутентифікації з JWT – але це Enterprise фіча.
З коробки маємо SSO – “SSO is now Free for up to 5 users“, більше юзерів тільки в Enterprise, див. SSO for Admin UI.
Втім, можемо автоматизувати це з litellm-operator – може якось спробую, але не впевнений, бо оператор не офіційний.
І дуже прикольна штука – обмеження по IP, див. IP Address Filtering – але знов-таки Enterprise фіча 🙁
В результаті з Free-опцій маємо тільки власне, Teams, юзерів та API Keys.
Teams та Users
Кожній Team можна налаштувати параметри того, до яких моделей із model_list юзери і ключі цієї групи будуть мати доступ, максимальний бюджет Costs, яка група може витратити на день/тиждень/місяць, можемо задати ліміти на Tokens per minute Limit (TPM) та Requests per minute Limit (RPM) – див. Budgets, Rate Limits та Setting Team Budgets.
Крім того, є Access Groups – групуємо списки моделей, MCP або агентів в єдиний список, який потім можна підключати до Teams або Users.
Ну і в моніторингу, як бачили вище, маємо атрибути з іменами груп та юзерів – тому потім можемо будувати графіки та алерти по ним.
Бюджети та ліміти на Tokens/Requests Per Minute можна задати на рівні всього Gateway, на рівні Team, для кожного юзера в цій Team, або на окремих юзерів поза Team чи на конкретні API Keys.
Але тут є одна трохи дивна, як на мене, штука:
Team Limits застосовуються тільки для тих API Keys, які явно були створені юзером або адміном для цієї групи (мають team_id)
при цьому User з Global Proxy Role == Internal User (Create/Delete/View) може створювати власні ключі (не прив’язані до Team), не задавати їм ніяких лімітів – і спокійно спамити LLM запитами
єдине обмеження, яке ми можемо задати в Web UI при створенні нового юзера – це які моделі йому будуть доступні (хоча в API docs для /user/new є параметри max_budget, rpm_limit та tpm_limit – нижче буде приклад)
Тобто з одного боку – начебто є User, який є членом Team, і в Team ми задаємо, наприклад, Team Member RPM Limit – але при цьому цей юзер може створювати ключі, на які цей ліміт ніяк не впливає.
А єдине обмеження, яке ми можемо задати при створенні юзера в Web UI – це те, які моделі йому будуть доступні – хоча через конфіг-файл ще можна задати upperbound_key_generate_params, див. All Settings for Self Serve.
Виглядає так, наче UI просто ще не має всіх опцій, які доступні в API.
Взагалі, мабуть, треба буде писати окремий пост на тему доступів і лімітів, бо тут “нє всьо так однозначно”.
RBAC та System Roles
Простенький (принаймні на зараз, у версії v1.82.6), з кількома дефолтними ролями – але є RBAC.
Ролі поділені на три основних групи:
глобальні всього LiteLLM – admin та admin_read_only
Ну і давайте глянемо як це все виглядає на практиці: створимо Team з бюджетом та лімітами на Requests per minute, потім в цю групу додамо юзера, юзеру створимо API Key – і використаємо його в нашому Demo App.
Створення Team
Переходимо в Teams > Create Team:
Створюємо групу:
Тут задаємо доступ до всіх моделей, вказуємо загальний бюджет групи в 100 долларів на день (Reset Budget: daily), і для перевірки задамо жорсткий ліміт в 1 запит на хвилину.
Бюджети і ліміти в Team задаються на двох “рівнях” – самої групи і всіх юзерів в ній, та окремо на кожного юзера (точніше – його ключів, як створені в цій групі – див. далі), тобто:
Max Budget (USD): це бюджет всіх разом, а Team Member Budget (USD) – на кожного юзера в групі
Requests per minute Limit (RPM): на всю Team, а Team Member RPM Limit – кожного юзера в групі
Бюджети створюються як окремі об’єкти, доступні в Budgets:
І тут ловив ще одну чи то багу, чи то фічу, що після зміни значень в Team Budget значення бюджету для юзера не змінились, поки не зробив це руками саме в Budgets.
Нижче в параметрах нової Team у Router Settings можна налаштувати власні параметри для Load Balancing та Fallbacks:
Створення User у Web UI
Юзери в UI створюються через Invite, який відправляється на пошту – тому треба мати SMTP, але після створення Invite у нас буде показаний лінк, за яким можемо зареєструватись.
Клікаємо Invite User:
Задаємо роль з правами на створення ключів, вибираємо створену вище групу, в Personal Key Creation можна обмежити доступ до моделей – і це, власне, єдине обмеження, яке ми тут можемо встановити для юзера:
Ба більше: під час створення юзера в Team – йому не можна відразу задати Team Role, і він буде створений з дефолтною роллю User – але це можна змінити потім.
Клікаємо на Invite User – отримуємо посилання, яке було відправлено на пошту:
Відкриваємо його в Incognito, задаємо пароль нового юзера, і попадаємо в Web UI – але тут вже, звісно, набагато менше доступів:
Team Permissions
Вже після інвайту можемо змінити роль юзера в цій групі – бо без Admin ролі він не зможе створювати ключі в групі, і навіть встановити йому власні Member Limits/Budget:
Інший варіант дозволити створення ключів для групи – задати через Member Permissions:
Створення User API Key для Team у Web UI
Тепер під цим юзером створюємо ключ – вказуємо групу, але не задаємо RPM:
В коді Demo App міняємо назву змінної з LITELLM_MASTER_KEY на LITELLM_USER_KEY, і можна додати max_retries – аби ловити Exception відразу, як LiteLLM поверне клієнту 429:
Запускаємо скрипт – і спокійно спамимо LiteLLM запитами:
$ ./demo-llm.py
Hello! How can I assist you today?
...

$ ./demo-llm.py
Hello! How can I assist you today?
...
Тобто, якщо ми даємо юзерам можливість створювати ключі – то вони спокійно можуть робити ключі без всяких обмежень (окрім тих, що ми задамо глобально у upperbound_key_generate_params).
Але при створенні юзера чи ключа через API ми відразу можемо задавати всі потрібні ліміти.
Створення User та API Key з LiteLLM API з Rate Limit
Запускаємо скрипт два рази – і на другий знов отримуємо 429:
$ ./demo-llm.py
Hello! How can I assist you today?
...

$ ./demo-llm.py
...
openai.RateLimitError: Error code: 429 - {'error': {'message': 'Rate limit exceeded [...] }
Замість висновків
Система виглядає дійсно круто в плані того, що дозволяє мати загальний моніторинг LLM – з коробки маємо купу корисних метрик, маємо трейси. Ну і 50,000 зірок на GitHub далеко не всі збирають.
Трейси чудово інтегруються із зовнішніми системами, і дуже зручно, що з коробки можемо їх відправляти в кілька різних бекендів одночасно.
Але от з юзер менеджментом в мене виникли питання – бо якось не дуже інтуїтивно зроблено. Місцями, на перший погляд, заплутано, місцями з чимось, що виглядає як баги. Хоча вцілому можливостей по менеджменту доступів дійсно багато.
Все ж спробуємо її запустити у нас і подивимось вже в реальній роботі – благо, коли проект в MVP то можна собі дозволити експерименти.
Ну і коли буду запускати в Kubernetes – мабуть, ще раз окремо пройдусь по доступам і юзерам, бо тут треба розібратись додатково.
В RouterOS не надто гнучка система для управління доступами – далеко не RBAC в Kubernetes, але, звісно, є можливість створювати групи і юзерів з різними правами доступу.
В комплекті маємо 3 дефолтні групи:
full: повний доступ – дефолтний юзер admin саме в цій групі
write: можна змінювати більшість налаштувань – але без доступу до user management
read: тільки читати конфіг – але нічого змінювати
хоча дозвіл на reboot тут є
Всі user permissions кожного юзера в кожній групі визначаються набором політик цієї групи.
Політики дефолтні, вони вже є в системі – редагувати чи створювати нові ми не можемо.
Подивитись список груп та політики кожної групи:
/user group print
Policies
Політики діляться на дві основні групи – Login і Config.
З того, що цікаво прямо зараз:
login policies:
ssh, web, winbox: як можемо підключатись
password: зміна пароля (тільки для себе)
config policies:
read та write: читання чи редагування конфігурації роутера
policy: управління групами та юзерами
test: використання утиліт типу ping, traceroute, etc
sensitive: чи будуть відображатись ключі, сертифікати
Створення Group
Напряму підключити політики до юзера не можна – тому робимо через окрему групу, до якої потім додамо юзера.
Маємо на увазі, що один юзер може мати тільки одну групу (да, зовсім не Kubernetes RBAC…).
Створюємо групу, задаємо дозвіл на SSH чи читання конфігурації:
/user group add name=setevoy-ro policy=read,ssh
Перевіряємо список:
/user group print where name=setevoy-ro
Видалити групу – з /user group remove <ID>.
Редагування Policies для Group
Додати або видалити пермішени – /user group set.
Важливий нюанс: при set треба задавати весь новий список. Тобто, якщо передати просто “policy=web” – то група залишиться без SSH, тому передаємо всі:
/user group set [find name=setevoy-ro] policy=ssh,read,web
Або якщо треба відключити політику – вказуємо через !policy-name, або просто set без цієї політики:
/user group set [find name=setevoy-ro] policy=ssh,read,!web
Створення Users
Отримати список всіх юзерів:
/user print detail
Для кожного юзера задаються його параметри, основні:
address: звідки дозволено підключення
group: група юзера
name: ім’я
password: пароль
group=full та новий Admin User
MikroTik рекомендує видаляти дефолтного юзера admin – бо всім відоме ім’я, див. Securing your router.
Тому робимо нового адміна з дефолтною групою full та обмежуємо мережі, з яких буде доступ.
Так як тут передається пароль – то команда в історії не зберігається і відразу після Enter зникне з консолі:
/user add name=gw-setevoy-root password="change-me-now" group=full address=192.168.0.0/24,192.168.100.0/24,10.100.0.0/24 comment="New root user for RB4011"
Відключаємо дефолтного admin:
/user disable admin
Потім можна видалити взагалі з /user remove admin.
Окремо варто відключити сервіси, якими не користуємось, ну і, звісно, налаштувати фаервол – це десь в наступних частинах буде, теж в чорнетках давно лежить.
Custom Group і новий юзер
Додаємо нового read-only user з групою setevoy-ro, яку створили вище, доступ дозволяємо тільки з локальної мережі:
/user add name=gw-setevoy-ro password="change-me-now" group=setevoy-ro address=192.168.0.0/24 comment="Read only user for RB4011"
А раз є Recording Rules – то ми можемо з логів створювати метрики для алертів та Grafana dashboards.
Хоча насправді це не найкращий варіант, тим більш для якогось high load проекту, бо vmalert з Recording Rule постійно робить запити до VictoriaTraces – і тут краще підійшов би якийсь otelcol.connector.spanmetrics, який можна було б додати в pipeline.traces – але якщо OTel стеку нема або, як в моєму випадку, проект невеликий – то цілком робочий варіант робити метрики з Recording Rules.
Це вже третя частина по OpenTelemetry та VictoriaTraces, попередні тут:
Пара прикладів з моїх власних “хотєлок” на проекті – чому я почав робити таке рішення.
AWS ALB response time
У нас є метрика AWS ALB response time: тригерить алерт, коли якийсь ендпоінт починає довго відповідати. Метрика генериться з логів ALB, рахуючи поля з log record:
- record: vmlogs:alb:logs:alb_response_time:p95
  expr: |
    {namespace="ops-monitoring-ns"} app:="alb-logs-exporter" -"DEBUG" -"SQS" -"VMLOGS" -"PARSER"
    | filter not `{"date"`*
    | extract "<_> <_> <elb_id> <_> <_> <request_processing_time> <target_processing_time> <response_processing_time> <elb_status_code> <target_status_code> <received_bytes> <sent_bytes> <request_line> <user_agent> <_> <_> <_> <trace_id> <domain_name> <_> <_> <_> <_> <_> <error_reason> <_> <_> <_> <_> <conn_trace_id> <_> <_> <_>"
    | extract_regexp `.*:443(?P<uri_path>/[^/?]*).* HTTP` from request_line
    | filter target_processing_time :! "-1" and request_processing_time :! "-1" and response_processing_time :! "-1"
    | filter request_processing_time :! "" and target_processing_time :! "" and response_processing_time :! ""
    | math request_processing_time + target_processing_time + response_processing_time as total_response_time
    | rename domain_name as domain
    | stats by (domain, uri_path) quantile(0.95, total_response_time) as alb_response_time
І з нею відразу кілька проблем.
Перша: знов-таки – навантаження на бекенд, VictoriaLogs: якщо логів багато – то vmalert робить запит кожну хвилину (interval: 1m), до того ж в запиті є regex – який сам по собі доволі важкий в плані CPU/RAM.
Друга: лейбла uri_path в значенні має тільки першу частину URI. Тобто, якщо запит прийшов на /user/<name>/orders – то в метрику vmlogs:alb:logs:alb_response_time:p95 буде збережено тільки uri_path="/user".
Відповідно, коли приходить алерт, ми бачимо тільки дуже загальну інформацію – по самому ендпоінту, а не конкретного юзера.
Ну і головне, чому я поліз копати в цю тему – це те, що алерти ніяк не прив’язані до трейсів.
Зараз, якщо приходить алерт типу:
Все, що ми можемо зробити – це піти в Grafana dashboard для Kubernetes Pods і WorkerNodes, і там дивитись навантаження CPU/RAM. Якщо там все ок – то йти в дашборду по RDS, і розбиратись там.
А маючи метрики з трейсів – я можу прямо в алерті створити лінк на всі пов’язані трейси, і тоді відразу в Grafana та VictoriaTraces побачити де проблема.
Загалом дані в лейблах більш цікаві, ніж в прикладі з AWS ALB, бо є і частина SQL-запиту, і “connection ID” у вигляді “<db_user>@<db_host>:<PID>” – але знову-таки дебажити такі алерти складніше, бо треба брати цей connection ID, шукати його в логах RDS, потім ці логи якось пов’язувати з логами самого Backend API.
Натомість – можна мати аналогічну метрику з трейсів і генерити пряму лінку на Grafana/VictoriaTraces.
Отже, що будемо сьогодні робити – подивимось на метадані, які використовуються в OTLP для spans, опишемо кілька метрик з трейсів та напишемо кілька алертів.
Метрики HTTP
Наш Backend API “обмазаний” OTel auto-instrumentation (сподіваюсь, таки допишу пост по OTel та Python).
Трейси генеряться з усіх FastAPI та AWS викликів – і, використовуючи їх, можемо собі написати метрик та алертів.
В трейсах бекенду від FastAPI маємо поля (атрибути) http.route, http.status_code, duration – тому ми можемо створити зручні метрики з яких потім можемо створити зручні алерти.
Корисні span та resource attributes
Спершу на прикладі HTTP span від FastAPI подивимось в VictoriaTraces – що цікавого у нас є в span та resource attributes.
duration: час виконання запиту (в наносекундах) – корисно для метрик HTTP latency та PostgreSQL query duration
kind: визначає роль span – чи це наш сервіс оброблює запит від клієнта (тип 2 – SERVER), чи сервіс робить запит до зовнішнього ресурсу (тип 3 – CLIENT), див. Span Kind та самі значення в коді trace.proto
в прикладах нижче буде AWS буде span.kind=3, тобто “CLIENT” – наш сервіс є клієнтом, бо виконує вихідний виклик до AWS API
name: ім’я span, згенероване SDK – корисне, бо включає в себе відразу кілька інших атрибутів – простіше використовувати в фільтрах для Grafana (про це далі, коли будемо робити алерт)
k8s.namespace.name, node.name, pod.name: resource-level атрибути, які задаються або OTel Collector, або, як в моєму випадку, з Downward API в Kubernetes Deployment для Backend API (костиль, поки нема OTel Collector)
дуже корисні атрибути, бо дозволять будувати зв’язки між Pod-level metrics, Node-level, etc – дають загальний контекст для observability
span_attr:http.method та http.route: корисно відобразити і в алерті, і мати фільтр в Grafana для VictoriaMetrics
span_attr:http.target: якщо http.route вище – це саме роут у FastAPI (з плейсхолдером типу /chats/{chat_id}) – то в http.target вже маємо конкретний URI, який був викликаний
в цьому прикладі не дуже очевидна різниця, бо роут статичний, але в інших спанах вони виглядають як route="/chats/{chat_id}" – а в target="/chats/john-789?limit=10"
span_attr:http.status_code: не путати з status_code нижче – тут маємо саме HTTP-код відповіді від сервера клієнту
status_code: дуже корисний атрибут – OTel Span Status code (не HTTP status вище), який вказує на результат виконання операції – Success (1) або Error (2), див. Set Status
в цьому прикладі як раз добре видно, що HTTP-запит завершився з 503 – Service Unavailable, і, відповідно, статус цього span == Error
status_message: description до status_code – FastAPI/OTel, коли задавав значення status_code=2 додав текстовий опис помилки
trace_id: ну і ID самого трейсу, до якого відноситься конкретно цей span
Тепер, маючи список атрибутів – можемо подумати над метрикою.
Тут вибираємо всі трейси від service.name=~"kraken-.*" (Kraken – ім’я нашого бекенду), вибираємо тільки ті, які відносяться до HTTP – "span_attr:http.route":!"", вибираємо тільки з помилками 5хх.
Далі рахуємо per second rate, агрегуючи по Kubernetes Namespace, OTel Service Name, HTTP route (URI) та коду помилки.
Трохи забігаючи наперед: прикольно було б в алерті відразу створювати лінк на конкретний trace по його ID – але писати тут в метрику лейблу trace_id не варто, бо це мільйон різних значень – заб’ємо базу VictoriaMetrics.
Деплоїмо, перевіряємо, що метрика в VictoriaMetrics є:
Алерт “Backend HTTP 5xx Errors”
Аби не писати окремі алерти на Dev/Staging/Prod – використаємо Helm range.
Описуємо новий VMRule (я для зручності тримаю окремо Recording Rules та алерти) – вже з самим алертом:
apiVersion: operator.victoriametrics.com/v1beta1
kind: VMRule
metadata:
    name: alerts-kraken-traces-http
spec:

  groups:

    ##########################
    ### Kraken Traces HTTP ###
    ##########################

    - name:  Kraken.Traces.HTTP.rules

      rules:

      ##############################
      ### Kraken HTTP 5xx Errors ###
      ##############################

      {{- range .Values.alerts.traces.backend }}
      {{- $ns := . }}
      {{- range .severities }}
      {{- if not (eq . "critical") }}
      - alert: Kraken HTTP 5xx Errors
        expr: vmtraces:kraken:http:request_5xx:rate{"resource_attr:k8s.namespace.name"="{{ $ns.namespace }}",stats_result="requests_per_sec"} > 0
        for: 1s
        labels:
          severity: {{ . }}
          component: backend
          environment: {{ $ns.env }}
          ilert_routingkey: backend-{{ $ns.env }}-{{ . }}
        annotations:
          summary: "Kraken service is returning HTTP 5xx errors"
          description: |-
            HTTP 5xx error rate has been above 0 for more than `{{ "{{" }} $for }}`
            *Namespace*: `{{ "{{" }} index $labels "resource_attr:k8s.namespace.name" }}`
            *HTTP route*: `{{ "{{" }} index $labels "span_attr:http.route" }}`
            *HTTP status*: `{{ "{{" }} index $labels "span_attr:http.status_code" }}`
            *5xx rate*: `{{ "{{" }} printf "%.3f" $value }}` req/s
            <https://{{ $.Values.monitoring.root_url }}/explore?orgId=1&left=%7B%22datasource%22:%22{{ $.Values.monitoring.victoria_traces_uid }}%22,%22queries%22:%5B%7B%22refId%22:%22A%22,%22datasource%22:%7B%22type%22:%22jaeger%22,%22uid%22:%22{{ $.Values.monitoring.victoria_traces_uid }}%22%7D,%22queryType%22:%22search%22,%22service%22:%22{{ "{{" }} index $labels "resource_attr:service.name" }}%22,%22tags%22:%22http.route%3D{{ "{{" }} index $labels "span_attr:http.route" }}%22,%22limit%22:100%7D%5D,%22range%22:%7B%22from%22:%22now-1h%22,%22to%22:%22now%22%7D%7D|:grafana: VictoriaTraces>
      {{- end }}
      {{- end }}
      {{- end }}
Тут з {{- range .Values.alerts.traces.backend }} проходимось в циклі по всім значенням з values і для кожного оточення створюємо окремий алерт.
З {{- if not (eq . "critical") }} не створюю алерти CRITICAL, бо він приходить з @channel в Slack – поки це в тесті, подивитись, як буде працювати.
OTel names формат та Helm templating
Тут є цікавий момент, пов’язаний з OTel форматом імен метрик і лейбл.
Якщо в Prometheus format вони задаються через “_” – тобто у вигляді “resource_attr_k8s_namespace_name“, то OTel використовує крапки і двокрапки – і це ломає шаблонізатор Helm/Go.
Є варіант використовувати Label sanitization – писати метрики до VictoriaMetrics відразу в Prometheus-форматі, але це (поки що) не можна робити для трейсів і логів, і тоді в різних бекендах будемо мати різні імена лейбл.
Тому я поки що вирішив не включати usePromCompatibleNaming і писати дані як є, а коли вже цю опцію додадуть до VictoriaLogs та VictoriaTraces – можна буде оновити алерти.
Тут, в принципі, все аналогічно – тільки рахується не rate() – а 95 перцентиль по полю duration.
Чому 95 перцентиль, а не якийсь avg(): бо average дасть загальну “розмазану картину” по всім запитам – але може пропустити проблеми у невеликої кількості юзерів.
Recording Rule вийшов таким:
- record: vmtraces:kraken:http:request_duration:p95
  expr: |
    {resource_attr:service.name=~"kraken-.*"} "span_attr:http.route":!"" kind:=2
    | stats by ("resource_attr:k8s.namespace.name", "resource_attr:service.name", "span_attr:http.route") quantile(0.95, duration) value
Тут в фільтрах додаємо kind=2, аби рахувати дані тільки від спанів з типом SERVER – бо нам цікавий результат від самого FastAPI на Backend API.
Інакше в результати міг б попасти спан із дочірніх спанів з цього трейсу – запити від Backend API до, наприклад, DynamoDB або RDS (хоча фільтр з "span_attr:http.route":!"" має вибрати тільки HTTP).
Деплоїмо, перевіряємо метрику:
Алерт “Backend HTTP p95 latency is high”
Тут все аналогічно до алерту по помилкам 5хх.
Тільки в expression виконуємо конвертацію наносекунд в секунди – ділимо результат на 1e9 (мільярд) і тригеримо алерт, p95 latency вище 5 секунд:
{{- range .Values.alerts.traces.backend }}
{{- $ns := . }}
{{- range .severities }}
{{- if not (eq . "critical") }}
- alert: Kraken HTTP Latency p95 High
  expr: vmtraces:kraken:http:request_duration:p95{"resource_attr:k8s.namespace.name"="{{ $ns.namespace }}",stats_result="value"} / 1e9 > 5
  for: 5m
  labels:
    severity: {{ . }}
    component: backend
    environment: {{ $ns.env }}
    ilert_routingkey: backend-{{ $ns.env }}-{{ . }}
  annotations:
    summary: "Kraken HTTP p95 latency is high"
    description: |-
      HTTP p95 latency has been above 5s for more than `{{ "{{" }} $for }}`
      *Namespace*: `{{ "{{" }} index $labels "resource_attr:k8s.namespace.name" }}`
      *Service name*: `{{ "{{" }} index $labels "resource_attr:service.name" }}`
      *HTTP route*: `{{ "{{" }} index $labels "span_attr:http.route" }}`
      *P95 latency*: `{{ "{{" }} printf "%.2f" $value }}` seconds
      <https://{{ $.Values.monitoring.root_url }}/explore?orgId=1&left=%7B%22datasource%22:%22{{ $.Values.monitoring.victoria_traces_uid }}%22,%22queries%22:%5B%7B%22refId%22:%22A%22,%22datasource%22:%7B%22type%22:%22jaeger%22,%22uid%22:%22{{ $.Values.monitoring.victoria_traces_uid }}%22%7D,%22queryType%22:%22search%22,%22service%22:%22{{ "{{" }} index $labels "resource_attr:service.name" }}%22,%22tags%22:%22http.route%3D{{ "{{" }} index $labels "span_attr:http.route" }}%22,%22limit%22:100%7D%5D,%22range%22:%7B%22from%22:%22now-1h%22,%22to%22:%22now%22%7D%7D|:grafana: VictoriaTraces>
{{- end }}
{{- end }}
{{- end }}
З HTTP поки все – йдемо далі.
Метрики AWS API
Для вибору спанів, пов’язаних з AWS можемо використати фільтр по атрибуту "span_attr:rpc.system".
Тут фільтр status_code:=2 вибираємо тільки помилки:
В атрибутах спану маємо і сам stacktrace, і status_message – але їх в лейбли не пишемо, це вже можна буде глянути в Grafana.
Деплоїмо, перевіряємо метрику:
Алерт “Backend is getting errors from AWS services”
Описуємо алерт – тут все аналогічно, тільки в Grafana link робимо фільтр по name, і його ж виводимо в тексті алерта в полі Operation – бо там є і AWS service name, і тип операції:
{{- range .Values.alerts.traces.backend }}
{{- $ns := . }}
{{- range .severities }}
{{- if not (eq . "critical") }}
- alert: Kraken AWS Client Errors
  expr: vmtraces:kraken:aws:client_error:rate{"resource_attr:k8s.namespace.name"="{{ $ns.namespace }}",stats_result="requests_per_sec"} > 0
  for: 1s
  labels:
    severity: {{ . }}
    component: backend
    environment: {{ $ns.env }}
    ilert_routingkey: backend-{{ $ns.env }}-{{ . }}
  annotations:
    summary: "Kraken is getting errors from AWS services"
    description: |-
      AWS client error rate has been above 0 for more than `{{ "{{" }} $for }}`
      *Namespace*: `{{ "{{" }} index $labels "resource_attr:k8s.namespace.name" }}`
      *Service name*: `{{ "{{" }} index $labels "resource_attr:service.name" }}`
      *Operation*: `{{ "{{" }} index $labels "name" }}`
      *Error rate*: `{{ "{{" }} printf "%.3f" $value }}` req/s
      <https://{{ $.Values.monitoring.root_url }}/explore?orgId=1&left=%7B%22datasource%22:%22{{ $.Values.monitoring.victoria_traces_uid }}%22,%22queries%22:%5B%7B%22refId%22:%22A%22,%22datasource%22:%7B%22type%22:%22jaeger%22,%22uid%22:%22{{ $.Values.monitoring.victoria_traces_uid }}%22%7D,%22queryType%22:%22search%22,%22service%22:%22{{ "{{" }} index $labels "resource_attr:service.name" }}%22,%22operation%22:%22{{ "{{" }} index $labels "name" }}%22,%22tags%22:%22rpc.service%3D{{ "{{" }} index $labels "span_attr:rpc.service" }}%22,%22limit%22:100%7D%5D,%22range%22:%7B%22from%22:%22now-1h%22,%22to%22:%22now%22%7D%7D|:grafana: VictoriaTraces>
{{- end }}
{{- end }}
{{- end }}
Деплоїмо, чекаємо на алерт в Slack:
І маємо лінк на Grafana з фільтром по Operation name:
Метрики RDS
І останній приклад – із запитами до RDS.
Метрика “vmtraces:backend:db:query_duration:p95”
Описуємо Recording Rule, фільтруємо по "scope_name":="opentelemetry.instrumentation.sqlalchemy":
і є просто публічні DNS-зони, які мають резолвитись через 1.1.1.1
В resolv.conf це виглядає так:
nameserver 1.1.1.1 # CloudFlare DNS, returns EKS Endpoint Public IP
nameserver 10.100.0.1 # my MikroTik with WireGuard, returns EKS Endpoint Public IP
nameserver 10.0.0.2 # AWS VPC DNS via OpenVPN, returns EKS Endpoint Private IP EKS 10.0.64.9
Файл менеджиться з openresolv, який запускається WireGuard при старті тунелю – WireGuard прописує свої DNS:
В помилці з timeout бачимо, що запит до F07***D78.gr7.us-east-1.eks.amazonaws.com йде на IP 10.0.64.9 – тобто DNS resolution був через OpenVPN і AWS VPC DNS 10.0.0.2.
Linux DNS та systemd-resolved
Перевіряємо хто в системі взагалі відповідає за DNS – грепаємо файл /etc/nsswitch.conf:
Тут опція resolve – це використання модулю nss-resolve через D-Bus до systemd-resolved.
І він йде першим, до параметрів files (nss-files та /etc/hosts) та dns (модуль nss-dns і “класичний” glibc DNS resolver) – тому спочатку запити йдуть до systemd-resolved.
systemd-resolved, DNS resolution та network interfaces
Тепер цікава частина – як саме systemd-resolved виконує DNS resolution.
systemd-resolved використовує openresolv – дивимось його параметри:
$ resolvectl status
Global
Protocols: +LLMNR +mDNS -DNSOverTLS DNSSEC=no/unsupported
resolv.conf mode: foreign
Current DNS Server: 10.0.0.2
DNS Servers: 10.0.0.2 10.100.0.1 192.168.0.1
...
Далі перевіримо що відбувається в системі – включаємо debug log для openresolv:
...
May 20 12:06:39 setevoy-office systemd-resolved[698]: varlink-28-28: Received message: {"method":"io.systemd.Resolve.ResolveHostname","parameters":{"name":"F07***D78.gr7.us-east-1.eks.amazonaws.com","flags":0,"ifindex":0}}
...
May 20 12:06:39 setevoy-office systemd-resolved[698]: varlink-28-28: Sending message: {"parameters":{"addresses":[{"ifindex":6,"family":2,"address":[10,0,64,9]},{"ifindex":6,"family":2,"address":[10,0,65,205]}],"name":"F07***D78.gr7.us-east-1.eks.amazonaws.com","flags":1048577}}
Тут:
Received message: запит прийшов з параметром "ifindex":0 – “пофіг, де шукати“
Sending message: відповідь повернулась через "ifindex":6 – це tun0, openVPN і AWS VPC DNS
Перевіряємо інтерфейси:
$ ip -o link | awk -F': ' '{print $1, $2}'
1 lo
2 enp0s31f6
4 wlan0
5 enp0s13f0u3u4u4
6 tun0
...
"ifindex":6 – це інтерфейс tun0, робочий OpenVPN, і результат, отриманий від AWS VPC DNS – "address":[10,0,64,9], бо AWS VPC DNS буде повертати приватну адресу.
Відповідь вже з ifindex":4 – wlan0, і маємо публічний IP.
Чому – бо в тому ж логу бачимо:
...
Firing regular transaction 49587 ... IN A> scope dns on */*
Firing regular transaction 59798 ... IN A> scope dns on wlan0/*
...
Тут перший запис – це запит через global pool, на всі сервери в ньому:
$ resolvectl status
Global
Protocols: +LLMNR +mDNS -DNSOverTLS DNSSEC=no/unsupported
resolv.conf mode: foreign
Current DNS Server: 10.0.0.2
DNS Servers: 10.0.0.2 10.100.0.1 192.168.0.1
...
If lookups are routed to multiple interfaces, the first successful response is returned
І в цьому випадку це був wlan0:
...
Added positive ... cache entry ... on wlan0/INET/10.0.0.1
...
Раз запит через wlan0 – то і у відповідь від AWS DNS для EKS endpoint отримали публічний IP.
А при першій спробі це був tun0:
...
Added positive ... cache entry ... on tun0/INET/10.0.0.2
...
І у відповідь отримали приватний IP 10.0.64.9.
Отже:
systemd-resolved робить запити до всіх доступних DNS
повертає результат від того, хто перший відповів
якщо запит від wlan0, офісної мережі – отримуємо публічний IP, і підключення проходить
якщо запит від tun0, OpenVPN і AWS VPC DNS – отримуємо приватний IP, і підключення падає з таймаутом
Не забуваємо повернути лог info:
$ sudo resolvectl log-level info
Тепер переходимо до маршрутизації – чому саме підключення падає з timeout error?
VPN та Linux IP routes mess
Глянемо що в маршрутах на робочому ноуті:
$ route -n
Kernel IP routing table
Destination Gateway Genmask Flags Metric Ref Use Iface
0.0.0.0 10.0.0.1 0.0.0.0 UG 600 0 0 wlan0
10.0.0.0 0.0.0.0 255.255.255.0 U 600 0 0 wlan0
10.0.0.2 172.16.0.1 255.255.255.255 UGH 0 0 0 tun0
10.0.6.162 172.16.0.1 255.255.255.255 UGH 0 0 0 tun0
10.0.32.0 172.16.0.1 255.255.240.0 UG 0 0 0 tun0
10.0.48.0 172.16.0.1 255.255.240.0 UG 0 0 0 tun0
10.0.66.0 172.16.0.1 255.255.255.0 UG 0 0 0 tun0
10.0.67.0 172.16.0.1 255.255.255.0 UG 0 0 0 tun0
10.100.0.0 0.0.0.0 255.255.255.0 U 0 0 0 wg0
...
Тут:
10.0.0.0 через wlan0: бо це офісна мережа і у нас тут MacMini до яких треба доступ, ну і доступ в інтернет
10.0.0.2, 10.0.32.0, 10.0.48.0 etc – через tun0: це AWS VPC Private Subnets – сюди роутятся запити через робочий OpenVPN для доступу до AWS RDS і інших приватних ресурсів
10.100.0.0 через wg0: це мережа мого WireGuard через MikroTik для доступу в мої домашні мережі
А тепер – де виникає проблема: коли EKS ендпоінт резолвиться через AWS VPC DNS 10.0.0.2 – отримуємо приватну адресу 10.0.64.9.
Але для неї нема окремого роуту через OpenVPN – і вона роутиться через 10.0.0.1, офісний роутер і публічний інтернет:
$ kk get pod
[...] Get \"https://F07***D78.gr7.us-east-1.eks.amazonaws.com/api?timeout=32s\": dial tcp 10.0.64.9:443: i/o timeout"
...
Перевіряємо сам маршрут – бачимо, що піде через via 10.0.0.1, офісний роутер, а не tun0 і OpenVPN:
$ ip route get 10.0.64.9
10.0.64.9 via 10.0.0.1 dev wlan0 src 10.0.0.133 uid 1000
    cache
можна налаштувати split-DNS на локальному Unbound чи dnsmasq – і переключити всі DNS запити на нього
Варіант з 10.0.64.9 на OpenVPN – костиль.
Note: вже коли дописав весь пост – згадав, що Control Plane EKS живе у власних VPC Subnets, і я міг тупо додати їх до OpenVPN так само, як це роблено для RDS, але вже ок – вийшло все одно цікаво 🙂
Рішення зі split-DNS через systemd-resolved виглядає якось геморно.
А Unbound я вже крутив на FreeBSD для домашнього NAS (див. FreeBSD: Home NAS, part 4 – локальний DNS з Unbound), конфіг простий і зрозумілий, ще і викинути зі схеми systemd-resolved з його складностями – нормальний варіант.
Хоча dnsmasq як рішення для ноутбука може був би кращий – бо ще простіший конфіг, але мені Unbound дуже зайшов – тому зробив з ним.
Arch Linux та Unbound
Встановлюємо сам пакет:
$ sudo pacman -S unbound
Що треба зробити:
всі запити до compute.internal (AWS EC2 etc) – роутити через OpenVPN і AWS VPC DNS
всі запити до ops.example.com – теж, бо там у нас записи для AWS RDS типу db.prod.ops.example.com
всі запити до grafana.net.setevoy – роутити через MikroTik, бо це моя локальна зона для домашніх хостів
решту – відправляємо на 1.1.1.1 та 8.8.8.8
Пишемо файл /etc/unbound/unbound.conf, описуємо три forward-zone з власними DNS і одну з публічними DNS:
На проекті потроху доросли до того, що пора вже мати повноцінний трейсінг – аби побудувати реальний observability, а не просто моніторинг.
Колись давно робив аналогічне з Jaeger – монстр, і десь він так в чорнетках 2019 чи 2020 року і залишився, ну а так як зараз у нас весь стек VictoriaMetrics – сама VictoriaMetrics для метрик та VictoriaLogs для логів – то і для трейсів будемо використовувати рішення від команди VictoriaMetrics – VictoriaTraces.
Тим більш VictoriaTraces набагато легша як в ресурсах – так і в налаштуванні. Мабуть, можна порівняти Loki та VictoriaLogs та Jaeger з VictoriaTraces – аналогічно набагато простіший сетап, набагато менше ресурсів CPU/RAM.
Цей пост планувався першим в серії по traces – тому тут спочатку буде більше теорії по Observability та OpenTelemetry, а далі вже запустимо VictoriaTraces в Kubernetes.
Перше, про що хочеться написати окремо – це, власне, розібрати різницю між “monitoring” та “observability“.
Їх часто плутають або використовують як взаємозамінні – але хоча вони і дотичні, це все ж про різні концепти.
Отже, Monitoring – це коли ми заздалегідь знаємо, що може зламатись та налаштовуємо перевірки саме на це: “CPU більше 90% => алерт. Диск зайнятий більш ніж на 85% => алерт. Помилки 5xx на ALB => алерт.”
Тобто, ми відповідаємо на питання, які сформулювали наперед. По суті – це dashboard-driven підхід: дивимось на відомі метрики, реагуємо на відомі проблеми.
Observability – це коли система дозволяє відповідати на питання, які ми заздалегідь не формулювали: відбувається щось “дивне”, і ми можемо “розкопати” причину – навіть якщо ніколи раніше з таким не стикалися.
Ключове слово тут – explorability: можливість дослідити зв’язки і причини проблем.
Як приклад – виріс Backend API latency. Моніторинг просто скаже – “латенсі високий” (алерт спрацював), а observability дозволить виконати drill down – пройти весь ланцюжок і знайти root cause: latency спайк на конкретному endpoint? конкретний tenant? конкретний Kubernetes Pod? Може один upstream повільний? Тобто, ми йдемо від симптому – до причини через дані, які вже є в системі.
Власне, тому і кажуть про “three pillars of observability” – Metrics, Logs, Traces. Саме traces (distributed tracing) – це те, що зазвичай відрізняє “просто моніторинг” від observability на практиці, бо саме трейси дають можливість дослідити невідому проблему – бачити шлях запиту через сервіси та знаходити bottleneck, якого ми не передбачували.
Втім, observability – це не про якісь “магічні динамічні алерти”: ми все ще залишаємо в системі звичайні pre-defined алерти типу “якщо 5хх більше 1% – слати повідомлення в Slack”.
Але змінюється те, що відбувається після того, як алерт спрацював: ми не просто бачимо “цей домен повертає помилки” і йдемо вручну грепати логи в VictoriaLogs – а маємо можливість пройти повний шлях: від алерта в Slack – через AWS ALB – через Kubernetes Pod – до компонента в цьому Pod, і врешті-решт до конкретного method() в коді, який повертає помилку та до юзера, на запити від якого цей метод генерує помилки.
Тобто алертинг – це все ще “моніторинг” частина: observability починається в момент, коли алерт спрацював і тобі треба зрозуміти чому.
Observability – це не про виявлення проблем, а про їх дослідження.
What is: Tracing
Tracing (або distributed tracing) – це спосіб відстежити шлях одного запиту через всю систему: від моменту, коли він прийшов на ALB – через Kubernetes Pod – до бази даних, зовнішнього API або LLM-виклику, і назад.
Далі будемо говорити про VictoriaTraces, яка побудована на VictoriaLogs – бо, власне, концепт трейсінгу той самий, що і у логів: сервіс записує кожен свій “чіх” – кожен виклик, кожну дію, кожен запит до зовнішніх систем. Різниця з “просто логгінгом” в тому, що у traces є ID, який об’єднує всі пов’язані виклики в дерево, що дозволяє будувати повний шлях запиту.
Один такий шлях називається trace. Trace складається зі spans, де кожен span це одна операція – конкретний HTTP-запит, SQL-запит, виклик іншого сервісу, обробка в черзі. Span-и зв’язані між собою в дерево через trace_id (спільний для всього trace) та parent_id (хто викликав цей span).
Виглядає це приблизно так:
trace_id: abc123

[HTTP GET /api/orders]                                        # root span (120ms)
  ├─ [auth-service: validate token]                           # child span (8ms)
  ├─ [orders-service: get orders]                             # child span (95ms)
  │    ├─ [PostgreSQL: SELECT * FROM orders WHERE user_id=42] # (80ms)
  │    └─ [Redis: GET cache:user:42]                          # (2ms)
  └─ [response serialization]                                 # child span (12ms)
Кожен span цього трейсу має поле з trace_id, кожен span має поля parent_id та span_id: у root span поле parent_id буде пусте, у другого span буде parent_id == span_id першого span цього трейсу і так далі.
Кожен span окрім часу виконання може містити атрибути – key-value пари з додатковим контекстом: частина атрибутів додається автоматично (HTTP method, status code, DB statement), частина – вручну розробниками (tenant_id, row_count, cache_hit). Чим більше контексту в атрибутах – тим більше можна дослідити не додаючи нових метрик чи логів.
Наприклад (це вже з наступного посту, там розберемо детальніше):
Фактично, атрибути в traces – це labels в метриках Prometheus-формату, які ми потім можемо використовувати для пошуку трейсів і – головне – для кореляції пов’язаних метрик, логів та трейсів.
Приклад дебагу з tracing
Повернемось до прикладу, який описувався вище: маємо алерт в Slack, який каже, що Backend API latency на ендпоінт /coach виріс до 20 секунд:
В алерті є лінк на Grafana dashboard зі статусом AWS Application Load Balancer, в дашборді є посилання на VictoriaLogs з логами ALB та Backend API, лінк на дашборду з Kubernetes Pods нашого Backend API та його AWS RDS.
Метрики в Grafana dashboard показують спайк, логи – нічого підозрілого. Без трейсів далі починається гадання – йдемо дивитись CPU/RAM на Kubernetes WorkerNodes, навантаження на пов’язані Pods, Grafana dashboard для AWS RDS з PostgreSQL, намагаємось побудувати картину – де у нас виникає проблема.
З трейсами ми відкриваємо повільні traces для цього endpoint і одразу бачимо: із загальних 120ms на обробку всього реквесту – 80ms йде на виконання одного SQL-запиту. Дивимось атрибути цього span-у – db.statement: SELECT * FROM orders WHERE user_id=42, індекс не використовується: root cause знайдено за хвилину.
What is: the OpenTelemetry
OpenTelemetry (OTel) – це перш за все набір загальних “правил” по тому як дані мають збиратись і які метадані в них мають бути присутні.
Вище згадувались “three pillars of observability” – Metrics, Logs, Traces: кожна дія сервісу та його компоненту – це events, або Signals в термінології OTel.
OpenTelemetry та його OpenTelemetry Protocol (див. OTLP Specification 1.10.0) описують яким чином дані повинні передаватись (HTTP/gRPC), та які поля і заголовки вони повинні мати, таким чином уніфікуючи метрики, логи та трейси в єдиний формат.
З OTel ми збираємо ці сигнали на рівні коду, з Kubernetes Pods/Nodes або з AWS API, обробляємо, додаючи атрибути та об’єднуючи їх в загальний контекст, і передаємо до бекенду, в якому ці дані зберігаються – метрики до VictoriaMetrics, логи до VictoriaLogs, трейси до VictoriaTraces.
OpenTelemetry vs Prometheus
Коли ми працюємо VictoriaMetrics або Prometheus – у нас є звичний підхід до метрик: exporter виставляє endpoint /metrics, VictoriaMetrics з VMAgent ходить на цей ендпоінт та збирає метрики (PULL-модель). Формат метрик – простий текстовий типу metric_name{label="value"} 123.45.
В OpenTelemetry (OTel) інший підхід, бо зазвичай він працює за PUSH-моделлю: сервіс сам відправляє дані в OTel Collector, а той вже роутить їх куди треба – у VictoriaMetrics, VictoriaLogs, VictoriaTraces чи будь-який інший бекенд.
Втім, OTel Collector receivers можуть і самі виконувати запити до якихось API, наприклад – k8s_cluster робить запити до Kubernetes API /apis/apps/v1/deployments для отримання додаткової інформації по Kubernetes Pods.
Навіщо OpenTelemetry, якщо є Prometheus
Для метрик Prometheus формат і справді працює чудово, але Prometheus – це тільки метрики: він не вміє в трейси, не вміє в structured logs, і головне – не вміє зв’язати метрику, лог і трейс між собою: у нас вже є VictoriaLogs для логів, VictoriaMetrics для метрик – але все це окремі системи зі своїми форматами, тому зв’язати конкретну метрику з конкретним логом і конкретним трейсом – складно, бо в них немає спільного контексту.
OTel вирішує саме цю проблему: коли метрики, логи і трейси проходять через один SDK, то вони автоматично отримують спільний контекст – trace_id, service.name, deployment.environment, kubernetes.pod.name. В результаті ми з алерту по metric_name можемо перейти до трейсу конкретного запиту, а з трейсу – до логів конкретного span-у. Без OTel ці три системи живуть окремо, і зв’язувати їх доводиться вручну.
Компоненти OpenTelemetry
OpenTelemetry складається з трьох основних частин:
OTel SDK: вбудовується в код і генерує телеметрію
для auto-instrumentation це кілька рядків при старті сервісу – і ми одразу отримуємо span-и для HTTP, gRPC, SQL (див. Instrumentation нижче)
OTel Collector: окремий сервіс (DaemonSet або Deployment в Kubernetes), який приймає дані від SDK в сервісах, обробляє і відправляє далі до бекендів
той жеж Collector в ролі агента може сам збирати метрики і логи з Kubernetes чи AWS – теж описано в попередньому пості
OTLP (OpenTelemetry Protocol): це формат і протокол передачі даних, який працює поверх gRPC або HTTP і підтримується практично всіма сучасними бекендами – VictoriaMetrics, Grafana Tempo, Jaeger, Datadog
OpenTelemetry Instrumentation
Сам термін instrumentation в контексті OpenTelemetry і трейсингу – це процес додавання специфічного коду до сервісу або системи, який дозволяє виконувати observability цього коду.
З OpenTelemetry є три шляхи виконати instrumentation:
zero-code instrumentation: ми взагалі нічого не міняємо в коді – виклик нашого сервісу відбувається через зовнішній wrapper, який перехоплює виклики нашого коду і сам додає потрібні дані
швидко, зручно – але найменш гнучко, бо не дає можливості самому вирішувати що і де додавати
auto instrumentation: OTel SDK вміє автоматично створювати span-и для HTTP-запитів, DB-клієнтів, gRPC-викликів, додавати необхідні атрибути
для auto-instrumentation використовуємо OTel SDK шляхом додавання бібліотек в наш код, який через власні методи і функції додає інформацію до викликів методів і функцій нашого коду
manual instrumentation: можемо додавати власні custom spans та атрибути в коді для бізнес-логіки, яку auto-instrumentation не бачить
наприклад, створювати span на обробку одного елементу в batch job, або атрибут order.total_items в SQL-виклику на span обробки замовлення
Як правило, починають з auto-instrumentation (щоб одразу отримати базову картину), а потім додають manual instrumentation поступово – там, де не вистачає контексту для дебагу конкретних проблем.
VictoriaTraces побудована на VictoriaLogs: вона отримує дані від OTel Collector у вигляді JSON в форматі OTLP та записує їх у власному форматі, трансформуючи імена полів.
Проект поки в статусі This project is currently a work in progress, тому зміни можливі – але вже цілком робочий.
Як і VictoriaLogs, VictoriaTraces формує stream fields, які використовують для оптимізації збереження даних та пошуку логів чи трейсів.
В результаті кожний записаний trace span зберігається як частина конкретного stream – аналогічно до того, як кожен log record у VictoriaLogs – це частина якогось одного конкретного log stream.
У VictoriaTraces для поля stream використовується атрибут service.name, і кожне унікальне значення в stream field впливає на те, скільки даних буде сформоване в VictoriaTraces storage та IndexDB, яка використовується для пошуку даних коли ми робимо sum by (label_name).
Як і VictoriaMetrics та VictoriaLogs, у VictoriaTraces є власний VM UI, в якому з LogsQL можемо виконувати пошук трейсів:
Хоча для відображення дерева трейсів краще використовувати Grafana – далі зробимо.
Також див. документацію VictoriaTraces по Monitoring – можемо збирати метрики та Retention – трейси, як і логи та метрики, теж зберігаються на диску, тому треба мати на увазі зайняте місце.
І дуже смачна можливість – створювати власні метрики з traces, зробимо в цьому пості далі.
Запуск VictoriaTraces в Kubernetes
Як і у VictoriaLogs, VictoriaTraces є single instance та cluster mode для High Availability – але в моєму випадку single isntance вистачає з головою, тому поки будемо використовувати його.
$ helm repo add vm https://victoriametrics.github.io/helm-charts/
$ helm repo update
Знаходимо останню доступну версію чарту:
$ helm search repo vm/victoria-traces-single
NAME                            CHART VERSION   APP VERSION     DESCRIPTION
vm/victoria-traces-single       0.0.7           v0.8.0          The VictoriaTraces single Helm chart deploys Vi...
Пишемо values.yaml, дефолтні значення є в репозиторії чарту, наприклад:
Я тут задав тип деплою з Deployment замість StatefulSet та додав Ingress через AWS ALB.
В persistentVolume створюємо диск, в retentionPeriod міняємо дефолтне значення 7 днів на місяць.
Деплоїмо, перевіряємо:
$ kk get deploy atlas-victoriametrics-vt-single-server
NAME                                     READY   UP-TO-DATE   AVAILABLE   AGE
atlas-victoriametrics-vt-single-server   1/1     1            1           44h
Перевіряємо Kubernetes Service:
$ kk get svc atlas-victoriametrics-vt-single-server
NAME                                     TYPE        CLUSTER-IP   EXTERNAL-IP   PORT(S)     AGE
atlas-victoriametrics-vt-single-server   ClusterIP   None         <none>        10428/TCP   2d20h
VictoriaTraces приймає OTLP/HTTP на endpoint /insert/opentelemetry/v1/traces.
Можемо з curl пушнути трейс для тесту – відкриваємо порт:
$ kk port-forward svc/atlas-victoriametrics-vt-single-server 10428
Відправляємо JSON з полями, які потім буде створювати наш OTel SDK:
І, власне, VictoriaTraces готова до роботи. Залишилось додати instrumentation в наш код – детальніше в наступній частині, тут просто для прикладу як воно взагалі може виглядати – тут auto instrumentation для FastAPI та asyncpg:
import os
from fastapi import FastAPI, HTTPException
from contextlib import asynccontextmanager
import asyncpg

from opentelemetry.instrumentation.fastapi import FastAPIInstrumentor
from opentelemetry.instrumentation.asyncpg import AsyncPGInstrumentor

from opentelemetry import trace
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import ConsoleSpanExporter, SimpleSpanProcessor, BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter


pool = None


@asynccontextmanager
async def lifespan(app: FastAPI):
    global pool
    pool = await asyncpg.create_pool(
        host=os.getenv("DB_HOST", "postgres-test"),
        port=int(os.getenv("DB_PORT", "5432")),
        user=os.getenv("DB_USER", "postgres"),
        password=os.getenv("DB_PASSWORD", "testpass"),
        database=os.getenv("DB_NAME", "demo"),
        min_size=2,
        max_size=10,
    )
    yield
    await pool.close()


# Set up OTel tracer provider
provider = TracerProvider()

# Console exporter (for local debugging)
provider.add_span_processor(SimpleSpanProcessor(ConsoleSpanExporter()))
# OTLP exporter to VictoriaTraces
provider.add_span_processor(BatchSpanProcessor(OTLPSpanExporter()))

trace.set_tracer_provider(provider)

app = FastAPI(title="Orders API", lifespan=lifespan)

FastAPIInstrumentor.instrument_app(app)
AsyncPGInstrumentor().instrument()

@app.get("/healthz")
async def healthz():
    return {"status": "ok"}


@app.get("/api/orders")
async def list_orders():
    rows = await pool.fetch("SELECT * FROM orders ORDER BY id")
    return [dict(r) for r in rows]


@app.get("/api/orders/{order_id}")
async def get_order(order_id: int):
    row = await pool.fetchrow("SELECT * FROM orders WHERE id = $1", order_id)
    if not row:
        raise HTTPException(status_code=404, detail="Order not found")
    return dict(row)


@app.get("/api/orders/by-customer/{name}")
async def orders_by_customer(name: str):
    # catch currently processing span
    current_span = trace.get_current_span()
    # add attribute to the current span: customer name
    current_span.set_attribute("customer.name", name)
    # fetch orders from the database
    rows = await pool.fetch(
        "SELECT * FROM orders WHERE customer_name = $1 ORDER BY id", name
    )
    # add attribute to the current span: number of orders fetched
    current_span.set_attribute("customer.orders_count", len(rows))
    return [dict(r) for r in rows]
VMAlert та Recording Rules з VictoriaTraces
Цікава фішка – можемо мати Recording Rules, в яких буде використовуватись VictoriaTraces – див. Alerting with traces.
Логіка та сама, як і для Recording Rules і метрик з логів у VictoriaLogs: описуємо правило з type="vlogs" – vmalert генерить метрику, а потім цю метрику можемо використати в алертах чи Grafana.
Єдиний нюанс тут – якщо вже є інстанс vmalert для логів, то треба робити другий інстанс – бо в Recording Rules тип однаковий (vlogs), і для самого VMAlert треба вказувати інший datasource.url.
Тут отримуємо всі spans з resource_attr:service.name="kraken-prod", вибираємо тільки ті, у яких присутній span_attr:http.route і рахуємо 95 percentile по полю duration:
Описуємо сам VMRule, в labels задаємо app="vmalert-traces" – по ньому ruleSelector буде вибирати тільки цей VMRule:
$ kk get vmalert
NAME             STATUS        REPLICACOUNT   AGE
vm-k8s-stack     operational   1              343d
vmalert-traces   operational                  42m
Тут vm-k8s-stack – це дефолтний vmalert з чарту victoria-metrics-k8s-stack – він займається алертами і має Recording Rules для логів (потім, мабуть, винесу окремими інстансами – один для алертів, один для Recording Rules з логів, один для VictoriaTraces).
І, відповідно, маємо новий Kubernetes Pod:
$ kk get pod | grep vmalert
vmalert-vm-k8s-stack-f6cdd77d9-mcnks                              2/2     Running     0               3d23h
vmalert-vmalert-traces-b8f77656c-jqzbp                            2/2     Running     0               4m29s
Для якого створена власна ConfigMap:
$ kk get pod vmalert-vmalert-traces-b8f77656c-jqzbp -o yaml | yq '.spec.volumes'
...
  {
    "configMap": {
      "defaultMode": 420,
      "name": "vm-vmalert-traces-rulefiles-0"
    },
    "name": "vm-vmalert-traces-rulefiles-0"
  },
...
В якій містяться правила з VMRule recording-rules-vmalert-traces:
$ kk describe cm vm-vmalert-traces-rulefiles-0
Name:         vm-vmalert-traces-rulefiles-0
...
Data
====
ops-monitoring-ns-recording-rules-vmalert-traces.yaml:
----
groups:
- name: Traces.VictoriaTraces.Logs.rules
  interval: 5m
  rules:
  - record: vmtraces:kraken:http:request_duration:p95
    expr: |
      {resource_attr:service.name=~"kraken-.*"} "span_attr:http.route":!""
      | stats by ("resource_attr:service.name", "span_attr:http.route", "span_attr:http.status_code") quantile(0.95, duration) p95_duration
Деплоїмо і за хвилину маємо нові метрики в VictoriaMetrics:
VictoriaTraces та Grafana
Аби зручно працювати в трейсами – додамо Grafana data source.
Для VictoriaTraces поки використовується дефолтний Jaeger, пізніше, думаю, створять власний плагін – для VictoriaMetrics спочатку теж використовувався звичайний Prometheus plugin, для VictoriaLogs був Loki plugin, потім команда вже додала свої.
Сервіс ми вже знаходили:
$ kk get svc | grep vt
atlas-victoriametrics-vt-single-server                   ClusterIP   None             <none>        10428/TCP                    24h
Перевіряємо Jaeger плагін:
Додаємо новий data source:
Задаємо URL як http://atlas-victoriametrics-vt-single-server:10428/select/jaeger:
Можна включити Trace to Logs and Metrics – тоді в Grafana Explore по trace_id будуть генеруватись лінки на повязані метрики та логи:
Зберігаємо, перевіряємо:
Переходимо в Explore і шукаємо по Trace ID:
VictoriaLogs, Derived Fields та VictoriaTraces
VictoriaLogs plugin підтримує створення derived fields: можна прямо з логів VictoriaLogs створювати лінк на VictoriaTraces.
Налаштовується в Grafana Connections > VictoriaLogs: вказуємо ім’я, вибираємо тип – в моєму випадку логи в JSON, тому через “Regex in log line”:
"trace_id":\s*"([a-f0-9]{32})"
В поле URL використовуємо ${__value.raw}– сюди буде підставлено значення trace_id.
В Example log message можна перевірити чи вірно працює regex:
Після чого відкриваємо лог з полем trace_id – справа з’явиться блок “Links”:
Який відкриє посилання на цей трейс:
Власне, на цьому сьогодні все.
В наступному пості вже подивимось як використовувати OpenTelemetry instrumentation і з Python app створювати трейси.
Сьогодні поговоримо про те, як запустити OpenTelemetry в Kubernetes та інтегрувати його з VictoriaMetrics stack – VictoriaMetrics для метрик, VictoriaLogs для логів, та VictoriaTraces для трейсів.
Взагалі-то цей пост не планувався взагалі, а коли все ж з’явилась його чорнетка – то він мав бути третім в серії, але врешті-решт вирішив зробити його першим.
Вже після нього допишу два інших поста – перший про Observability та tracing з VictoriaTraces, другий – по OpenTelemetry instrumentation в Python та запису трейсів до VictoriaTraces, а потім – про LLM Observability та моніторингу.
Власне, саме так OpenTelemetry на моєму поточному проекті і з’явився – захотіли ми подивитись детальніше по тому, що у нас по роботі з різними LLM-провайдерами, а там все “заточено” під OpenTelemetry, бо формат Prometheus metrics для цього не підходить.
Тому першим ділом додав VictoriaTraces та запис трейсів в з нашого Backend API, потім подивився на це всі діло, подумав, що мені замало контексту – і вирішив додати повний OpenTelemetry стек.
Головна суть observability – в контексті, бо context – це, surprise, не тільки про AI/LLM, а і про моніторинг та Observability.
Про Monitoring vs Observability будемо говорити в наступному пості (який мав бути першим), а сьогодні подивимось як запустити OpenTelemetry в Kubernetes.
Але просто мати метрики, логи та трейси мало – бо всі наші three pillars повинні мати якісь загальні ознаки, загальні дані, які дозволять робити “наскрізний observability” – тобто, мати можливість в єдиному контексті дослідити і метрики EC2, і метрики AWS Application Load Balancer, і конкретні Kubernetes Pods самого Backend API та, врешті решт – до конкретних викликів функцій, бізнес-логіки, яка виконується в цьому Pod у відповідь на реквест, який прийшов з AWS ALB від конкретного юзеру – тобто, побудувати observability pipeline.
А для того, аби всі дані мали цей загальний контекст – вони повинні мати якісь загальні риси, ознаки, за якими ми можемо всі отримані – тобто labels.
Проте при використанні “дефолтного” Prometheus-стеку ми маємо купу різних експортерів для метрик, окремі експортери для логів, ще і на додачу трейси в OTel-форматі – і кожен пише лейбли на свій лад. Тому, аби якось це все об’єднати в Grafana dashboards або алертах доводиться гемороїтись зі всякими label_replace.
Тут з метрики node_cpu_seconds_total береться значення лейбли instance типу 10.0.50.18 і створюється нове значення виду ip-10-0-50-18.ec2.internal, яке потім використовується в Grafana dashboards для фільтрів – бо якась інша метрика віддає ім’я хоста в такому вигляді, а метрика від node_exporter не має дефолтної лейбли у вигляді node_name="ip-10-0-50-18.ec2.internal".
Тому можна піти іншим шляхом – замінити те, як ми ці метрики отримуємо: замість того, щоб мати 10 різних експортерів для метрик – node_exporter для EC2, YACE exporter для AWS CloudWatch, окремого експортеру k8s-event-logger для експорту Kubernetes Events в логи, замість окремого AWS ALB Logs collector із S3 – ми можемо мати єдину систему, яка все це робить сама і, головне – сама додає загальний загальні лейбли до всіх signals – metrics, logs, traces.
Плюси та мінуси OpenTelemetry
Звісно, не все так просто: OpenTelemetry Collector трохи складніший в налаштуванні, споживає більше ресурсів, потребує додаткового моніторингу.
Власне, це цілком очікувано, бо якщо система “з коробки” дає більше можливостей – то і її конфігурація буде трохи складнішою, ніж для якогось одного Prometheus Node Exporter.
Те саме і по ресурсам – коли експортер займається збором і метрик і логів – то він буде споживати більше ресурсів, ніж один експортер, який “заточений” тільки під одну задачу: вже те, що OTel має захист від OOMKiller “з коробки” про щось говорить.
Втім, якщо порахувати споживання CPU/RAM всіма експортерами Prometheus-формату і порівняти з одним Kubernetes Pod для OpenTelemetry Collector – то ще питання, що буде легше.
Крім того – формат OTel для метрик за розміром більший, ніж Prometheus-метрики – бо сам формат в собі містить більше даних.
І останній нюанс, який зараз приходить в голову – це те, що 95% всяких алертів та Grafana dahsboards заточені саме під метрики в Prometheus-форматі та від Prometheus-експортерів на кшталт node_exporter та cAdvisor.
Тому якщо впроваджувати OTel в якості основної системи для збору даних – то треба мати на увазі, що треба буде оновлювати і всі пов’язані ресурси.
Втім, конкретно в моєму випадку – ми ще маленький стартап, а основні Grafana dashboards я все одно роблю сам руками, тому з LLM задачка це все оновити вирішується відносно швидко.
Отже, спробую, запущу поки що паралельно з існуючим Prometheus-like стеком експортерів та логів і подивлюсь, що з цього вийде.
VictoriaTraces і трейси у нас теж вже є, але про це будемо говорити окремо.
VictoriaMetrics та мій поточний стек моніторингу
У нас на проекті все працює в AWS на Elastic Kubernetes Service – Backend API та інші сервіси проекту, сам VictoriaMetrics стек моніторингу, плюс різні сервіси самого AWS – RDS, CloudFront, DynamoDB etc.
Що залишиться без змін – це наші “storages”: VictoriaMetrics для метрик, VictoriaLogs – для логів, VictoriaTraces – для трейсів.
Що зміниться – це те, як ми ці дані отримуємо: замість пачки Prometheus exporters та VMAgent, який до них ходить і збирає метрики – у нас буде окремий сервіс OTel Gateway, який отримує дані від OTel Collector. А OTel Collector замінить весь зоопарк Prometheus Exporters та Log collectors.
Окремо від цієї інфраструктури є багато інтеграцій з AI-провайдерами – Anthropic, OpenAI – але їхній моніторинг це вже зовсім окрема тема, про які буду (сподіваюсь) писати далі.
OpenTelemetry – загальна архітектура та компоненти
Для збору даних – метрик, логів та трейсів – у OpenTelemetry є власний OpenTelemetry Collector, який може відігравати різні ролі.
Власне, це один і той самий binary-файл, поведінка якого залежить від того, що ми йому передаємо в налаштуваннях:
роль AWS Collector: збирає метрики з CloudWatch та/або логи з AWS ALB через S3 та/або VPC Flow Log
роль OpenTelemetry Gateway: агенти (OTel Collectors) пушать свої дані до Gateway, а Gateway вже передає їх до конкретних бекендів – VictoriaMetrics, VictoriaLogs, VictoriaTraces
Схематично це може виглядати якось так:
Єдиний момент перед тим, як продовжити: я називаю OTel Collectors і як “collector“, і як “agent“, але назва суті не міняє – це просто роль, яку сервіс виконує.
service: об’єднує і активує описані конфіги – recievers, processors, etc
OpenTelemetry Pipelines
Всі отримані сигнали проходять через pipeline: тобто receiver – отримав сигнал, processor його обробив, exporter – кудись відправив.
Для кожного типу сигналів – метрик, логів та трейсів – у нас будуть власні пайплайни – бо дані хоч і пов’язані, але оброблюються по різному.
Кожен пайплайн може мати власний ідентифікатор – просто ім’я, аби простіше було читати конфіг, наприклад:
connectors:
  spanmetrics:
    # config...

service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [otlphttp/vtraces, spanmetrics]  # spanmetrics here is an exporter

    metrics/from_traces:
      receivers: [spanmetrics]                    # the same spanmetrics here is an receiver
      exporters: [otlphttp/vmetrics]
Тепер можемо починати писати власні конфіги та запускати колектори.
OpenTelemetry: запуск в Kubernetes
Є кілька варіантів запусту стека – “голими” контейнерами, Helm chart, або OpenTelemetry Operator, див. Install the Collector.
Для VictoriaMetrics я користуюсь Helm chart victoria-metrics-k8s-stack, який встановлює VictoriaMetrics Operator, VMAgent, VMAlert, Alertmanager, Grafana, а всі налаштування виконуються з VictoriaMetrics CRD resources.
Для OpenTelemetry поки зроблю просто з Helm chart – бо простіше буде розібратись з основними компонентами і не витрачати час на документацію оператора та його CRD.
А вже коли це все діло піде у production – можна буде замінити на OpenTelemetry Operator.
Робити будемо у вигляді трьох окремих компонентів:
OTel Gateway: отримує дані від Kubernetes API, Kubernetes та AWS Collectors, оброблює їх, передає до бекендів – VictoriaMetrics, VictoriaLogs, VictoriaTraces
Kubernetes Agent: запускається на кожній Kubernetes WorkerNode, збирає дані від kubelet та логи Pods
AWS Agent: збирає дані від AWS – метрики, логи
Почнемо саме з OTel Gateway, бо всі інші компоненти будуть слати дані саме через нього, саме він буде виконувати всі операції, і саме він буде відправляти дані до VictoriaMetrics stack.
$ helm search repo open-telemetry/opentelemetry-collector
NAME                                    CHART VERSION   APP VERSION     DESCRIPTION
open-telemetry/opentelemetry-collector  0.155.0         0.151.0         OpenTelemetry Collector Helm chart for Kubernetes
Всі компоненти – OTel Gateway, Kubernetes Agent, AWS Agent – будуть встановлюватись з нього, але кожний з власними values.
Запуск OpenTelemetry Gateway
Готуємо файл otel-gateway-values.yaml – це будуть values для нашого OTel Gateway:
# OTel Collector - Gateway role (Deployment)
#
# Responsibilities at this phase:
#   - Accept OTLP from future Agents (DaemonSet)
#   - Collect cluster-level metrics via k8s_cluster receiver
#   - Collect K8s events as logs via k8sobjects receiver
#   - Enrich all signals with K8s metadata (k8sattributes processor)
#   - Export metrics to VictoriaMetrics, logs to VictoriaLogs
#
# Traces pipeline is intentionally not enabled yet - that's Phase 2

# docs: https://opentelemetry.io/docs/collector/architecture/

mode: deployment

replicaCount: 2

# contrib image has all the receivers/processors/exporters we need
image:
  repository: otel/opentelemetry-collector-contrib

resources:
  limits:
    cpu: 1000m
    memory: 2Gi
  requests:
    cpu: 200m
    memory: 512Mi

# RBAC for k8sattributes (pod metadata lookup) and k8s_cluster (cluster state).
# Full list of required permissions:
# https://github.com/open-telemetry/opentelemetry-collector-contrib/tree/main/receiver/k8sclusterreceiver
clusterRole:
  create: true
  rules:
    - apiGroups: [""]
      resources:
        - pods
        - namespaces
        - nodes
        - nodes/stats
        - nodes/proxy
        - events
        - services
        - resourcequotas
        - replicationcontrollers
        - replicationcontrollers/status
      verbs: ["get", "list", "watch"]
    - apiGroups: ["apps"]
      resources: ["replicasets", "deployments", "statefulsets", "daemonsets"]
      verbs: ["get", "list", "watch"]
    - apiGroups: ["extensions"]
      resources: ["replicasets"]
      verbs: ["get", "list", "watch"]
    - apiGroups: ["batch"]
      resources: ["jobs", "cronjobs"]
      verbs: ["get", "list", "watch"]
    - apiGroups: ["autoscaling"]
      resources: ["horizontalpodautoscalers"]
      verbs: ["get", "list", "watch"]
    - apiGroups: ["events.k8s.io"]
      resources: ["events"]
      verbs: ["get", "list", "watch"]

# Self-monitoring port
ports:
  metrics:
    enabled: true
    containerPort: 8888
    servicePort: 8888
    protocol: TCP

service:
  type: ClusterIP

config:
  receivers:
    # PUSH receiver
    # Accepts data from Agents and from apps
    # OTel TracerProvider() for the Backend API will send traces to this receiver
    otlp:
      protocols:
        grpc:
          endpoint: 0.0.0.0:4317
          # Agent batches of logs may exceed default 4 MiB gRPC limit
          max_recv_msg_size_mib: 16
        http:
          endpoint: 0.0.0.0:4318

    # PULL receiver
    # Will go to the Kubernetes API to get the cluster-level state
    # Runs only on Gateway (one place per cluster)
    # uses GET /api/v1/nodes, GET /apis/apps/v1/deployments etc.
    # converts responses to metircs like k8s.deployment.available, k8s.node.condition_ready, k8s.hpa.current_replicas
    # returns them to a corresponding pipeline
    k8s_cluster:
      collection_interval: 30s
      node_conditions_to_report: [Ready, MemoryPressure, DiskPressure, PIDPressure]
      allocatable_types_to_report: [cpu, memory, ephemeral-storage]

    # PULL receiver
    # Will go to the Kubernetes API, but uses `watch` mode
    # uses the 'events.k8s.io/v1/events' endpoint to receive event stream in real time
    # converts Kubernetes Events to Log records
    # returns them to the logs pipeline
    k8sobjects:
      objects:
        - name: events
          mode: watch
          group: events.k8s.io

  processors:
    # Memory protection against traffic spikes to avoid OOM kills
    memory_limiter:
      check_interval: 1s
      limit_percentage: 80
      spike_limit_percentage: 25

    # Enrich every signal with K8s pod metadata - this is what unifies labels
    # across metrics, logs and traces
    # docs: https://opentelemetry.io/docs/platforms/kubernetes/collector/components/#kubernetes-attributes-processor
    k8sattributes:
      auth_type: serviceAccount
      passthrough: false
      extract:
        # data taken from the Kubernetes API - fields from the Pod object to be added as attributes
        # i.e. a Kubernetes Namespace 'dev-backend-api-ns' for a Pod will be set as k8s.namespace.name="dev-backend-api-ns"
        # https://github.com/open-telemetry/opentelemetry-collector-contrib/tree/main/processor/k8sattributesprocessor#configuration
        metadata:
          - k8s.namespace.name
          - k8s.pod.name
          - k8s.pod.uid
          - k8s.pod.start_time
          - k8s.deployment.name
          - k8s.statefulset.name
          - k8s.daemonset.name
          - k8s.cronjob.name
          - k8s.job.name
          - k8s.node.name
        # add custom labels from the Pod object
        # i.e. a Pod with label 'app.kubernetes.io/component=backend' will be set as app.label.component="backend"
        labels:
          - tag_name: app.label.component
            key: app.kubernetes.io/component
            from: pod
          - tag_name: app.label.name
            key: app.kubernetes.io/name
            from: pod
      # pod_association processor is used to associate signals (metrics, logs, traces) with the correct Pod
      # e.g. when the Gateway receive a metric from a Pod, it need to know how to find that Pod in the Kubernetes API
      # for example, our Kubernetes Agent will send a metric from 'kubeletstats' for a container
      # but this metrics will not have a corresponding 'k8s.deployment.name'
      # so here, k8sattributes proecessor will ask the Kubernetes API to get additional metadata and set it as attributes
      pod_association:
        - sources:
            - from: resource_attribute
              name: k8s.pod.ip
        - sources:
            - from: resource_attribute
              name: k8s.pod.uid
        - sources:
            - from: connection

    # similar to the k8sattributes.extract.labels above, but for the resource attributes to all signals
    # sets hard-coded values
    resource:
      attributes:
        # action may be set as:
        # - insert: add only if not exists
        # - update: update if exists
        # - upsert: insert if not exists, update if exists
        # - delete: delete if exists
        - key: k8s.cluster.name
          value: eks-ops-1-33
          action: upsert
        - key: cloud.provider
          value: aws
          action: upsert

    # Batch records for efficient export
    # collects data to its buffer and sends it to the exporter in batches
    # docs: https://github.com/open-telemetry/opentelemetry-collector-contrib/tree/main/processor/batchprocessor
    batch:
      send_batch_size: 8192
      timeout: 10s

  # Where to send the data to - in our case, to VictoriaMetrics and VictoriaLogs
  # docs: https://docs.victoriametrics.com/opentelemetry/
  exporters:
    # VictoriaMetrics - OTLP endpoint
    # docs: https://docs.victoriametrics.com/victoriametrics/data-ingestion/opentelemetry-collector/
    # the '/v1/metrics' part will be added by the exporter itself
    otlphttp/vmetrics:
      endpoint: http://vmsingle-vm-k8s-stack.ops-monitoring-ns.svc.cluster.local:8428/opentelemetry
      tls:
        insecure: true

    # VictoriaLogs - OTLP endpoint
    # docs: https://docs.victoriametrics.com/victorialogs/data-ingestion/opentelemetry/
    # the '/v1/logs' part will be added by the exporter itself
    otlphttp/vlogs:
      endpoint: http://atlas-victoriametrics-victoria-logs-single-server.ops-monitoring-ns.svc.cluster.local:9428/insert/opentelemetry
      tls:
        insecure: true

    # Debug exporter - for troubleshooting, can be added to any pipeline temporarily
    debug:
      verbosity: basic

  # Combine everything into a single service definition
  service:
    # Pipelines operate on three telemetry data types: traces, metrics, and logs.
    # Each pipeline has its own set of receivers, processors and exporters.
    # docs: https://opentelemetry.io/docs/collector/architecture/#pipelines
    pipelines:
      metrics:
        # Reference receivers by their names from the config.receivers section above
        receivers: [otlp, k8s_cluster]
        # Reference processors by their names from the config.processors section above
        # IMPORTANT NOTE: order matters - processors run in the order listed here
        processors: [memory_limiter, k8sattributes, resource, batch]
        # Reference exporters by their names from the config.exporters section above
        exporters: [otlphttp/vmetrics]

      logs:
        receivers: [otlp, k8sobjects]
        processors: [memory_limiter, k8sattributes, resource, batch]
        exporters: [otlphttp/vlogs, debug]

    telemetry:
      metrics:
        readers:
          - pull:
              exporter:
                prometheus:
                  host: 0.0.0.0
                  port: 8888
В принципі, все описав в коментарях – але давайте коротко про те, що ми тут маємо:
mode="deployment": Gateway створюємо у вигляді Kubernetes Deployment з двома Pods
для Kubernetes Agent будемо робити DaemonSet, бо він має працювати на кожній WorkerNode
receivers: описуємо вхідні дані – можуть бути PULL (самі звертаються до зовнішніх API), або PUSH (в них пушать агенти/колектори)
otlp: ендпоінти для Kubernetes та AWS Agents
k8s_cluster: звертається до Kubernetes API, отримує інформацію по Nodes, Pods, Events
k8sobjects.objects="events": від Kubernetes API постійно отримує Kubernetes Events, записує у вигляді логів
processors:
k8sattributes: додає атрибути до кожної метрики чи лога (namespace, deployment name, etc)
$ kubectl -n ops-monitoring-ns get pod -l app.kubernetes.io/instance=otel-gateway
NAME                                                    READY   STATUS    RESTARTS   AGE
otel-gateway-opentelemetry-collector-57b74ffd98-4pqhw   1/1     Running   0          68s
otel-gateway-opentelemetry-collector-57b74ffd98-td6hr   1/1     Running   0          68s
Kubernetes Service – його будуть використовувати Agents:
$ kubectl -n ops-monitoring-ns get svc -l app.kubernetes.io/instance=otel-gateway
NAME                                   TYPE        CLUSTER-IP       EXTERNAL-IP   PORT(S)                                                            AGE
otel-gateway-opentelemetry-collector   ClusterIP   172.20.204.222   <none>        6831/UDP,14250/TCP,14268/TCP,8888/TCP,4317/TCP,4318/TCP,9411/TCP   90s
Перевірка Metrics
І за хвилину можемо вже перевірити метрики по {k8s.cluster.name="eks-ops-1-33"}:
Де маємо метрику k8s.container.cpu_limit – це від k8s_cluster receiver, який сходив до /api/v1/pods в Kubernetes APIs і прочитав spec.containers[].resources.limits.cpu.
The Cardinality Issue
Тепер важливий момент – в лейблах бачимо багато різних ID, наприклад:
Кожен раз, коли Kubernetes Pod перестворюється – для нього генерується нове значення в k8s.pod.uid.
Детально чому і як це впливає на VictoriaMetrics storage та навантаження описував в пості VictoriaMetrics: Churn Rate, High cardinality, метрики та IndexDB, але якщо коротко – кожне унікальне значення кожної лейбли збільшує і зайняте місце на диску, і розмір індексної бази VictoriaMetrics, та, відповідно, впливає на споживання CPU/RAM і швидкість пошуку.
Аби запобігти цьому – можемо додати ще один processor, який буде видаляти такі лейбли.
Порядок додавання в config.processors неважливий – він важливий в пайплайні, але логічно додати біля блоку resource:
...
  processors:
    ...
    resource:
      attributes:
        - key: k8s.cluster.name
          value: eks-ops-1-33
          action: upsert
        - key: cloud.provider
          value: aws
          action: upsert

    # Drop high-cardinality resource attributes from metrics only
    # These change on every pod recreation and cause series explosion in VictoriaMetrics.
    # Logs and traces keep them - useful for debugging specific pod instances.
    resource/drop_volatile_labels:
      attributes:
        - key: k8s.pod.uid
          action: delete
        - key: container.id
          action: delete
        - key: k8s.pod.start_time
          action: delete
...
Інший варіант – видаляти з -search.maxStalenessInterval=4h самої VictoriaMetrics, див. List of command-line flags.
При цьому пам’ятаємо, що у нас є два різних типи атрибутів, і, відповідно, це будуть різні processors:
record-level attributes: атрибути конкретного запису (i.e. container CPU usage)
resource-level attributes: атрибути джерела – додаються до всіх signals, які передаються до бекендів
Перевірити які саме атрибути треба модифікувати можна в документації конкретного processor, наприклад для k8sattributes processor:
The processor automatically discovers k8s resources (pods), extracts metadata from them and adds the extracted metadata to the relevant spans, metrics and logs as resource attributes.
Або в OTel specification, наприклад для Pod документація має URI /resource/k8s/#pod.
Додаємо новий processors в pipeline для merics – після resource, але перед batch:
Чому саме така позиція в pipeline – тому всі ресурси в pipeline виконується в тому порядку, в якому вони описані, а обробка resource/drop_volatile_labels має йти:
після k8sattributes – бо саме він додає k8s.pod.uid, треба його викидати після того, як він з’явився
після resource – щоб resource processor вже встиг проставити свої лейбли
перед batch – щоб batch групував вже очищені дані
Апдейтимо деплой, перевіряємо:
І лейблів з .id більше нема
Тепер у нас є робочий OTel Gateway, в якому ми:
готові приймати дані майбутніх Agents та наших сервісів типу Backend API (порти 4317/4318)
збираємо cluster-level метрики (k8s_cluster)
збираємо K8s events як логи (k8sobjects)
доповнюємо k8s-метаданими (k8sattributes)
додаємо до всіх даних власні лейбли (k8s.cluster.name, cloud.provider)
І трохи про те, що зміниться в Grafana та алертах.
Наприклад, є такий запит в Prometheus-форматі:
sum(container_memory_working_set_bytes{namespace="$namespace", pod="$pod", image!="", container!="POD", container!=""}) by (pod)
В OpenTelemetry форматі він буде виглядати так:
sum({__name__="container.memory.working_set", k8s.namespace.name="$namespace", k8s.pod.name="$pod"}) by (k8s.pod.name)
Результат на графіках – зверху старий, Prometheus, внизу – новий, OpenTelemetry:
Для VictoriaMetrics можна задати opentelemetry.usePrometheusNaming (див. List of command-line flags та Label sanitization) – тоді метрики будуть створюватись в форматі Prometheus з “_” замість “.“.
Але для VictoriaLogs та VictoriaTraces такої опції не бачу – спитаю девелоперів, чи є там якісь адекватні варіанти це вирішити.
Загалом, налатування на Arch Linux не відрізняються від Debian – але кожного разу починаю збирати потрібні конфіги по цьому блогу і іншим моїм хостам – тому опишу окремо, що було в одному місці, плюс тут є трохи нюансів з DNS та NteworkManager.
Власне, що треба буде зробити – встановити WireGuard, створити ключі та файл конфігу, на MikroTik створити новий Peer.
Установка WireGuard
Встановлюємо пакет wireguard-tools – в ньому йдуть всі утиліти + systemd-unit для запуску WireGuard:
$ sudo pacman -S wireguard-tools
Генерація ключів
Створюємо каталог /etc/wireguard/, в ньому генеруємо приватний та публічний ключі:
# mkdir /etc/wireguard/
# cd /etc/wireguard/
# wg genkey | sudo tee /etc/wireguard/privatekey | wg pubkey | sudo tee /etc/wireguard/publickey
0ClB2Lf5uQmWK8Nz0XRofuVkvbQbSfrf3ioHbYOm9F4=
На приватний ключ задаємо права на читання тільки root:
# chmod 600 /etc/wireguard/privatekey
Створення конфігу для WireGuard
В директорії /etc/wireguard/ створюємо файл wg0.conf:
Можна підключатись – але можлива проблема з resolvconf та /etc/resolv.conf.
WireGuard та помилка “resolvconf: signature mismatch: /etc/resolv.conf”
На Arch Linux запускаємо підключення:
# systemctl start wg-quick@wg0
Job for [email protected] failed because the control process exited with error code.
See "systemctl status [email protected]" and "journalctl -xeu [email protected]" for details.
Перевіряємо статус:
# systemctl status [email protected]
× [email protected] - WireGuard via wg-quick(8) for wg0
     Loaded: loaded (/usr/lib/systemd/system/[email protected]; disabled; preset: disabled)
     Active: failed (Result: exit-code) since Fri 2026-05-08 08:57:47 EEST; 20s ago
...
May 08 08:57:47 setevoy-work wg-quick[1192596]: [#] wg addconf wg0 /dev/fd/63
May 08 08:57:47 setevoy-work wg-quick[1192596]: [#] ip -4 address add 10.100.0.10/32 dev wg0
May 08 08:57:47 setevoy-work wg-quick[1192596]: [#] ip link set mtu 1420 up dev wg0
May 08 08:57:47 setevoy-work wg-quick[1192644]: [#] resolvconf -a wg0 -m 0 -x
May 08 08:57:47 setevoy-work wg-quick[1192674]: resolvconf: signature mismatch: /etc/resolv.conf
May 08 08:57:47 setevoy-work wg-quick[1192674]: resolvconf: run `resolvconf -u` to update
May 08 08:57:47 setevoy-work wg-quick[1192596]: [#] ip link delete dev wg0
May 08 08:57:47 setevoy-work systemd[1]: [email protected]: Main process exited, code=exited, status=1/FAILURE
Проблема в тому, що в системі є і openresolv і NetworkManager з дефолтним dns=default – тобто NetworkManager пише /etc/resolv.conf напряму, без resolvconf.
При цьому openresolv тримає в файлі свій checksum для файлу /etc/resolv.conf, і коли NetworkManager перезаписує файл – контрольна сума не сходиться, через що resolvconf -a (який викликається wg-quick) падає з помилкою “signature mismatch“.
Option 1: PreUp та resolvconf -u (“грязний хак”)
Є “грязний хак” – додати до /etc/wireguard/wg0.conf опцію PreUp з запуском resolvconf -u:
Цей варіант теж працює, але якщо NetworkManager перезапише /etc/resolv.conf вже після підняття тунелю (наприклад, при reconnect Wi-Fi) – DNS з тунелю злетять.
Тому краще просто переключити NetworkManager на використання systemd-resolved, аби він взагалі не писав файл напряму /etc/resolv.conf.
Option 2: NetworkManager та systemd-resolved (правильний варіант)
Редагуємо конфіг /etc/NetworkManager/NetworkManager.conf і додаємо блок [main] з опцією dns – див. DNS management:
[main]
dns=systemd-resolved
Стартуємо systemd-resolved і перезапускаємо NetworkManager:
# resolvectl status
Global
           Protocols: +LLMNR +mDNS -DNSOverTLS DNSSEC=no/unsupported
    resolv.conf mode: foreign
  Current DNS Server: 10.100.0.1
         DNS Servers: 192.168.0.1 10.100.0.1
...
Або з ss -lntup | grep 127.0.0.53 – але я звик до netstat.
Option 3: чистий openresolv (just in case)
Альтернатива – задати dns=none в NetworkManager: тоді NM взагалі не чіпає /etc/resolv.conf і єдиним менеджером файлу стає openresolv: він об’єднує записи від wg-quick і підключень NetworkManager напряму в /etc/resolv.conf зі списком реальних DNS-серверів (192.168.0.1, 10.100.0.1, …).
При такому варіанті systemd-resolved взагалі не потрібен – запити на DNS resolution йдуть напряму через glibc: простіше конфігурація і менше сервісів – але втрачаємо плюшки systemd-resolved: кешування, split-DNS, DNSSEC.
Іноді на FreeBSD треба запустити якісь сервіси, які офіційно FreeBSD не підтримують, і власне, цей пост з’явився через те, що я встановлював Open WebUI на своєму NAS – і як раз Open WebUI простіше було зробити на Linux.
Тому підняв його у FreeBSD Linux jail, а для створення контейнеру взяв Bastille, яка спрощує менеджмент.
Про сам Open WebUI може допишу чорнетку, а Bastille вирішив винести окремим постом – бо зараз буду сетапити Hermes Agent (вже – див. Hermes Agent: запуск AI Agent у FreeBSD Jail з Bastille, і хочеться мати таку собі коротку інструкцію по тому, як працювати з FreeBSD jails використовуючи Bastille.
FreeBSD jails з’явились ще у 1999 році як розвиток “неповноцінної” системи chroot, яка не давала повної ізоляції. З jails з’явилась можливість відокремлення filesystem, мати окремий network stack, власні PIDs і так далі – власне все те, до чого ми звикли в Linux та його контейнерах.
Як раз на днях зустрів цікавий пост на цю тему, де серед іншого говориться і за історію контейнеризації – Your Container Is Not a Sandbox.
На відміну від контейнерів в Linux – FreeBSD jails це єдина частина ядра системи, тоді як Linux – це комбінація різних механізмів (namespaces, cgroups).
Правда, вона має і недоліки – бо це все одно залишається одне і там саме ядро FreeBSD, зато вона простіша – а тому безпечніша і простіша в роботі та дебагу.
Власне, Bastille – це розвиток системи jails, точніше – система для спрощення менеджменту контейнерів у FreeBSD, аби не писати jail.conf руками і мати простий CLI для управління (як Docker – це “обгортка” для Linux containers).
Не Bastille єдиною – є аналогічні рішення як-от iocage, ezjail, pot та інші.
Чому взяв Bastille – проект активно розвивається, є велике комьюніті, має зручний CLI та добре інтегрується з можливостями ZFS.
VNET (DHCP): Bastille створює інтерфейс з типом bridge і підключає jail через epair – кожен jail отримує власні MAC та IP адреси, і виглядає як окремий хост у мережі
Bridged VNET (own bridge): те саме, але bridge створюється вручну – використовується для кастомних або ізольованих мереж
Alias/Shared Interface: один інтерфейс хоста, IP-адреси для jail-ів додаються як alias фізичного інтерфейсу хоста – простий варіант, але без окремого network stack (тобто у всіх буде загальний фаервол самого хоста, роутинг тощо)
NAT/Loopback Interface: jail отримує IP у внутрішній мережі і ходить в “світ” через NAT хоста, для доступу ззовні до jail потрібен port forwarding
Inherit: jail використовує той самий IP і інтерфейс, що й хост, використовується рідко – зазвичай для специфічних кейсів, доступ розділяється по портах – незручно, не гнучко, не масштабується
Далі детальніше подивимось на три основних типи – VNET, Alias та NAT.
Bastille bootstrap
Запускаємо bastille bootstrap, аналог docker pull – скачати базовий архів з системою, яку передамо аргументом, та розархівувати його для подальшого використання.
Якщо робимо контейнер з FreeBSD, то версія системи в jail повинна бути =< версії хоста – перевіряємо її з freebsd-version:
Тепер у нас все готове для створення контейнерів – подивимось, як робити jails з FreeBSD та Linux та різними налаштуваннями мережі.
Створення jails
Якщо запускаємо у VirtualBox – включаємо Promiscuous Mode в Allow All:
Створення FreeBSD jails
Спочатку зробимо кілька контейнерів з FreeBSD і різними параметрами мережі – а потім запустимо jail з Linux.
Всі створені jail зберігаються в директорії /usr/local/bastille/jails/ – там для кожного контейнера буде директорія з його ім’ям та файлом jail.conf, який описує параметри цього контейнеру.
Network type VNET
Першим глянемо варіант з VNET – я ним користуюсь найбільше, бо зручно мати прямий доступ в контейнери, плюс повноцінна ізоляція на рівні мережі.
Аби задати тип нетворка VNET – до bastille create передаємо опцію --vnet (або коротка форма -V), потім ім’я jail, версію системи, IP-адресу та інтерфейс хоста для створення bridge.
Інтерфейс можна не передавати, якщо заданий bastille_network_gateway в /usr/local/etc/bastille/bastille.conf.
Замість передачі IP явно – можна вказати опцію DHCP або SYNCDHCP – тоді jail отримає адресу від роутера:
[root@test-free-15-bastille ~]# bastille list
 JID  Name            Boot  Prio  State  Type   IP Address     Published Ports  Release       Tags
 2    testjailVnetIp  on    99    Up     thin   192.168.0.205  -                15.0-RELEASE  -
Deep dive: VNET networking
Трохи детально згадував як працює нетворкінг, в принципі цю частину можна пропустити, але якщо цікаво – то подивимось, як пакет з ноутбука в локальній мережі з FreeBSD-хостом попадає всередину jail.
Тут в прикладі маємо всі хости в одній мережі 192.168.0.0/24:
Де бачимо, що у vnet0 той самий MAC 0e:20:99:d5:55:b2 як і на хості у інтерфейсів e0a_bastille1 та em0.
Data flow та ARP table
І тепер можна прослідкувати процес передачі даних до jail:
з ноутбука виконуємо ssh 192.168.0.205 – на jail IP
ноутбук виконує broadcast ARP-запит в мережу 192.168.0.0/24 – “хто має 192.168.0.205?“
фізичний інтерфейс em0 на хості отримує цей запит, ядро визначає, що em0 – це member bridge-інтерфейсу em0bridge на port 1, і передає дані на em0bridge
em0bridge передає його до своїх members, на інші ports – в нашому випадку до e0a_bastille1 на port 5
e0a_bastille1 – це “вхідний” socket, а e0b_bastille1 – його “вихід” всередині jail
для аналогії можна згадати socketpair(), який обєднує два socket, кожен з власним file descritor – на “вході” та на “виході”: все, що записується на “вхідний” сокет – попадає на другий сокет зв’язаної пари
інтерфейс vnet0 в jail отримує цей запит, відповідає ноутбуку “це мій IP” та повертає свій MAC
ноутбук записує цей MAC в свою ARP table
Подивитись ARP на Arch Linux можемо з ip neigh show:
[setevoy@setevoy-work ~]  $ ip neigh show
192.168.0.205 dev enp0s13f0u3u4c2 lladdr 0e:20:99:d5:55:b2 REACHABLE
...
src MAC: MAC інтерфейсу – в моєму випадку enp0s13f0u3u4c2
dst MAC: 0e:20:99:d5:55:b2 (MAC FreeBSD em0 та jail e0b_bastille1)
OSI layer 3 (IP packet) headers:
src IP: IP хоста з Arch Linux
dst IP: 192.168.0.205 – jail IP
А процес доставки даних в jail виглядає так:
ноутбук формує Ethernet frame з dst MAC 0e:20:99:d5:55:b2
фрейм через роутер/свіч домашньої мережі попадає на em0 хоста FreeBSD
ядро FreeBSD “бачить”, що em0 – це member групи em0bridge та передає дані на e0a_bastille1
пакет “входить” до e0a_bastille1 – і “виходить” у e0b_bastille1 – інтерфейсі vnet0 всередині нашого jail
ядро в jail розпаковує Ethernet фрейм, перевіряє dst IP (192.168.0.205) та dst Port (22), бачить, що це його IP, а на порту 22 є демон SSH – і передає IP пакет до SSH
Начебто вірно описав.
Тепер, як трохи розібрались з мережею – можна створювати контейнери далі.
[root@test-free-15-bastille ~]# ifconfig
em0: flags=1008943<UP,BROADCAST,RUNNING,PROMISC,SIMPLEX,MULTICAST,LOWER_UP> metric 0 mtu 1500
        ...
        inet 192.168.0.72 netmask 0xffffff00 broadcast 192.168.0.255
        inet 192.168.0.206 netmask 0xffffffff broadcast 192.168.0.206
        ...
lo0: flags=1008049<UP,LOOPBACK,RUNNING,MULTICAST,LOWER_UP> metric 0 mtu 16384
        ...
bastille0: flags=8008<LOOPBACK,MULTICAST> metric 0 mtu 16384
        ...
em0bridge: flags=1008843<UP,BROADCAST,RUNNING,SIMPLEX,MULTICAST,LOWER_UP> metric 0 mtu 1500
        ...
e0a_bastille1: flags=1008943<UP,BROADCAST,RUNNING,PROMISC,SIMPLEX,MULTICAST,LOWER_UP> metric 0 mtu 1500
        description: vnet0 host interface for Bastille jail testjailVnetIp
        ...
А в контейнері – всі ті самі інтерфейси, що і на хості, але для em0 тільки один IP:
[root@test-free-15-bastille ~]# jexec testjailAlias ifconfig
em0: flags=1008943<UP,BROADCAST,RUNNING,PROMISC,SIMPLEX,MULTICAST,LOWER_UP> metric 0 mtu 1500
        ...
        ether 08:00:27:d5:55:b2
        inet 192.168.0.206 netmask 0xffffffff broadcast 192.168.0.206
        ...
lo0: flags=1008049<UP,LOOPBACK,RUNNING,MULTICAST,LOWER_UP> metric 0 mtu 16384
        ...
bastille0: flags=8008<LOOPBACK,MULTICAST> metric 0 mtu 16384
        ...
em0bridge: flags=1008843<UP,BROADCAST,RUNNING,SIMPLEX,MULTICAST,LOWER_UP> metric 0 mtu 1500
        ...
e0a_bastille1: flags=1008943<UP,BROADCAST,RUNNING,PROMISC,SIMPLEX,MULTICAST,LOWER_UP> metric 0 mtu 1500
        ...
Тепер, якщо ми не запустимо sshd в контейнері – то підключення на IP 192.168.0.206 піде на SSH daemon самого хоста – “Password for setevoy@test-free-15-bastille”
[setevoy@setevoy-work ~] $ ssh -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null [email protected]
Warning: Permanently added '192.168.0.206' (ED25519) to the list of known hosts.
([email protected]) Password for setevoy@test-free-15-bastille:
А якщо маємо відкритий порт 22 в контейнері:
root@testjailAlias:~ # service sshd onestart
То запит піде на нього – “Password for setevoy@testjailAlias“:
[setevoy@setevoy-work ~] $ ssh -o StrictHostKeyChecking=no -o UserKnownHostsFile=/dev/null [email protected]
Warning: Permanently added '192.168.0.206' (ED25519) to the list of known hosts.
([email protected]) Password for setevoy@testjailAlias:
Простіше за VNET – але маємо загальні правила Packet Filter, фаервола на хості, нема можливості отримати адресу з DHCP, можливі проблеми з overlapping ports, і важливе: якщо ламають наш jail – то отримують доступ до всієї мережі хоста.
Network type NAT
І останній на сьогодні приклад – з NAT, тільки тепер задаємо IP не з пулу домашньої мережі, а в інтерфейсі вказуємо loopback інтерфейс хоста bastille0:
[root@test-free-15-bastille ~]# bastille list
 JID  Name            Boot  Prio  State  Type   IP Address     Published Ports  Release       Tags
 4    testjailAlias   on    99    Up     thin   192.168.0.206  -                15.0-RELEASE  -
 6    testjailNat     on    99    Up     thin   10.0.0.10      -                15.0-RELEASE  -
 2    testjailVnetIp  on    99    Up     thin   192.168.0.205  -                15.0-RELEASE  -
Роутинг пакетів до jail піде через Packet Filter:
[root@test-free-15-bastille ~]# pfctl -s nat
nat on em0 from <jails> to any -> (em0:0)
rdr-anchor "rdr/*" all
Важливе обмеження Linux jail – для мережі недоступні VNET-опції. Тобто з варіантів – або NAT і port-forward, або Alias з усіма його обмеженнями і можливими проблемами.
Крім того – “Linux jails are still considered experimental” – хоча в цілому працює достатньо стабільно.
Для Linux нам потрібно виконати bastille setup linux – тоді Bastille підтягне потрібні модулі і скрипти:
[root@test-free-15-bastille ~]# bastille setup linux
[WARNING]: Running linux jails requires loading additional kernel
modules, as well as installing the 'debootstrap' package.
Do you want to proceed with setup? [y|n]:y

Loading kernel module: fdescfs

Persisting module: fdescfs
fdescfs_load:  -> YES

Loading kernel module: linprocfs

Persisting module: linprocfs
linprocfs_load:  -> YES

Loading kernel module: linsysfs

Persisting module: linsysfs
linsysfs_load:  -> YES

Loading kernel module: linux

Loading kernel module: linux64
linux_enable: NO -> YES

...
Тепер в директорії /usr/local/share/debootstrap/scripts/ маємо набір shell-скриптів, які налаштують Linux-оточення:
[root@test-free-15-bastille ~]# less /usr/local/share/debootstrap/scripts/gutsy
case $ARCH in
  amd64|i386)
        case $SUITE in
          gutsy|hardy|intrepid|jaunty|karmic|lucid|maverick|natty|oneiric|precise|quantal|raring|saucy|utopic|vivid|wily|yakkety|zesty)
        default_mirror http://old-releases.ubuntu.com/ubuntu
...
keyring /usr/local/share/keyrings/ubuntu-archive-keyring.gpg
Виконуємо bootstrap, вказуємо ім’я системи – власне, ім’я скрипта з /usr/local/share/debootstrap/scripts/.
Але для Ubuntu остання доступна версія – Jammy, 22.04.
Займе хвилин 10-15, може і більше поки все скачає:
[root@test-free-15-bastille ~]# bastille bootstrap jammy

Attempting to bootstrap Linux/Ubuntu release: Ubuntu_2204

Ensuring Linux compatability...

...
Потім створюємо контейнер з create та опцією --linux (-L):
Також варто подивитись на bastille monitor – є цікаві можливості з моніторингу і алертингу, та Templates – створення контейнерів з шаблонів які можна взяти з BastilleBSD/templates або створювати власні.
По самому Hermes Agent і його можливостям буду писати окремо, сьогодні – як запустити його на FreeBSD.
Вчора погрався на своєму Arch Linux – тепер хочеться вже більш production setup.
Крутити буду на моєму NAS з FreeBSD, запускати там, звісно, вже тільки у FreeBSD Jail, бо NAS – це доступ до важливих даних і бекапів.
На Linux налаштування агента всі ті самі – тільки простіший сетап, тому окремо описувати не буду.
А от по можливостям Hermes Agent і більш детальний конфіг – зроблю окремий пост, бо там є, що потрогати.
Для роботи з Jails використовую Bastille – про неї теж якось окремо напишу, є чорнетка.
Власне, що будемо робити:
створимо FreeBSD Jail
налаштуємо мережу
встановимо сам Hermes Agent
налаштуємо підключення до Telegram
і встановимо Hermes Agent Web UI
Поїхали.
Але спочатку трохи оффтопік 🙂
Holywar: FreeBSD Jail чи “контейнер”?
Тут коротко – чи вірно казати “контейнер” про FreeBSD Jail – бо мене можуть заплювати 🙂
Як людина, яка зазвичай працює з Linux, то для мене “контейнер” це і FreeBSD Jail – і Linux Docker, тому в цьому пості буду все ж про Jails казати “контейнери”.
While reading the documentation and using Bastille, you will find that sometimes “container” is used, and sometimes “jail” is used. These are completely interchangeable, but there is some debate as to which one is more correct. Be that as it may, anytime you read “container” or “jail”, it means a FreeBSD jail.
Крім того, читачі мого блогу в основному теж Linux users – тому нехай вже буде “контейнери”. А в окремому пості по Bastille трохи детальніше поговоримо про Jails у FreeBSD vs Linux containers.
root@setevoy-nas:~ # bastille list hermesagent1
 JID  Name          Boot  Prio  State  Type   IP Address     Published Ports  Release               Tags
 3    hermesagent1  on    99    Up     thin   192.168.0.210  -                14.4-RELEASE          -
Аби ми могли писати боту – знаходимо свій User ID з @userinfobot.
Якщо бот буде в групі чи каналі – в тому ж боті жеж можна знайти їх ID.
Я цього бота роблю для тесту, тому залишаю мого юзера:
І в “home channel” теж:
Готово:
Далі ще налаштування браузера та Tools – там залишаємо все дефолтними, і готово:
Telegram та Hermes Agent Gateway на FreeBSD
На Linux Hermes Gateway включається просто через systemd – на FreeBSD трохи “ручками” (в лапках – бо зробив це самим агентом 🙂 ).
Перевіряємо статус зараз:
[hermes@hermesagent1 ~]$ hermes gateway status
✗ Gateway is not running

To start:
  hermes gateway run      # Run in foreground
  hermes gateway install  # Install as user service
  sudo hermes gateway install --system  # Install as boot-time system service
Команда hermes gateway install на FreeBSD очікувано повернула “not supported on this platform“:
[root@hermesagent1 /usr/home/hermes]# /home/hermes/.hermes/hermes-agent/venv/bin/hermes gateway install --system
Service installation not supported on this platform.
Run manually: hermes gateway run
Перевіряємо де саме лежить Hermes:
[hermes@hermesagent1 ~]$ head -1 "$(command -v hermes)"
#!/home/hermes/.hermes/hermes-agent/venv/bin/python3
Ну і давайте спробуємо – чи справиться агент з задачею “я лінивий інженер, сдєлай мені харашо” – нехай сам скаже, як його гейтвей додати в автостарт на FreeBSD:
Окей.
Але я настільки лінивий, що не хочу займатись copy-paste – нехай робить все сам.
Ми в Jail – тому це безпечно:
Для створення rc.d скрипта йому потрібен root – питає пароль, бо sudo у нас тут парольний:
Скрипт готовий:
Сам скрипт, який він написав – /usr/local/etc/rc.d/hermes_gateway:
#!/bin/sh

# PROVIDE: hermes_gateway
# REQUIRE: LOGIN NETWORKING
# KEYWORD: shutdown

. /etc/rc.subr

name="hermes_gateway"
rcvar="hermes_gateway_enable"

load_rc_config "$name"

: ${hermes_gateway_enable:="NO"}
: ${hermes_gateway_user:="hermes"}
: ${hermes_gateway_home:="/home/hermes"}
: ${hermes_gateway_command:="/home/hermes/.local/bin/hermes"}
: ${hermes_gateway_log:="/var/log/hermes_gateway.log"}

pidfile="/var/run/${name}.pid"
command="/usr/sbin/daemon"
command_args="-f -p ${pidfile} -u ${hermes_gateway_user} -o ${hermes_gateway_log} /usr/bin/env HOME=${hermes_gateway_home} ${hermes_gateway_command} gateway run"

start_cmd="${name}_start"
stop_cmd="${name}_stop"
status_cmd="${name}_status"

hermes_gateway_start()
{
    if [ ! -x "${hermes_gateway_command}" ]; then
        echo "Hermes executable not found or not executable: ${hermes_gateway_command}"
        return 1
    fi

    touch "${hermes_gateway_log}"
    chown "${hermes_gateway_user}" "${hermes_gateway_log}" 2>/dev/null || true

    echo "Starting Hermes gateway."
    ${command} ${command_args}
}

hermes_gateway_stop()
{
    echo "Stopping Hermes gateway."
    if [ -f "${pidfile}" ]; then
        kill "$(cat ${pidfile})" 2>/dev/null || true
        rm -f "${pidfile}"
    else
        pkill -u "${hermes_gateway_user}" -f "${hermes_gateway_command} gateway run" 2>/dev/null || true
    fi
}

hermes_gateway_status()
{
    if [ -f "${pidfile}" ] && kill -0 "$(cat ${pidfile})" 2>/dev/null; then
        echo "Hermes gateway is running as pid $(cat ${pidfile})."
        return 0
    fi

    if pgrep -u "${hermes_gateway_user}" -f "${hermes_gateway_command} gateway run" >/dev/null 2>&1; then
        echo "Hermes gateway is running, but pidfile is missing/stale."
        return 0
    fi

    echo "Hermes gateway is not running."
    return 1
}

run_rc_command "$1"
Зупиняємо “hermes gateway run“, яку запускали руками вище, і пробуємо запустити вже через сервіс:
[hermes@hermesagent1 ~]$ sudo service hermes_gateway start
Starting Hermes gateway.
[hermes@hermesagent1 ~]$ sudo service hermes_gateway status
Hermes gateway is running as pid 60901.
 Поки роблю LiteLLM (див. LiteLLM: AI Gateway для LLM – overview можливостей), то з’явилась ідея окрім сервісів типу нашого Backend API – помоніторити і Claude Code девелоперів. Чисто інтересу заради – аби побачити що там взагалі є і хто як використовує нашу Anthropic Organization, бо у багатьох там підписка за 200 баксів, яку оплачує проект (в мене дешманська за 20 😥 )
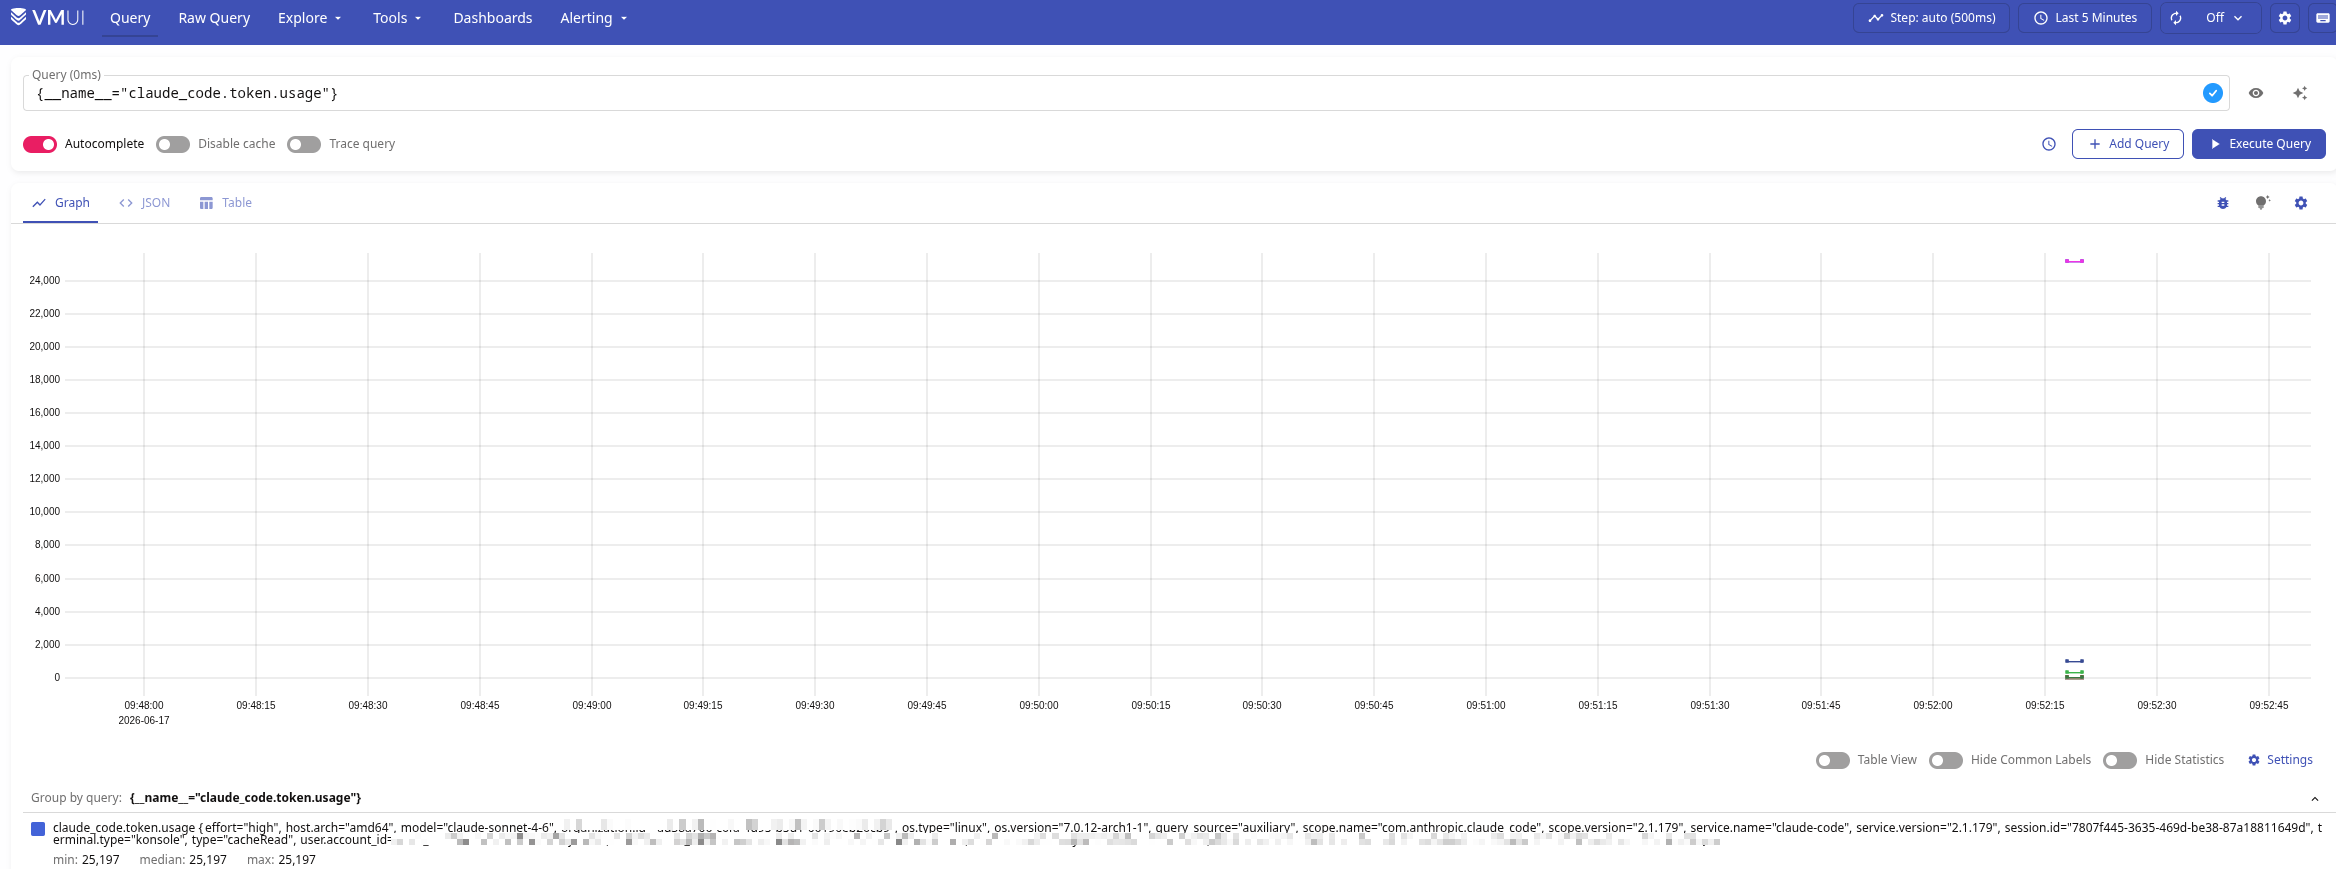
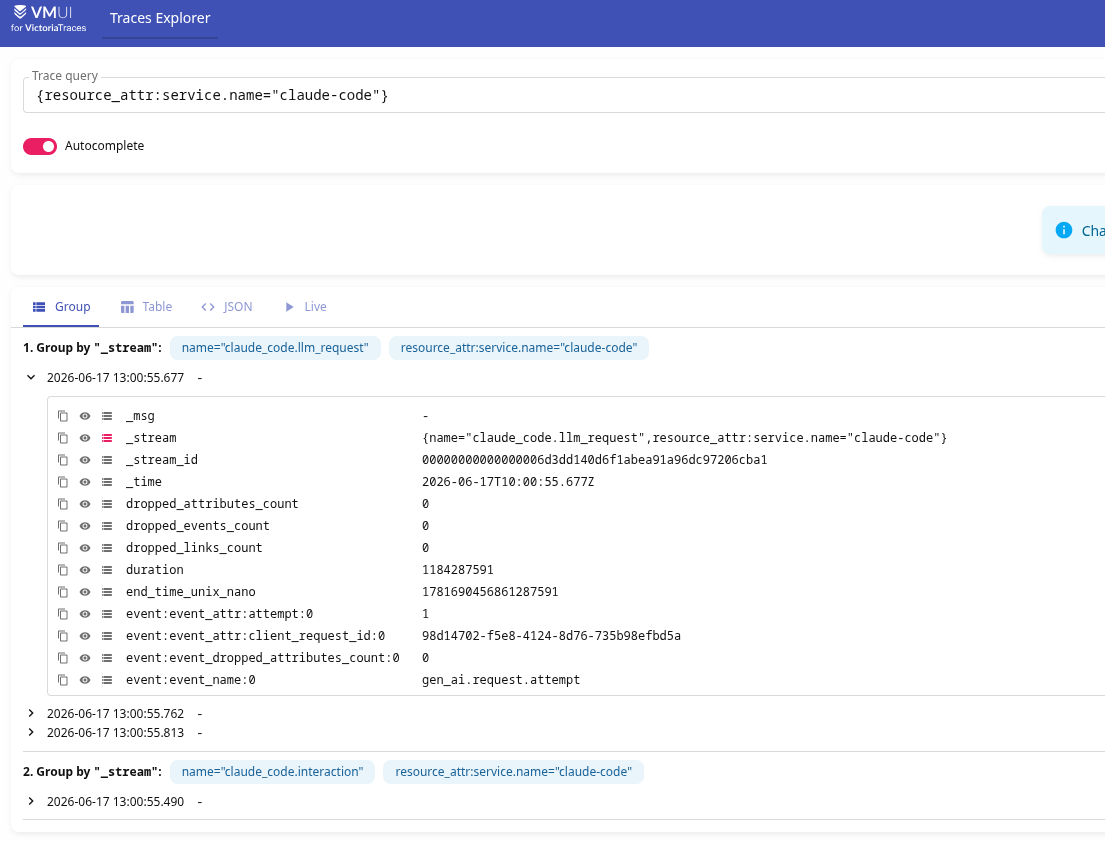
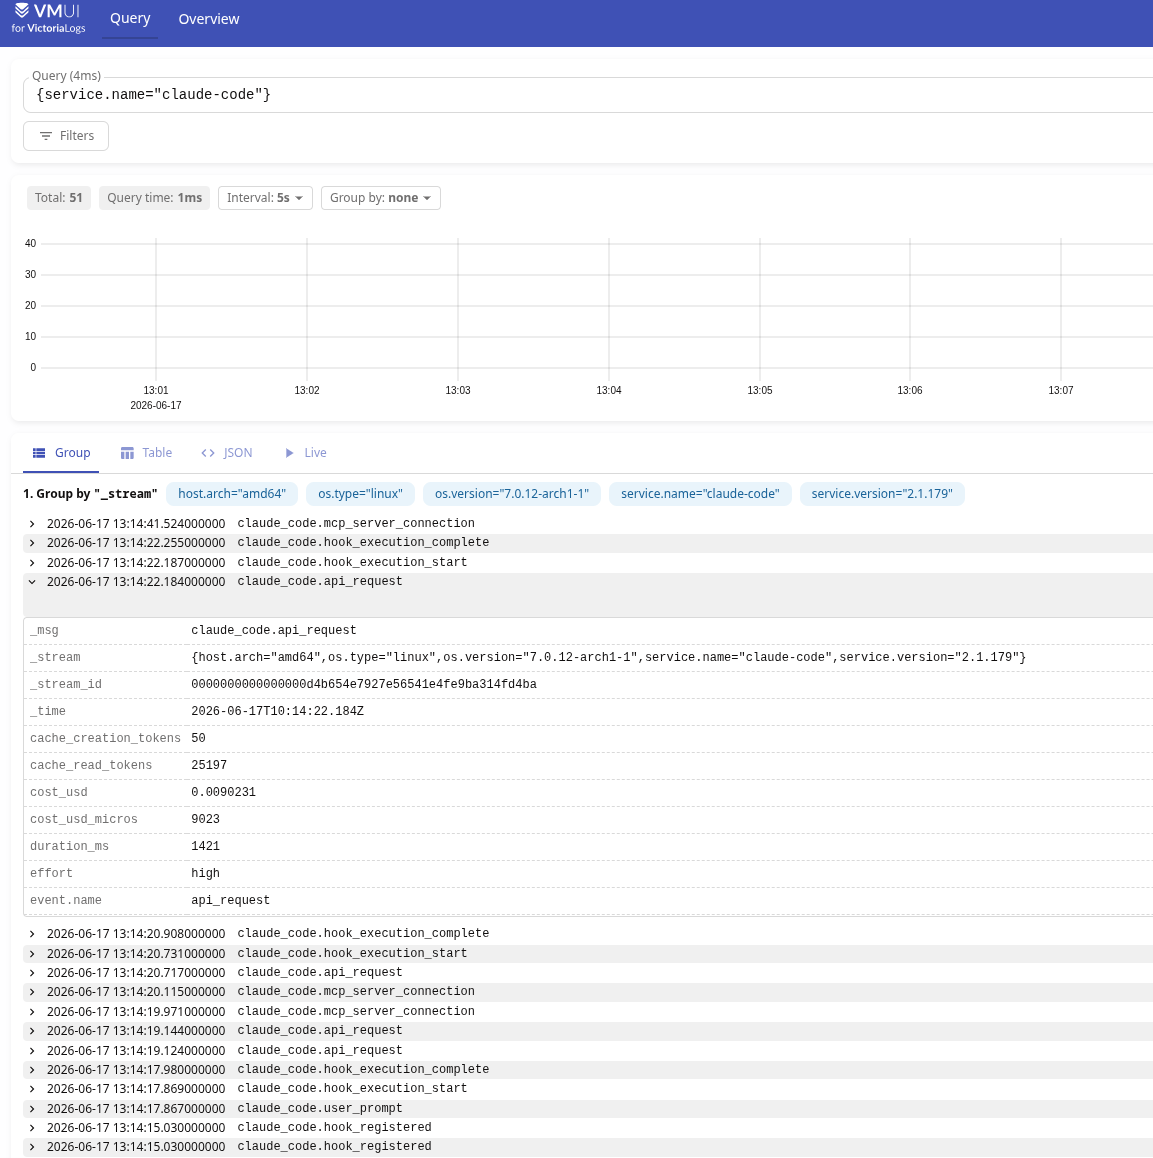
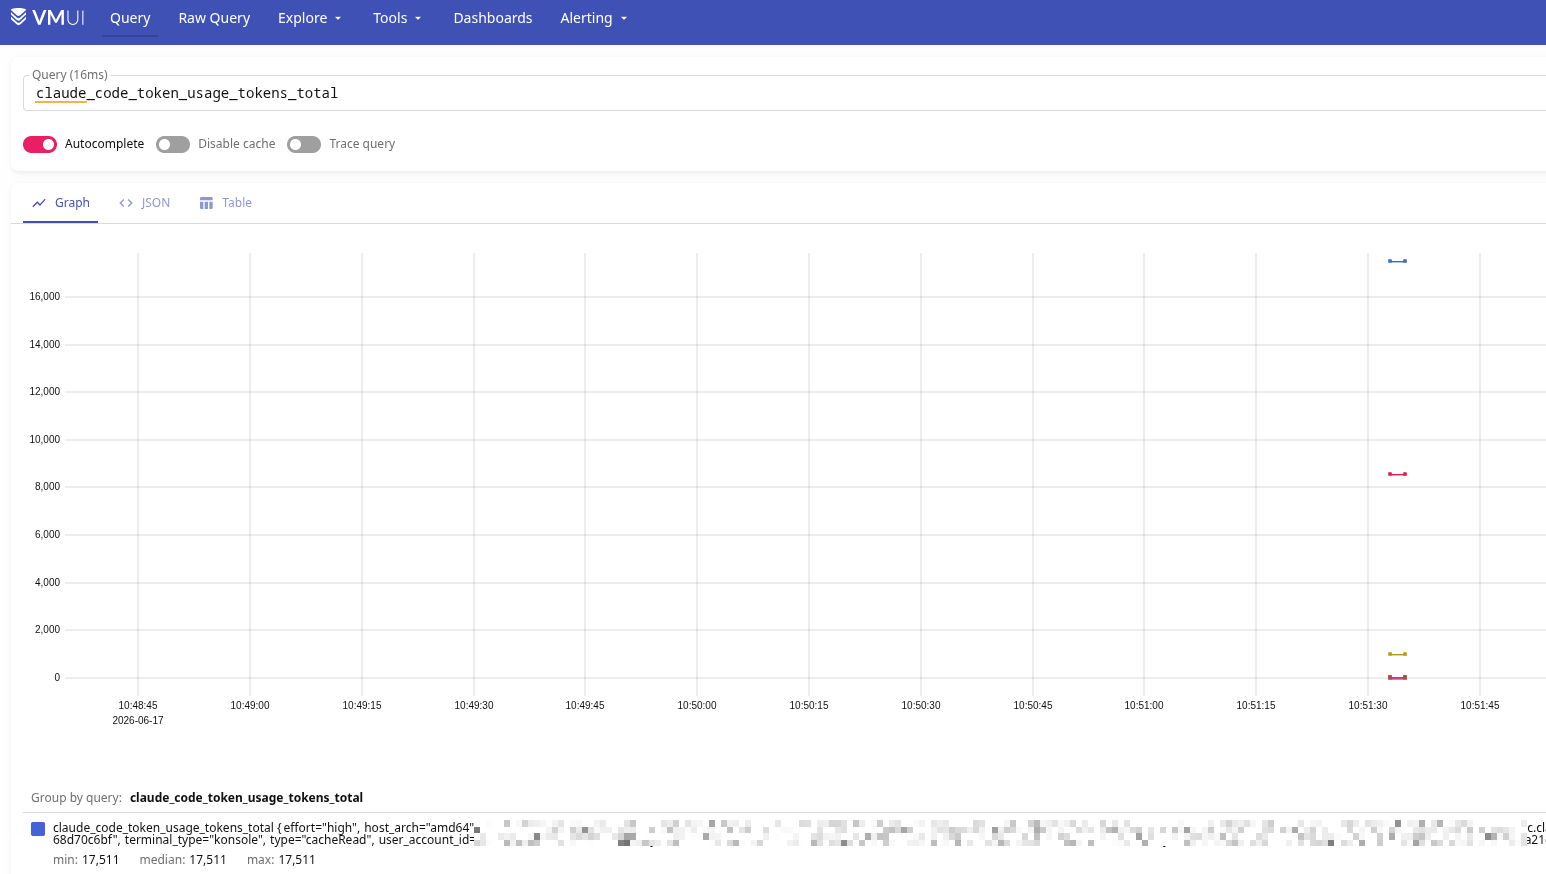
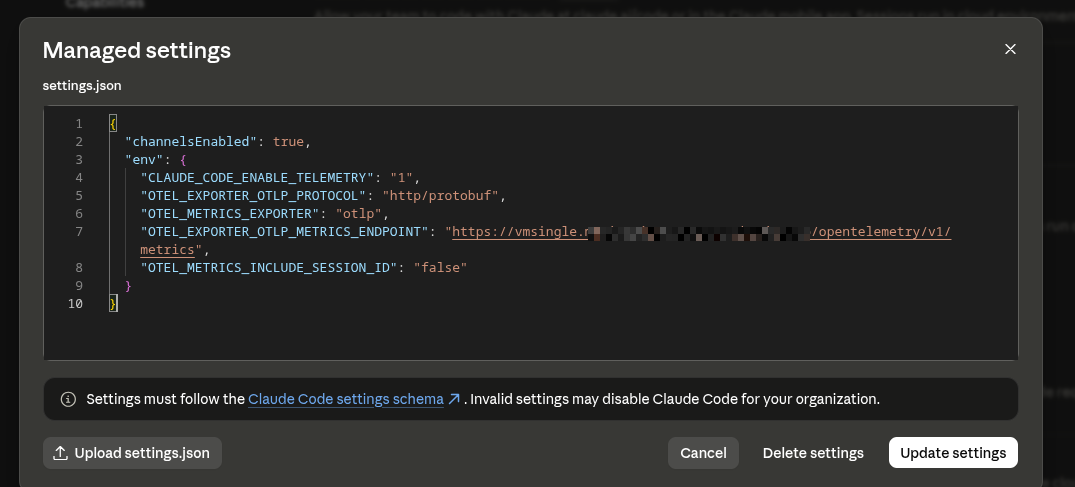

 В попередніх постах по OpenTelemetry і VictoriaTraces (див.
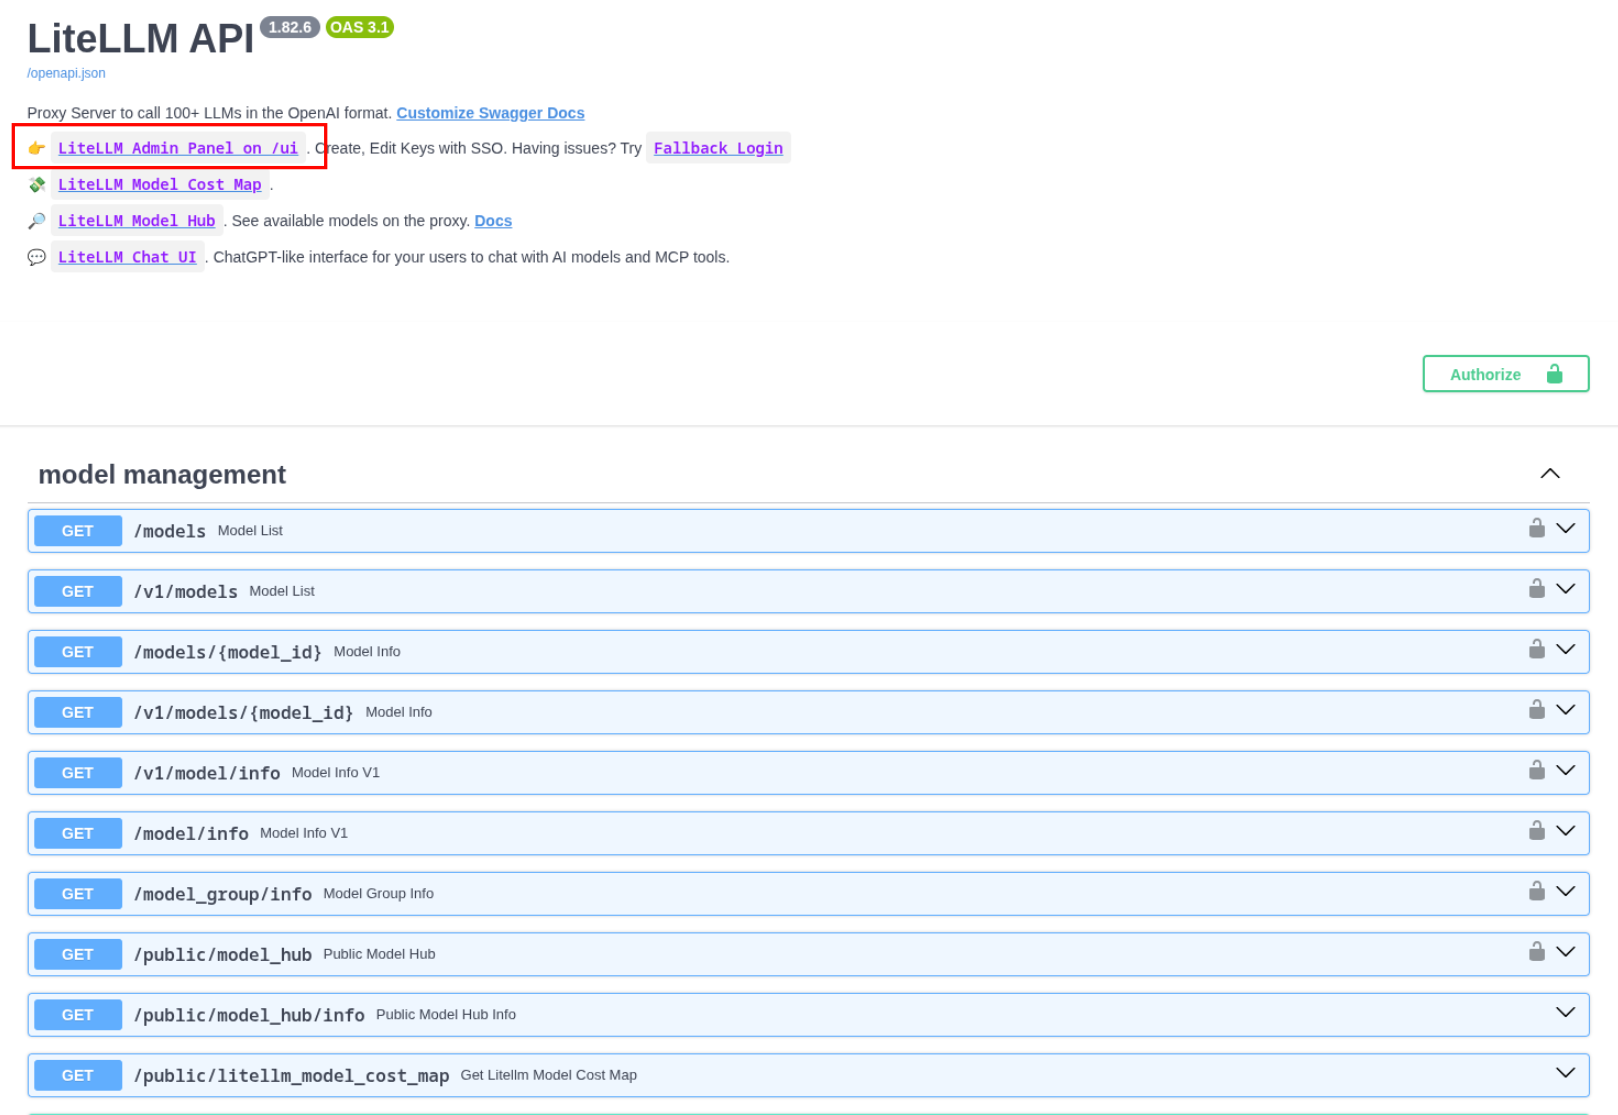
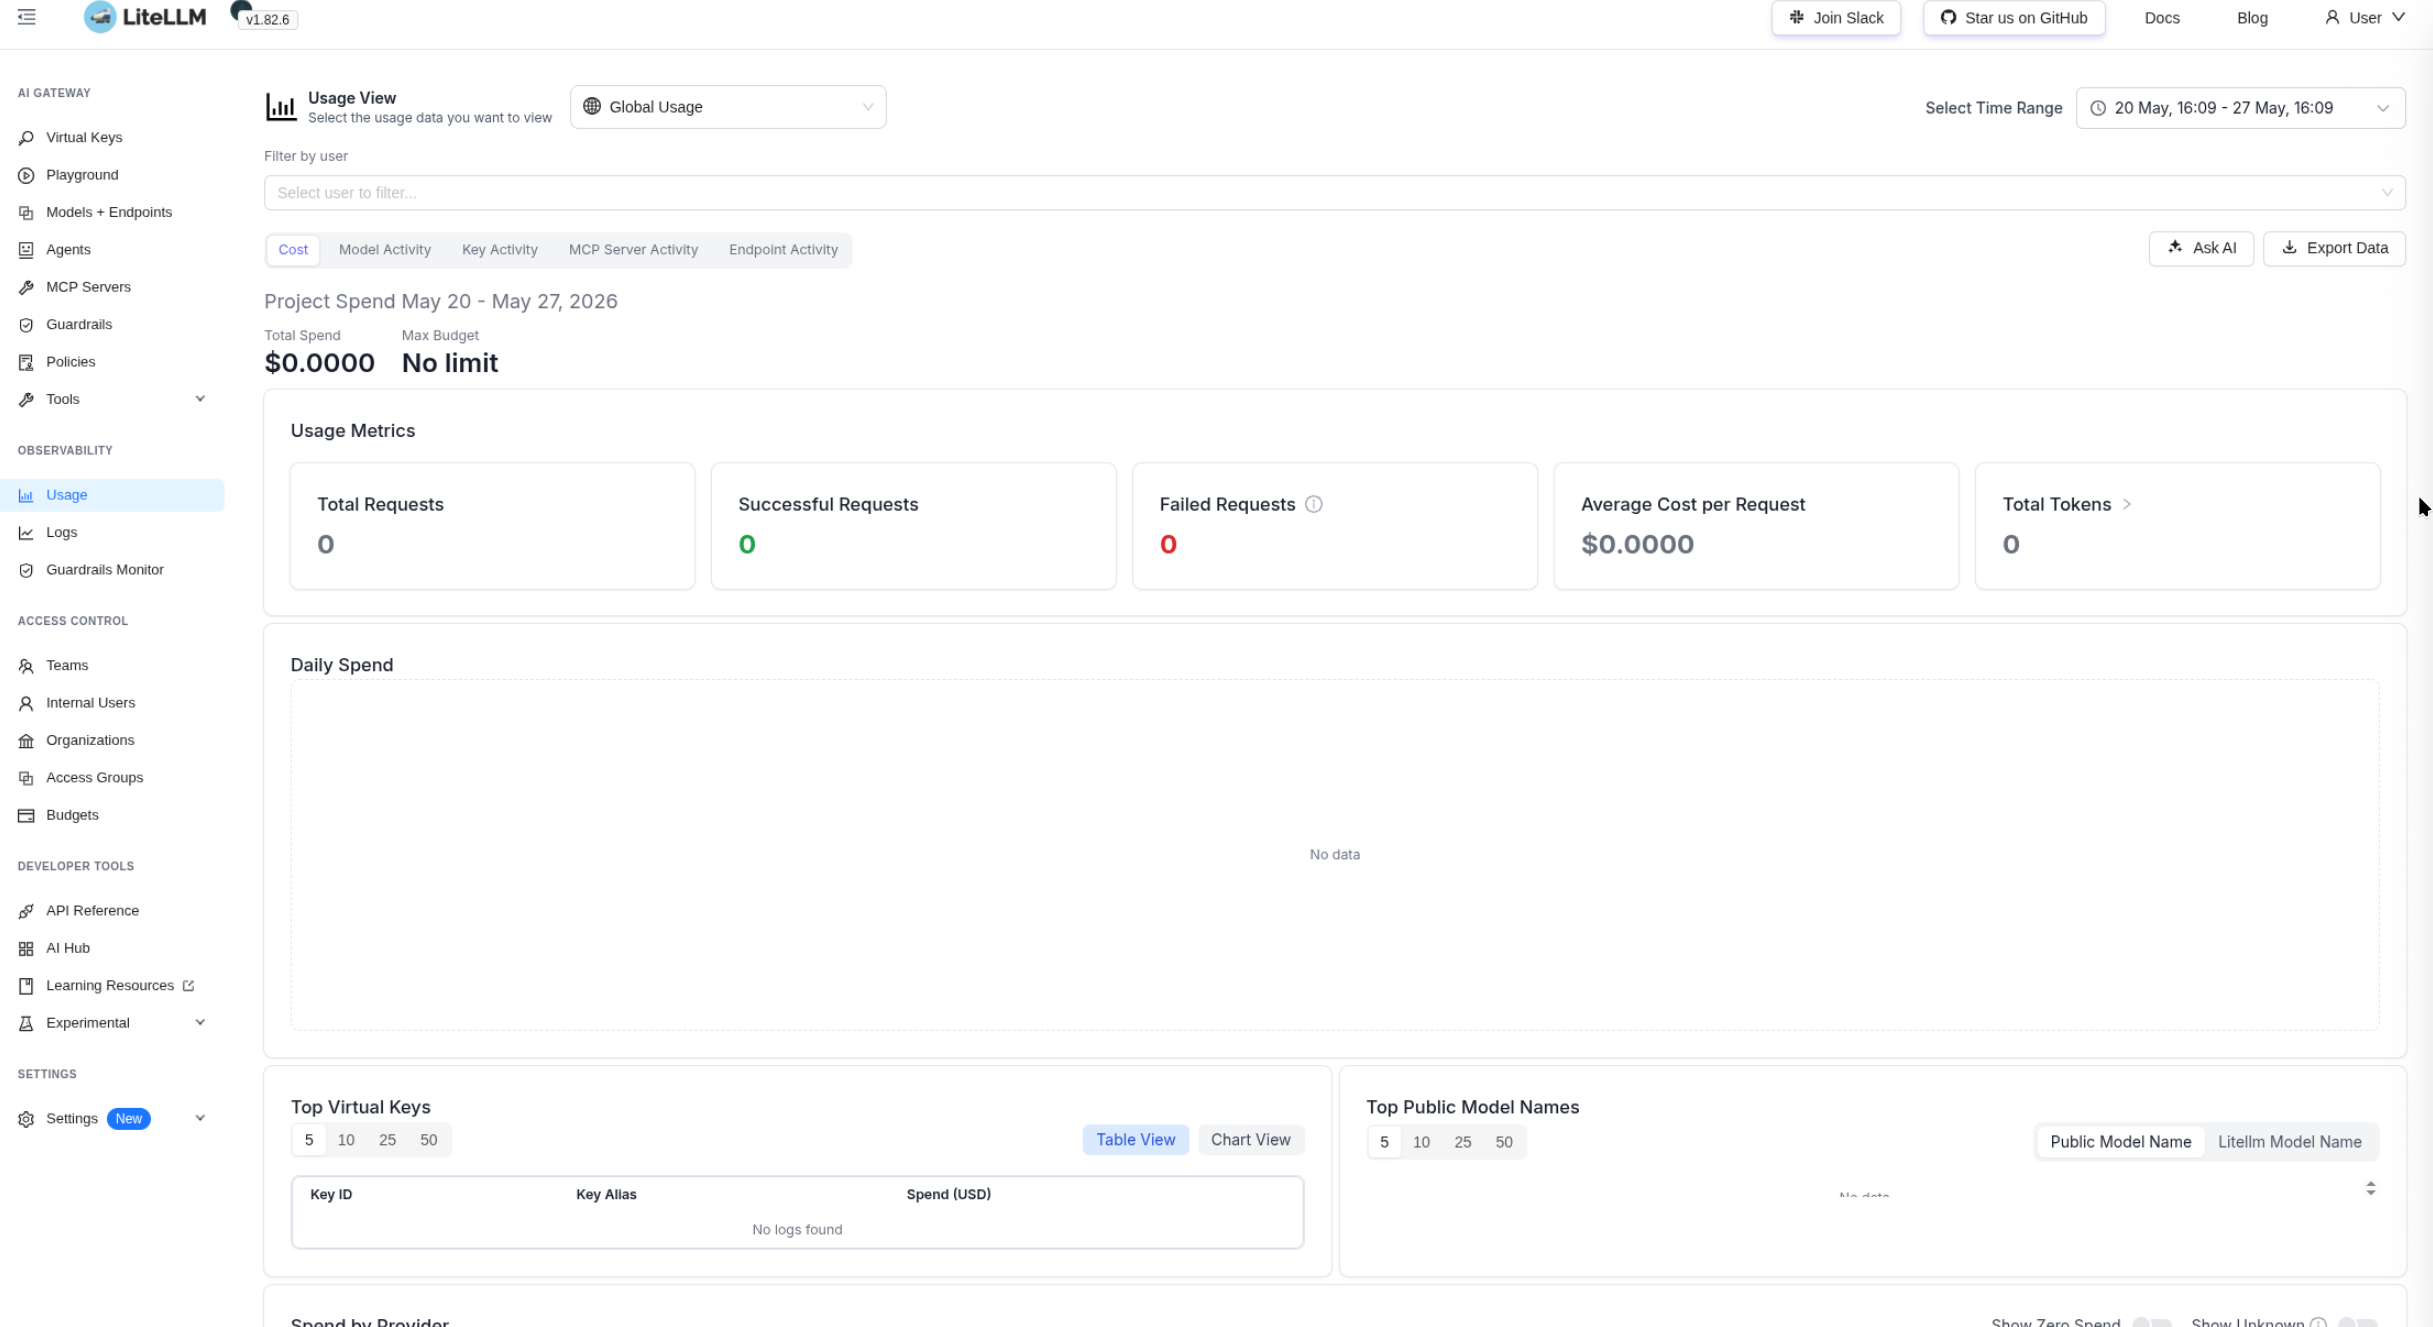
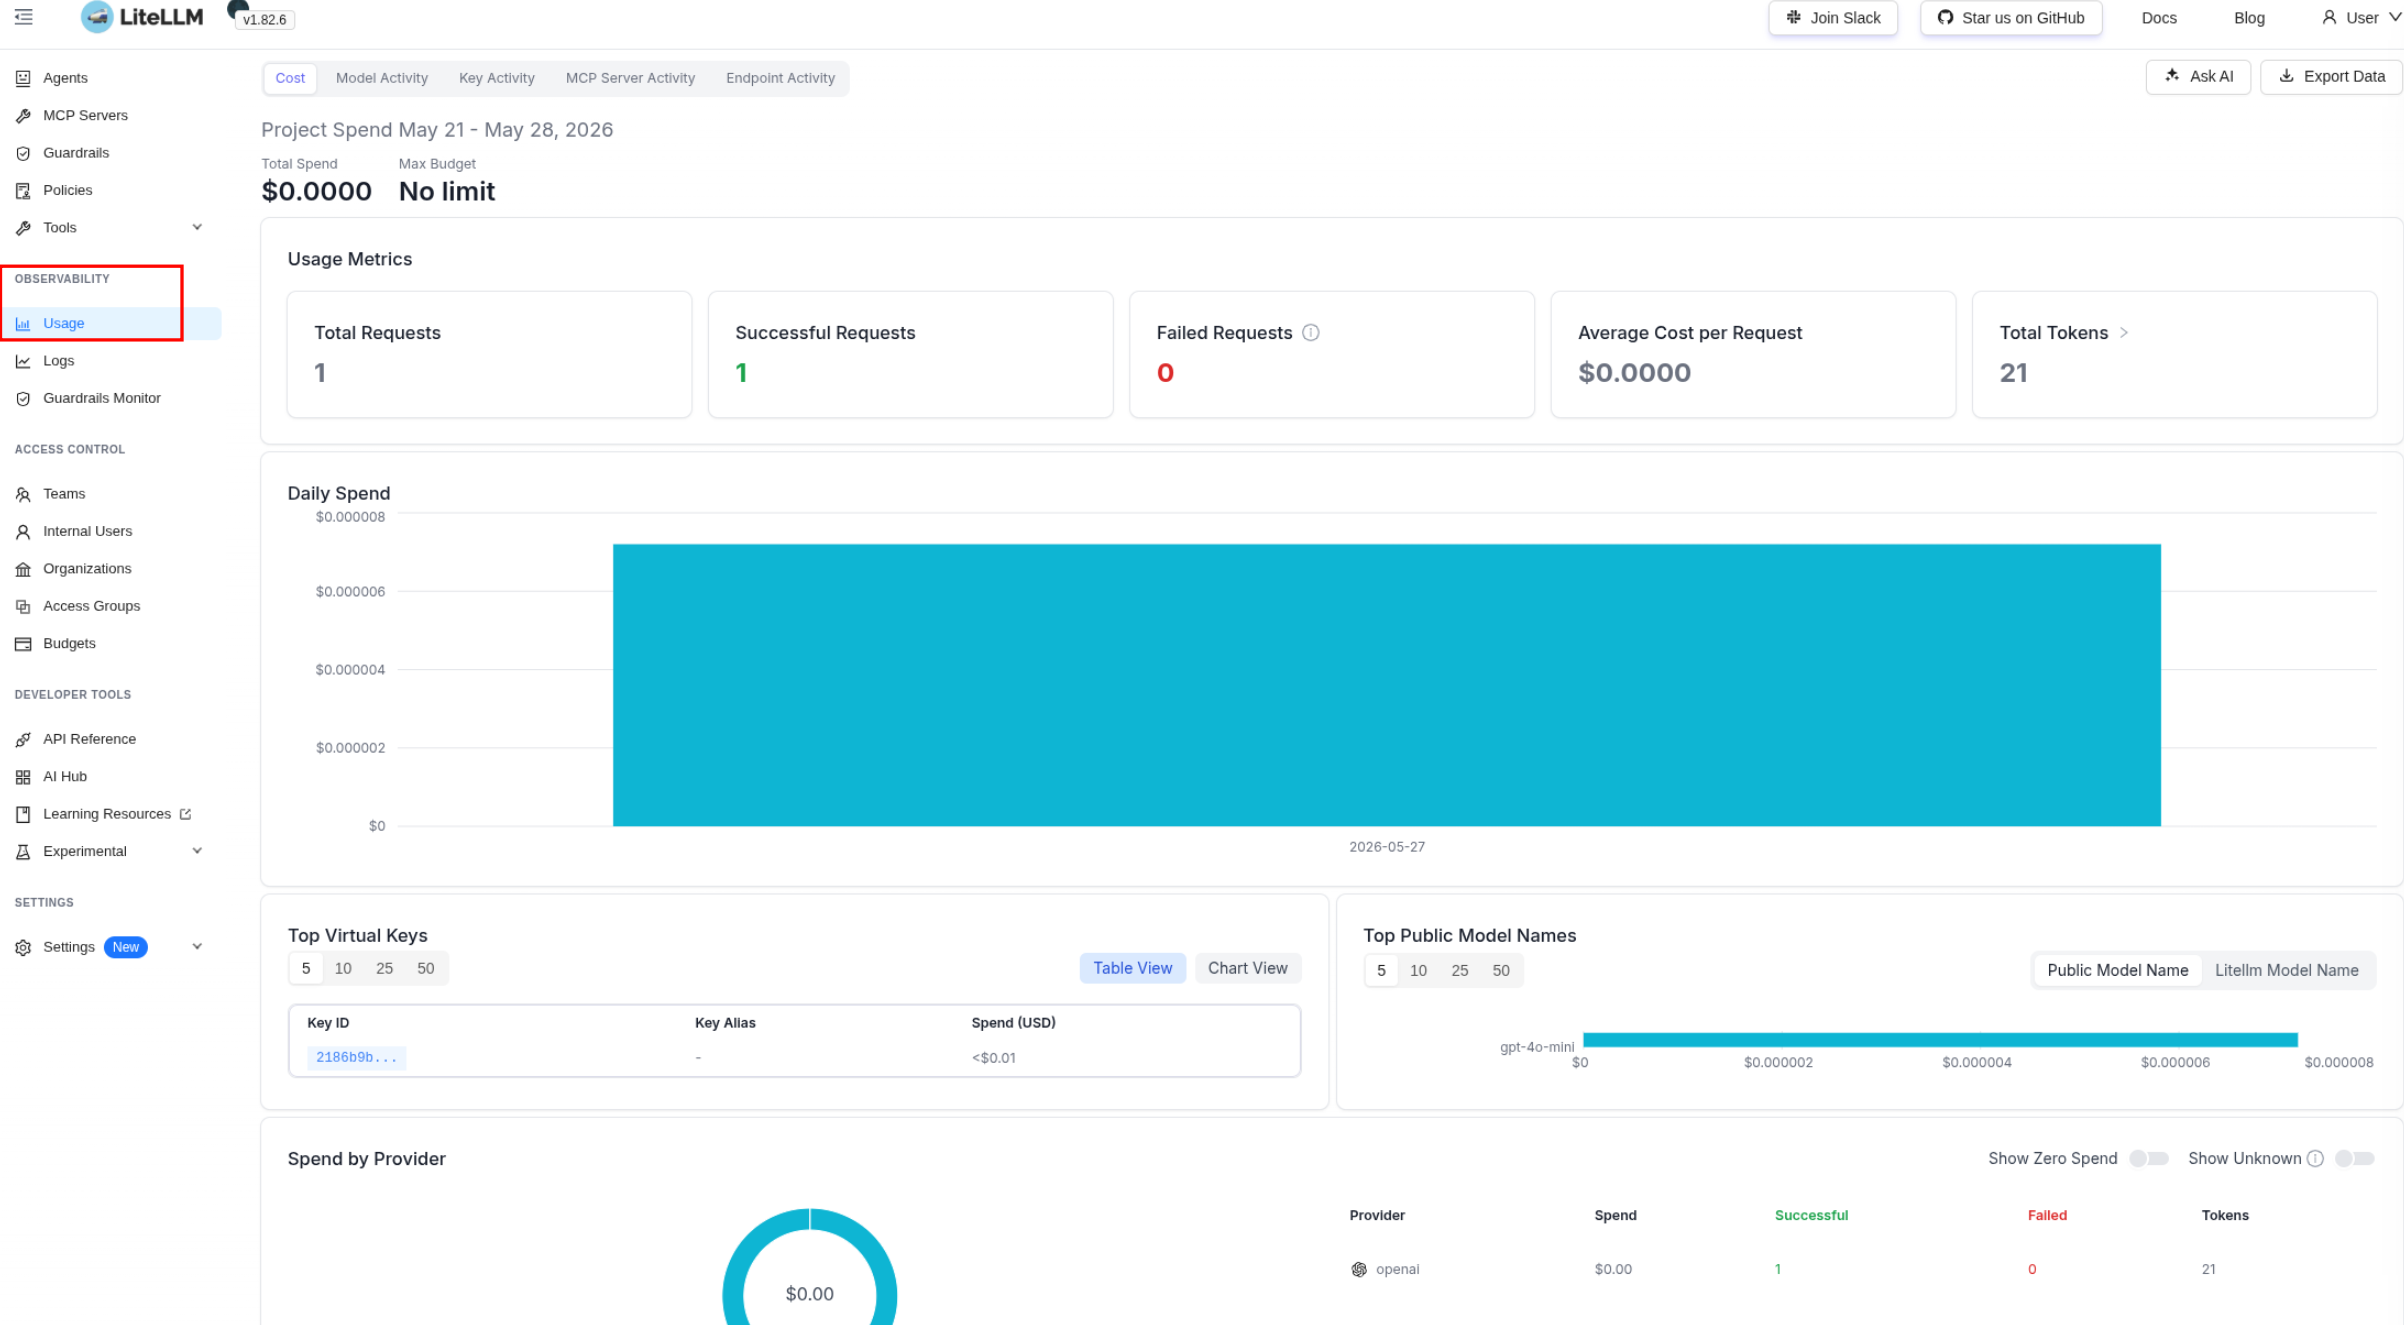
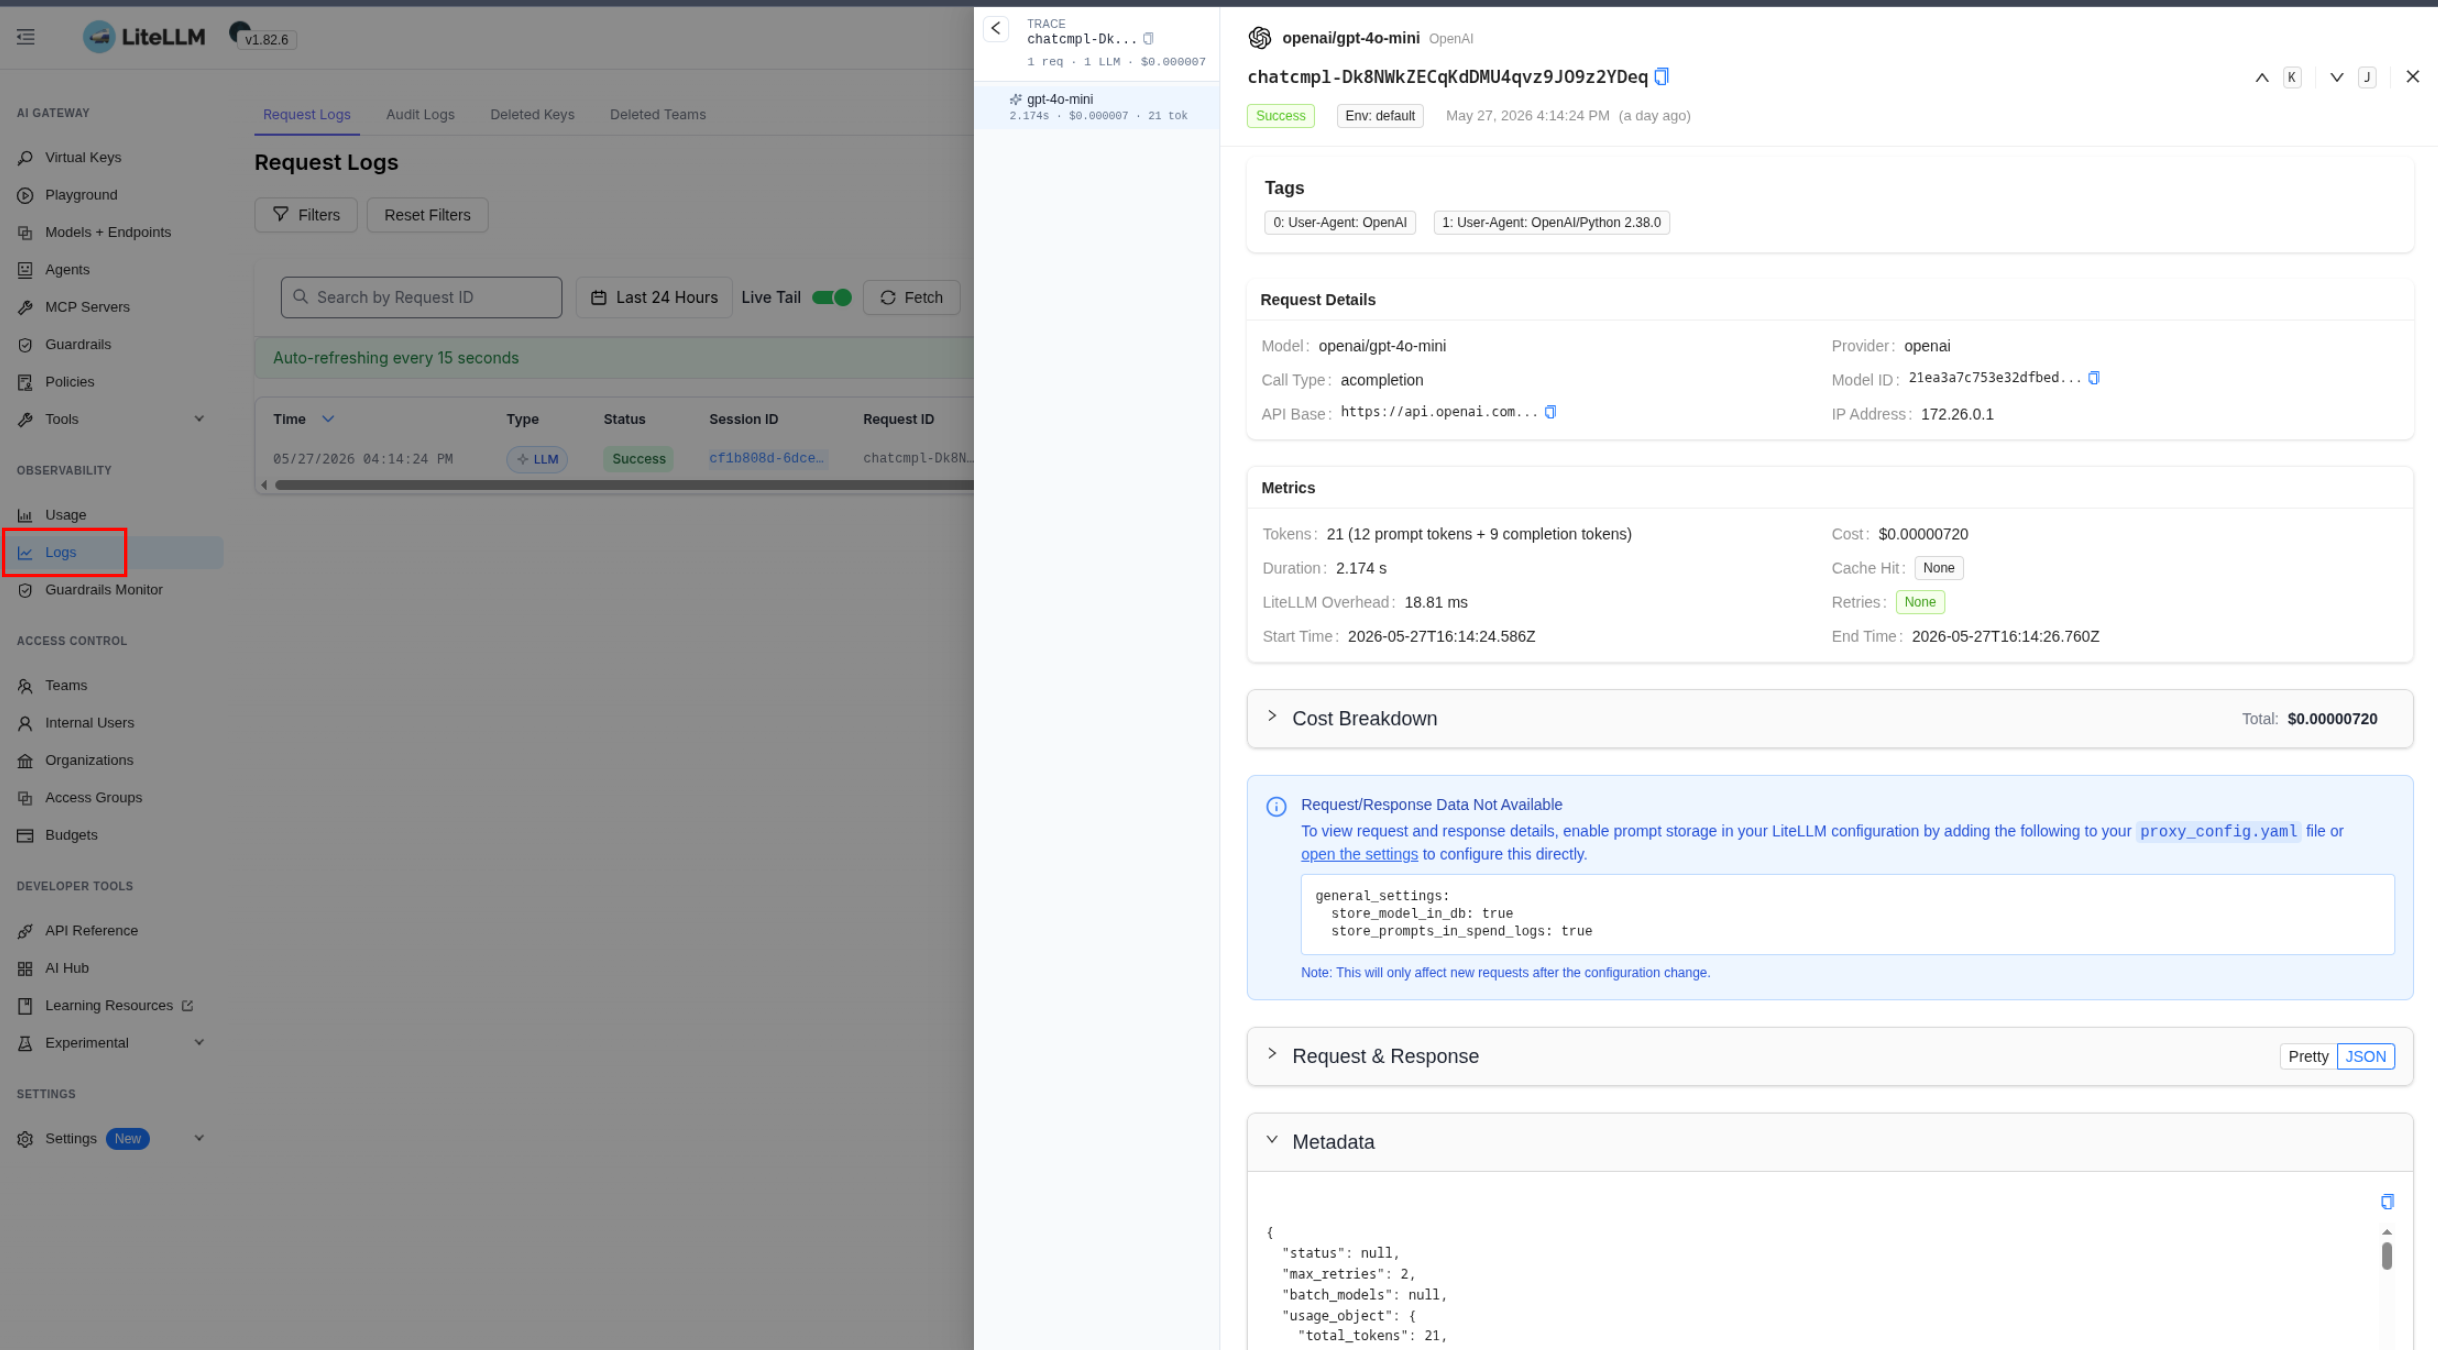
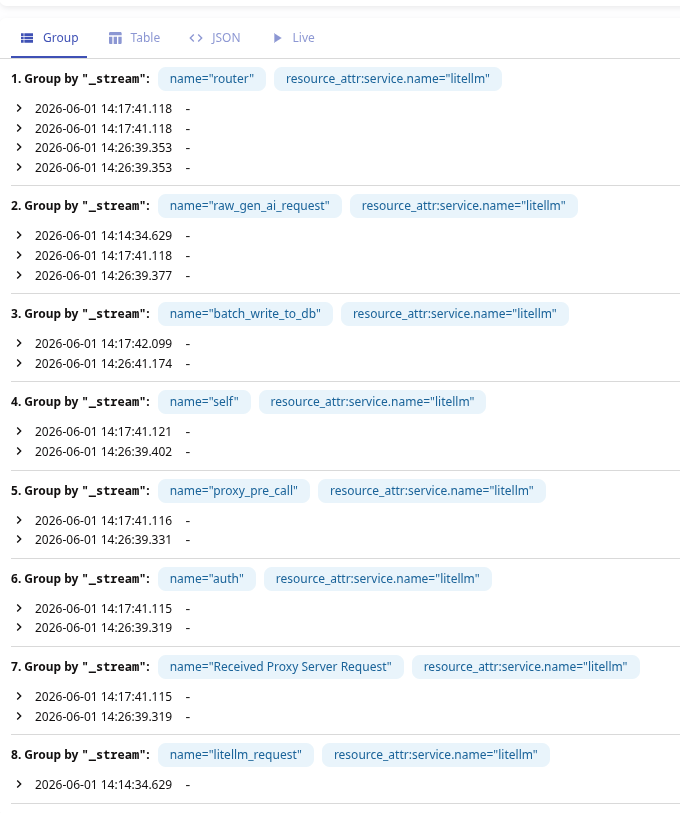
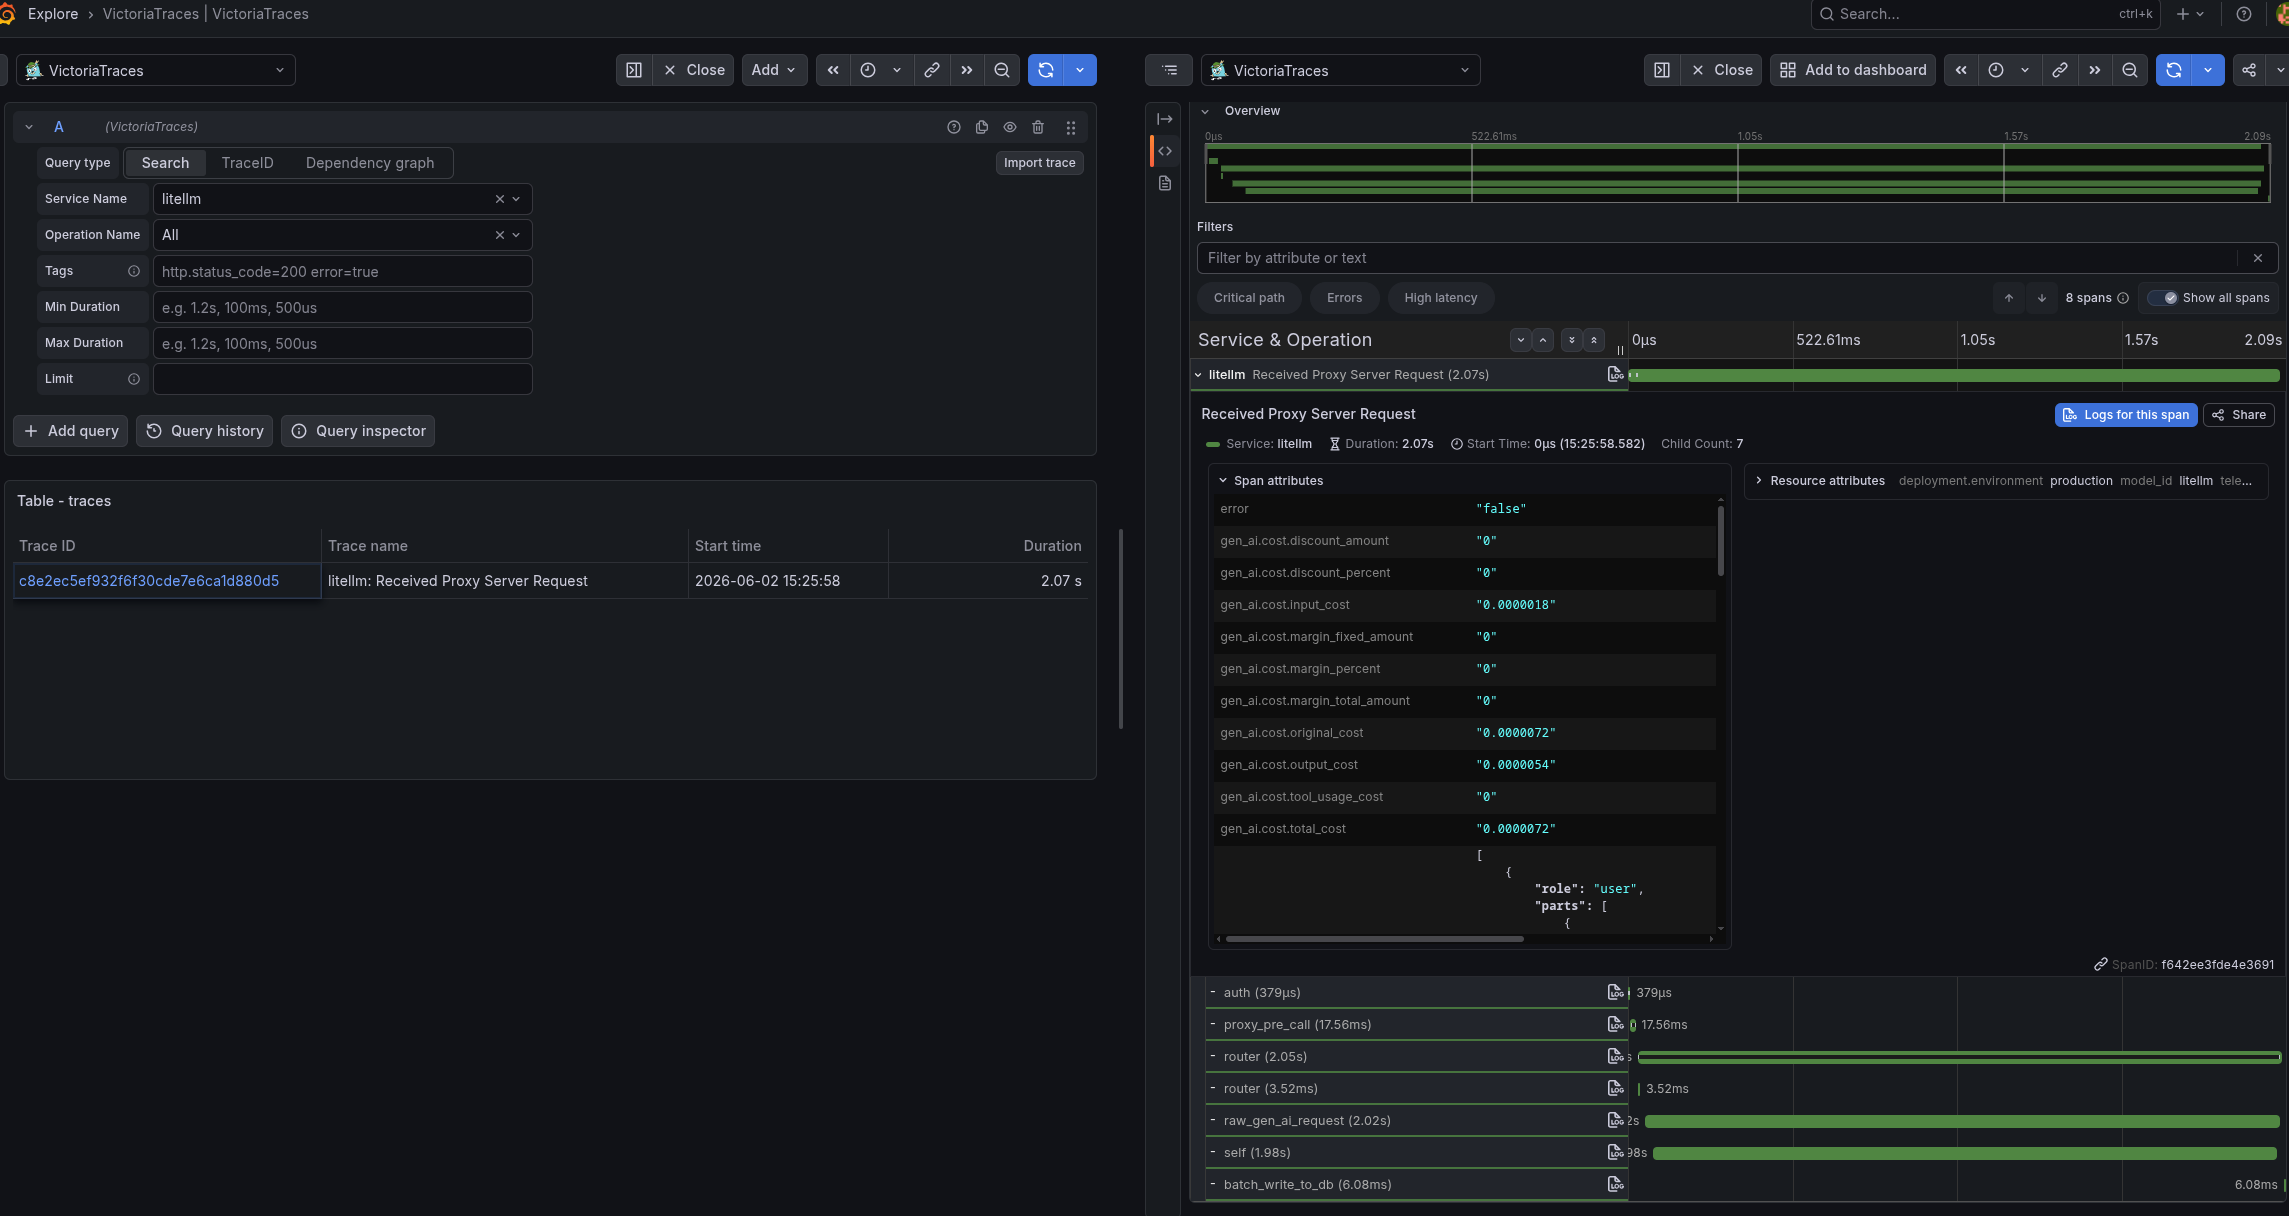
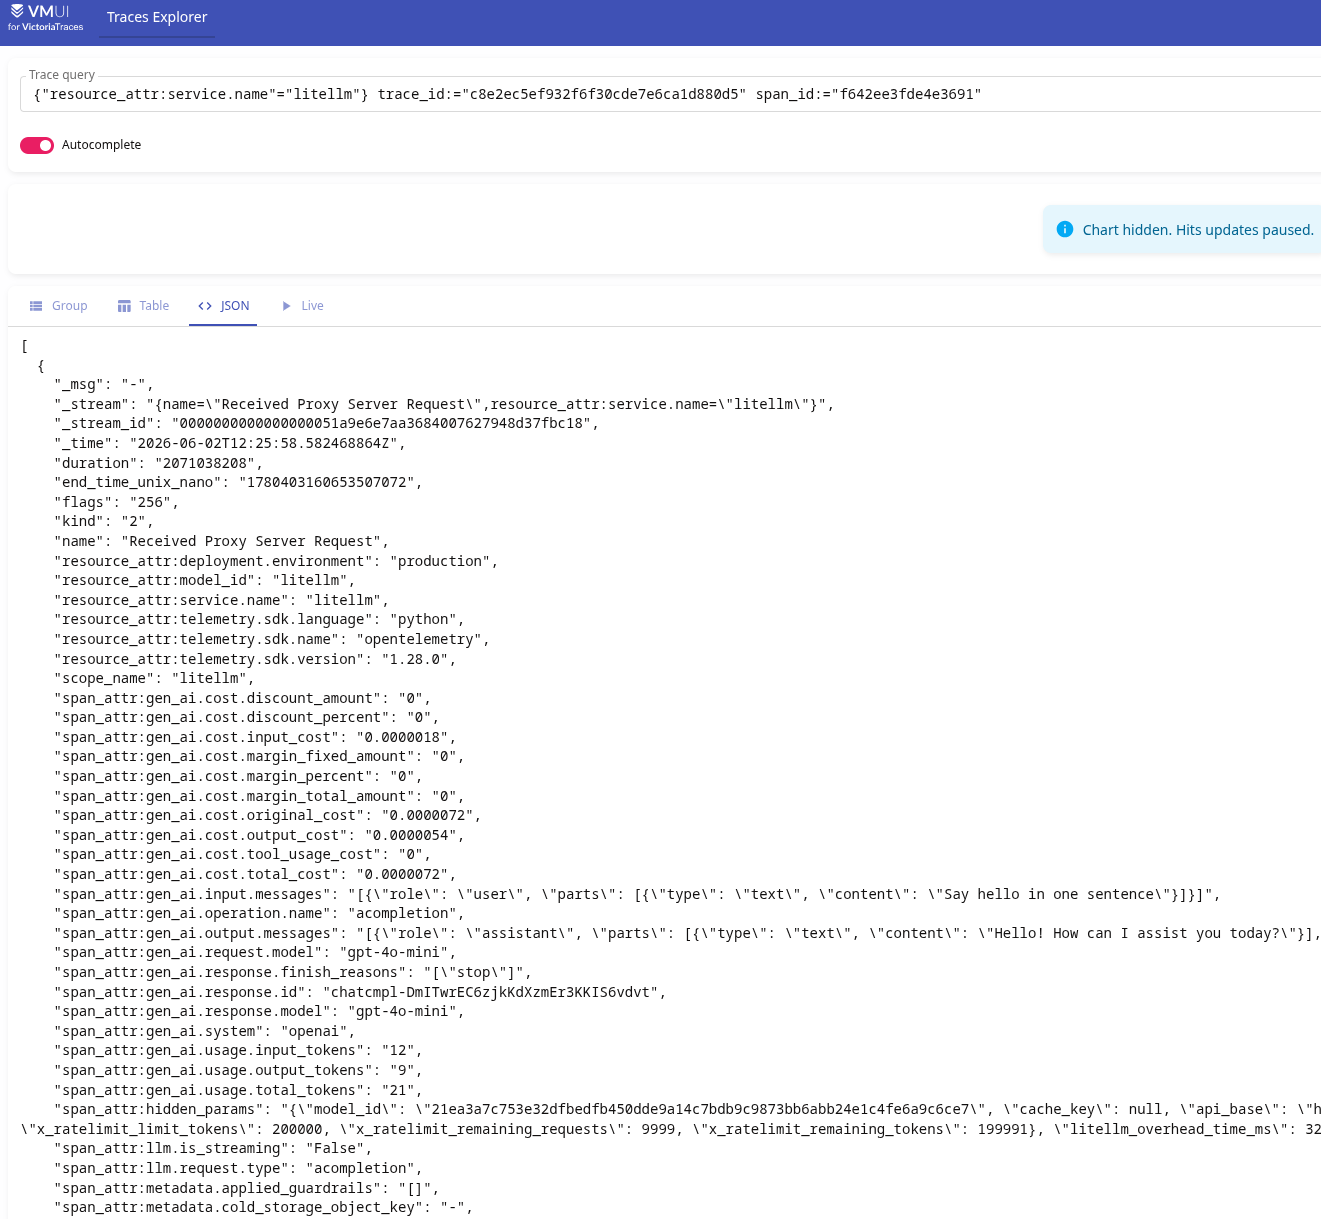
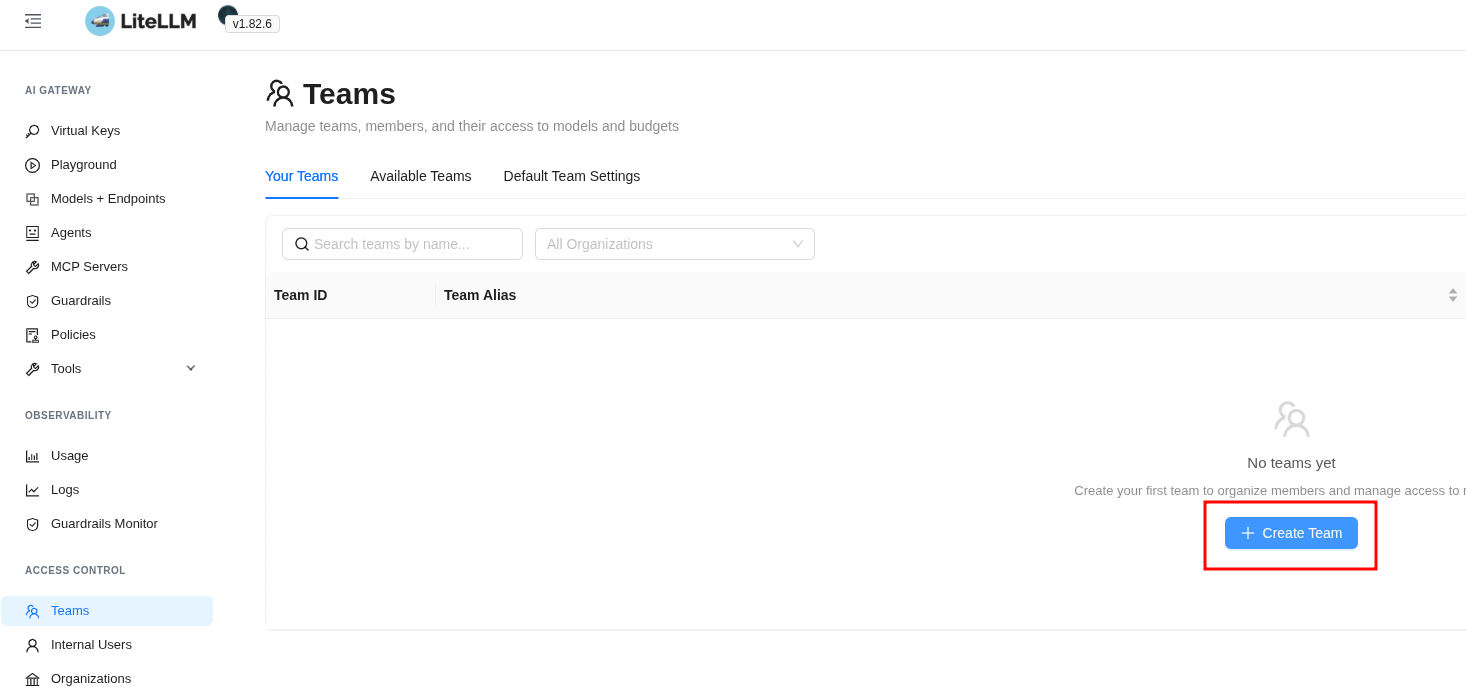
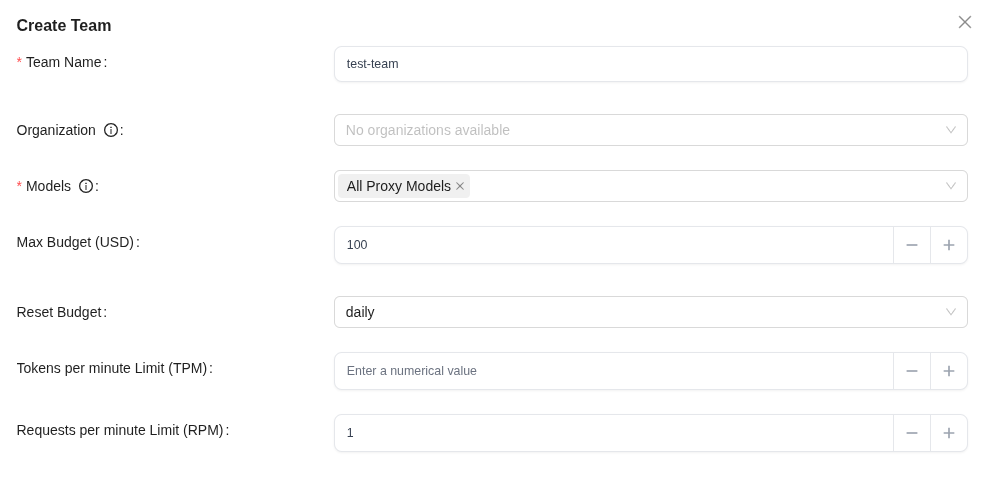
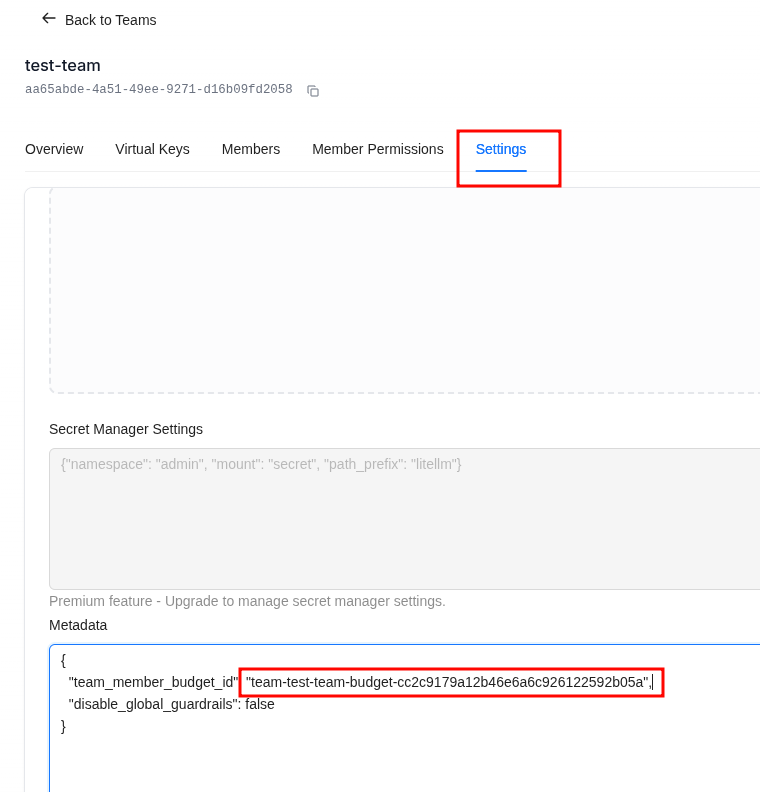
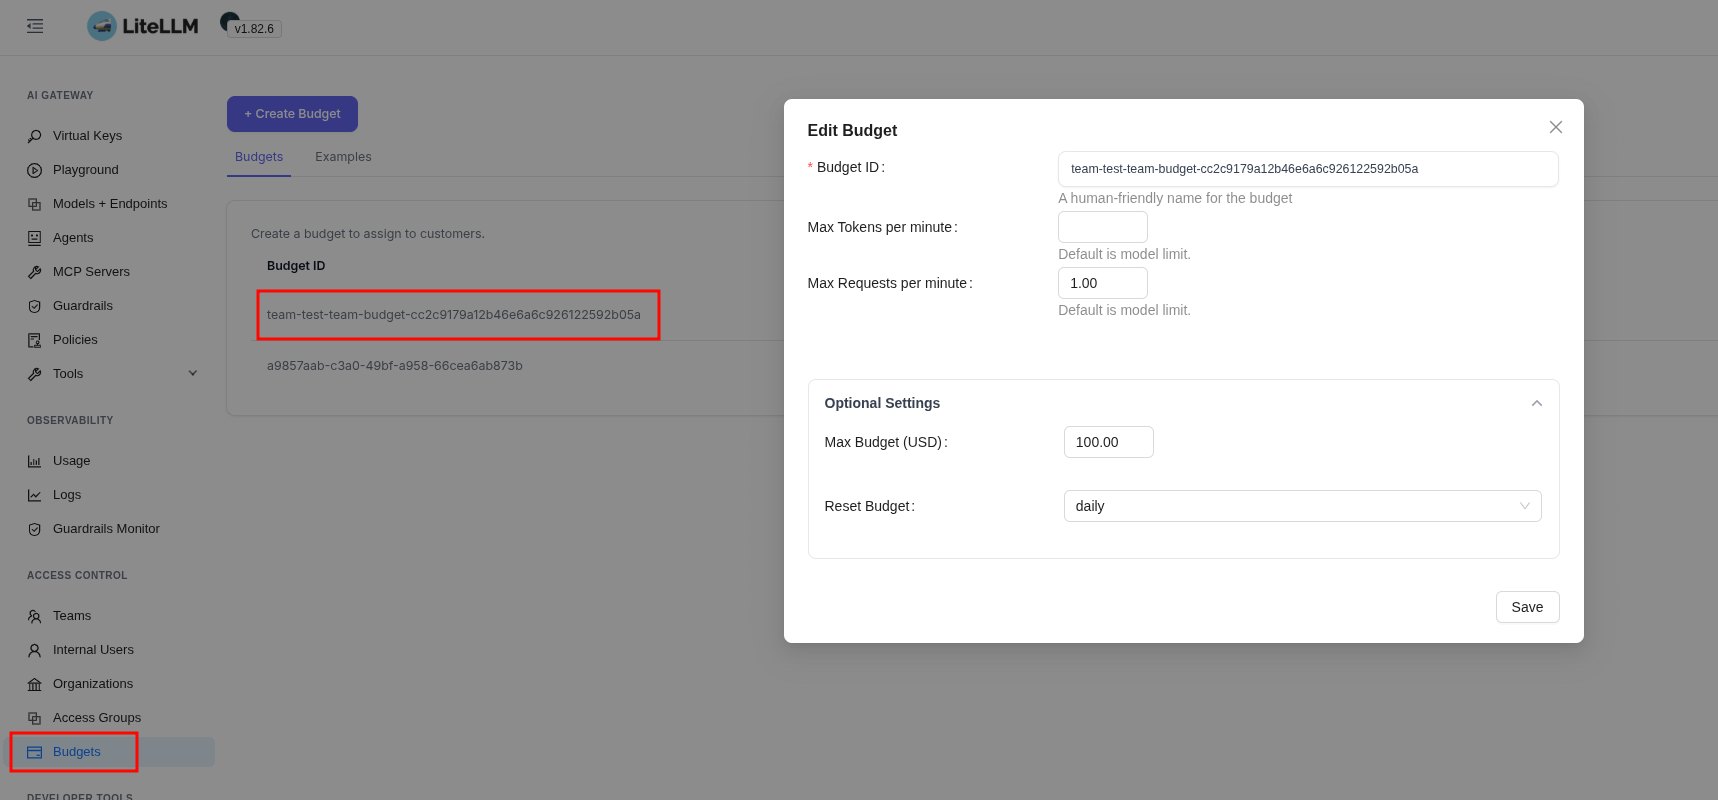
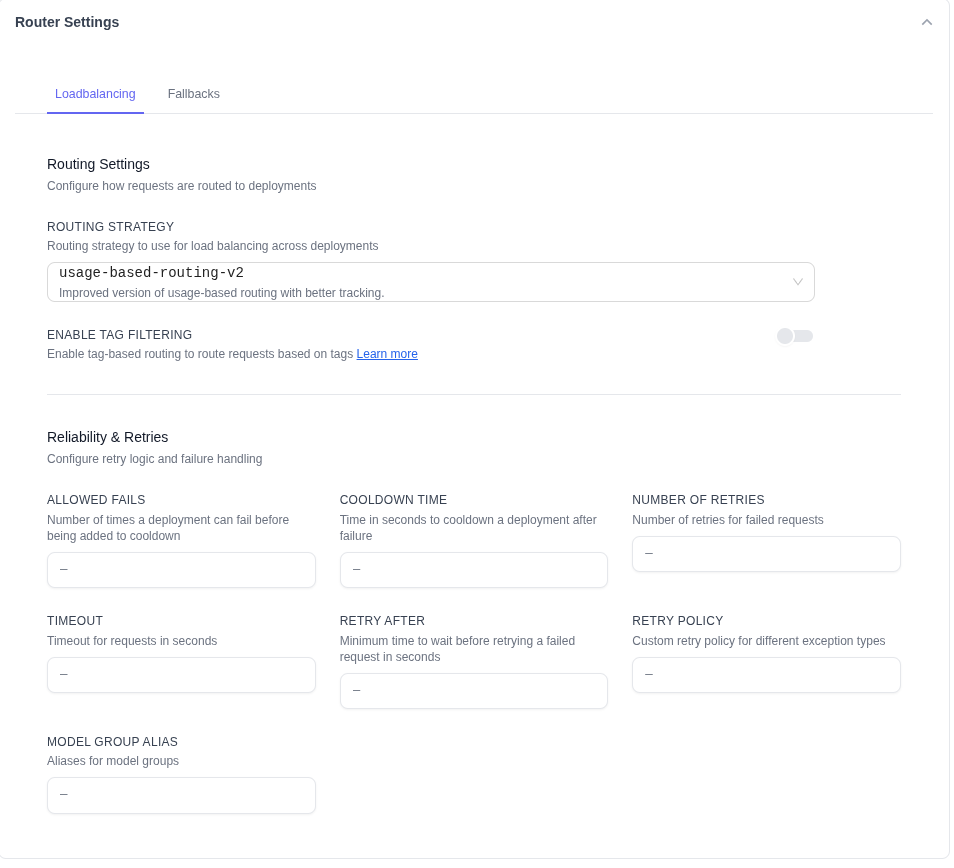
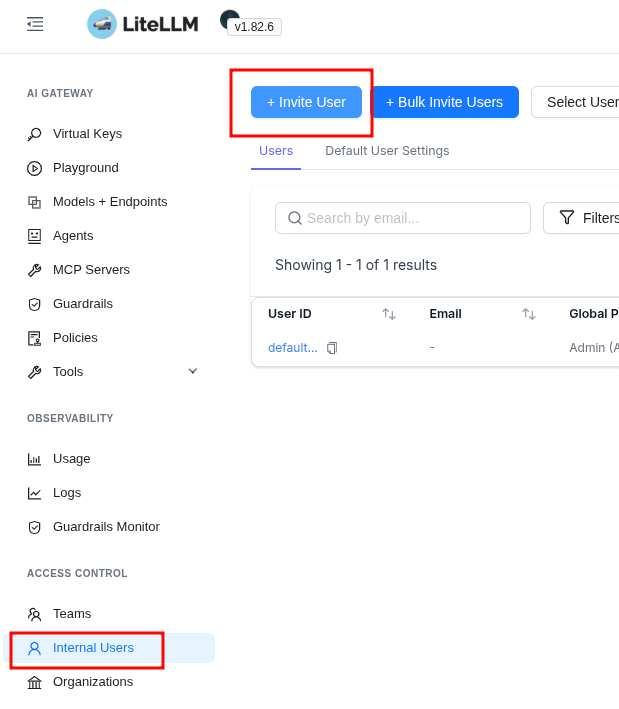
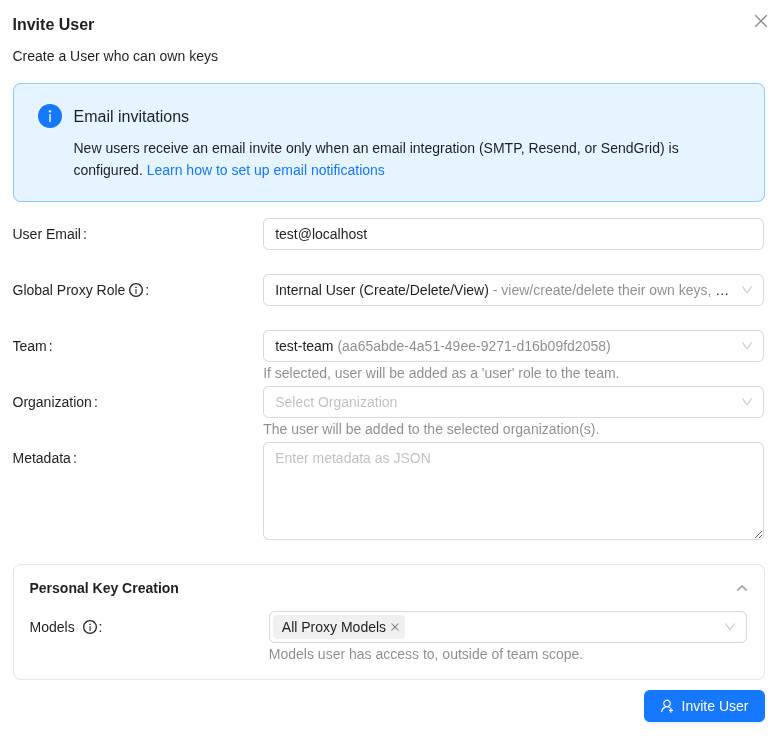
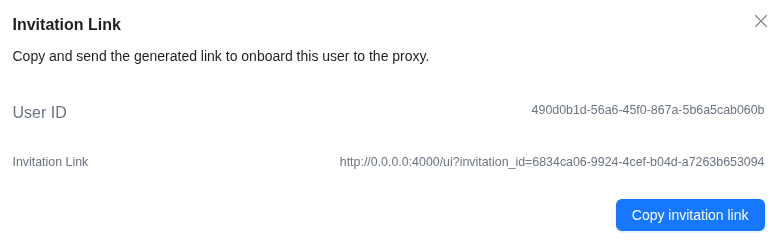
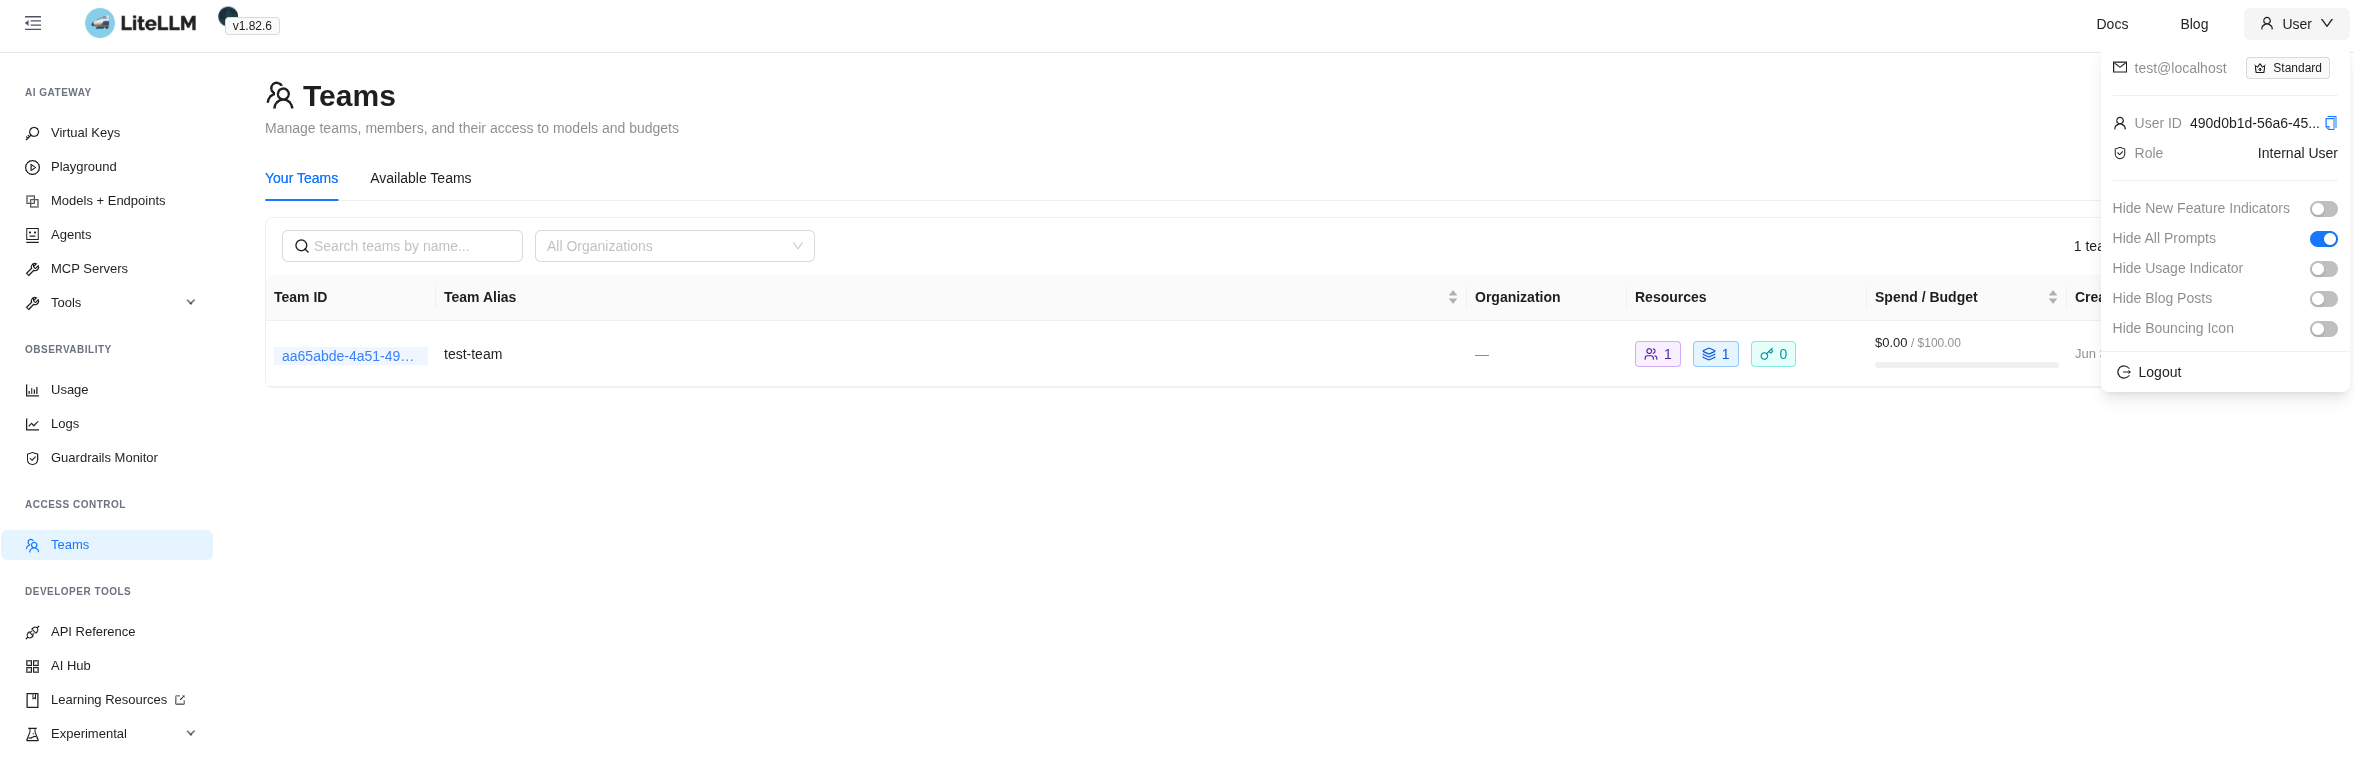
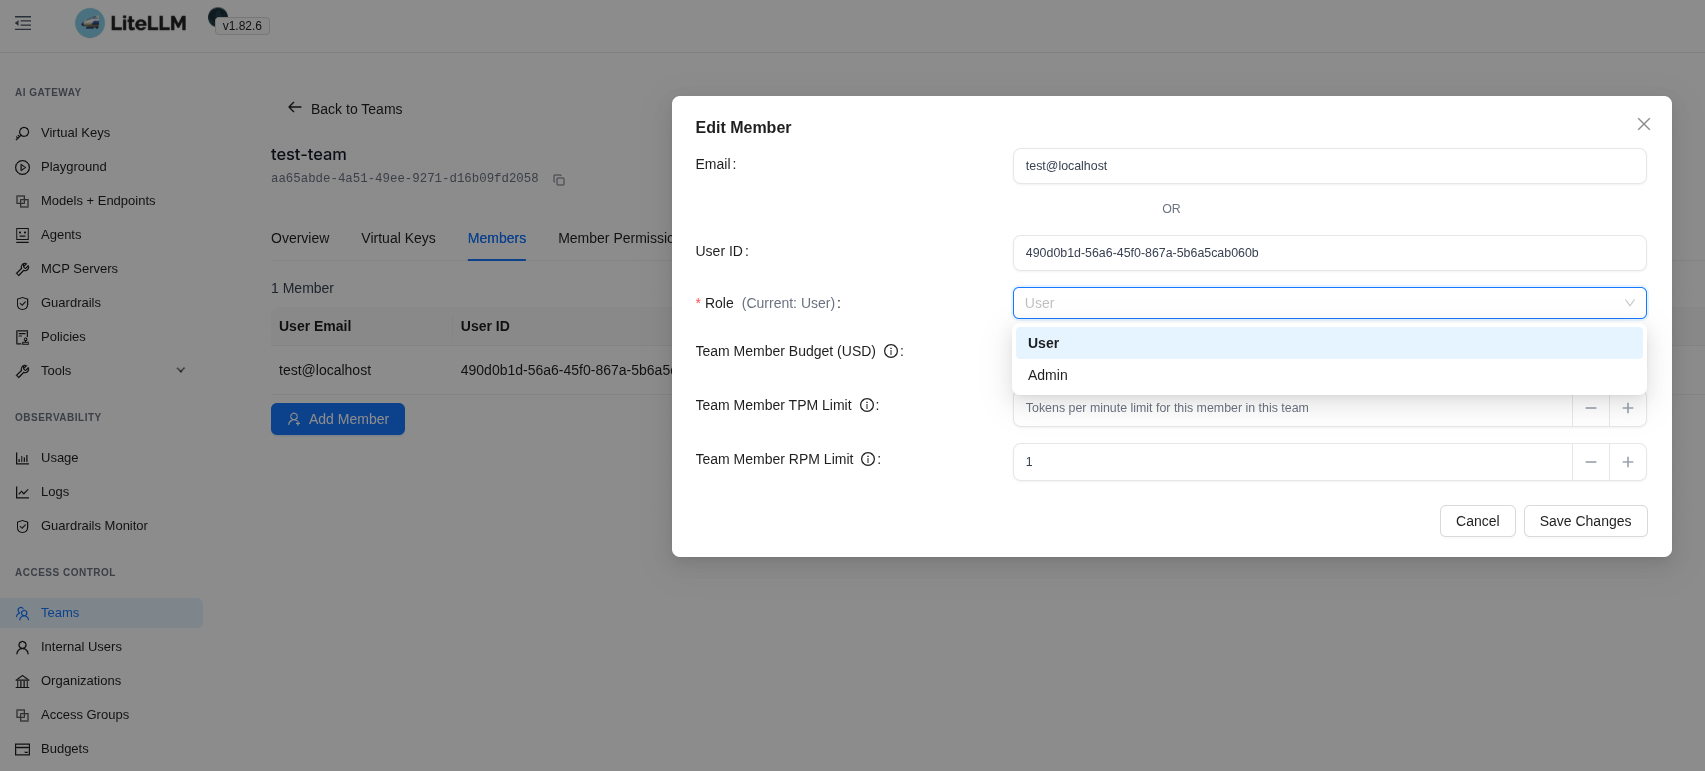
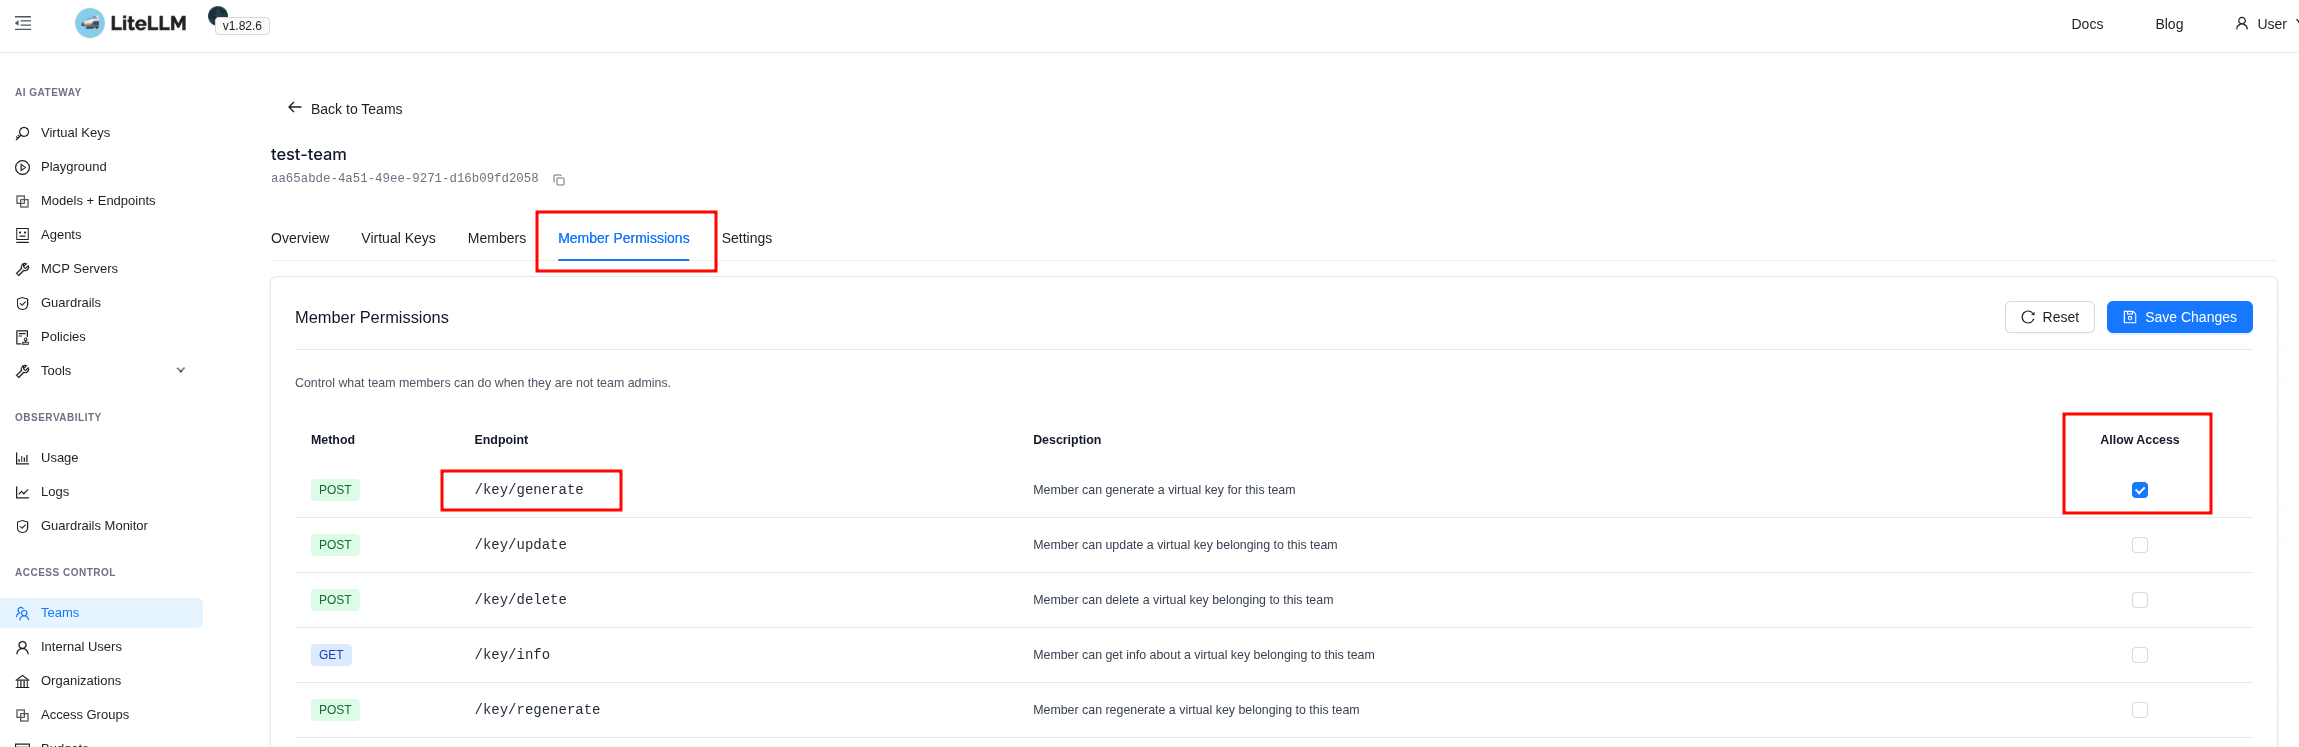
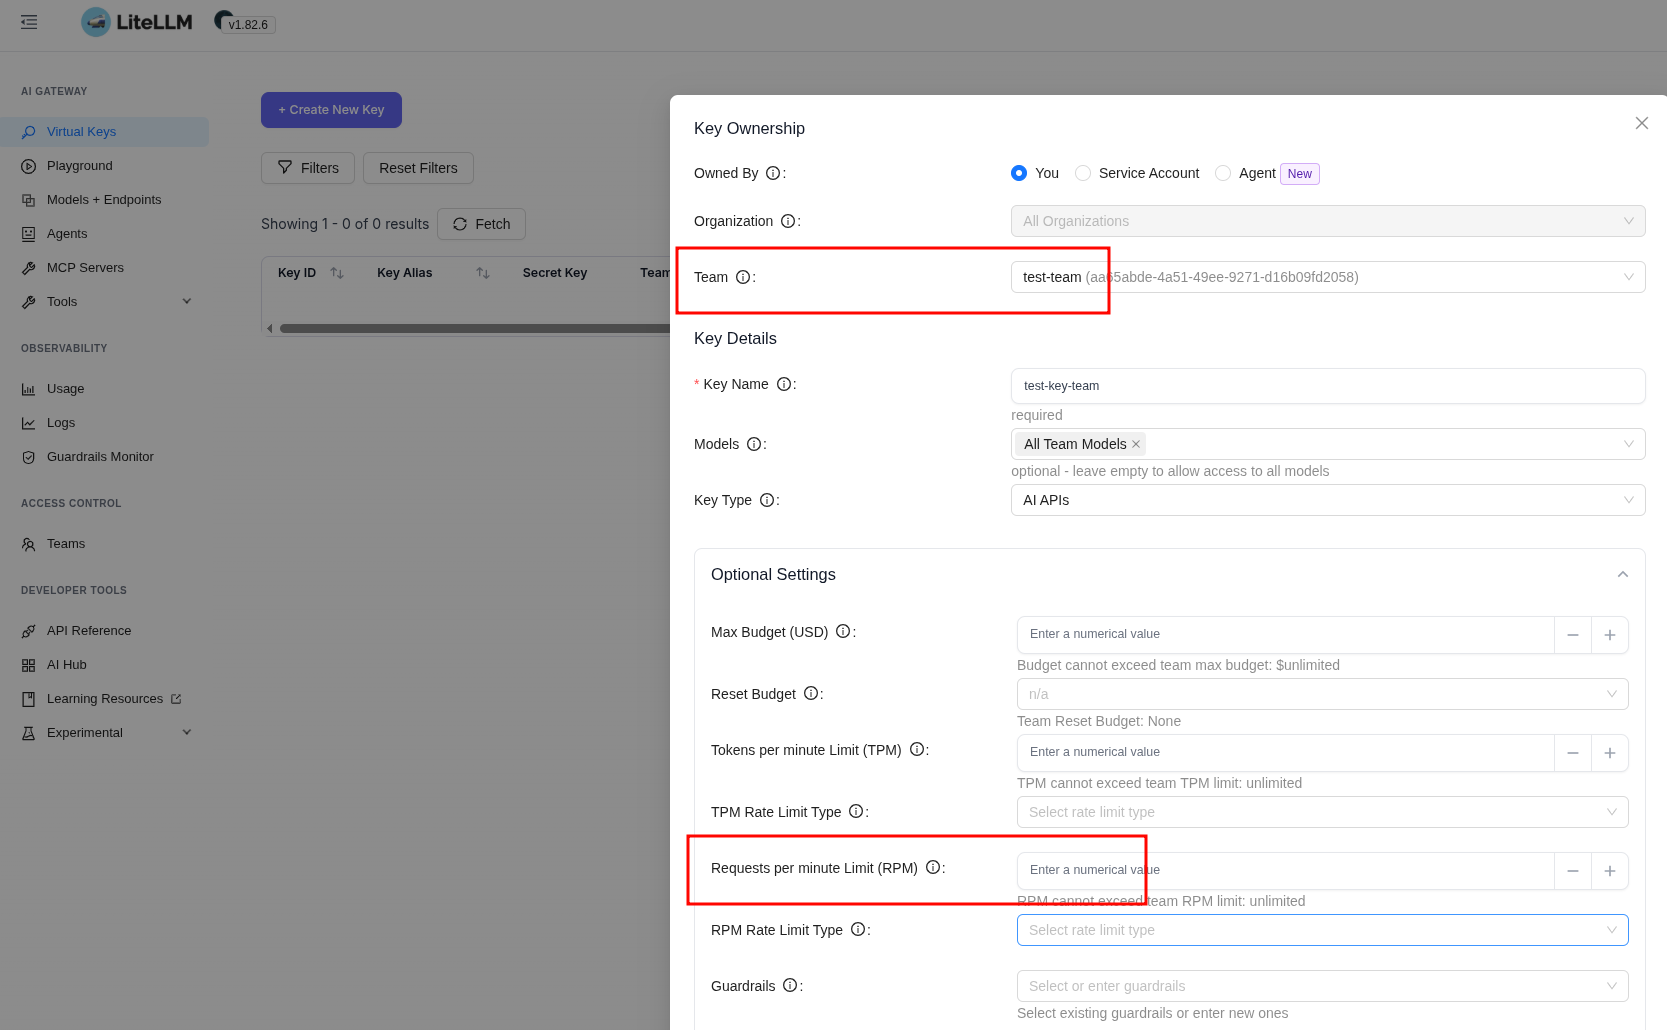
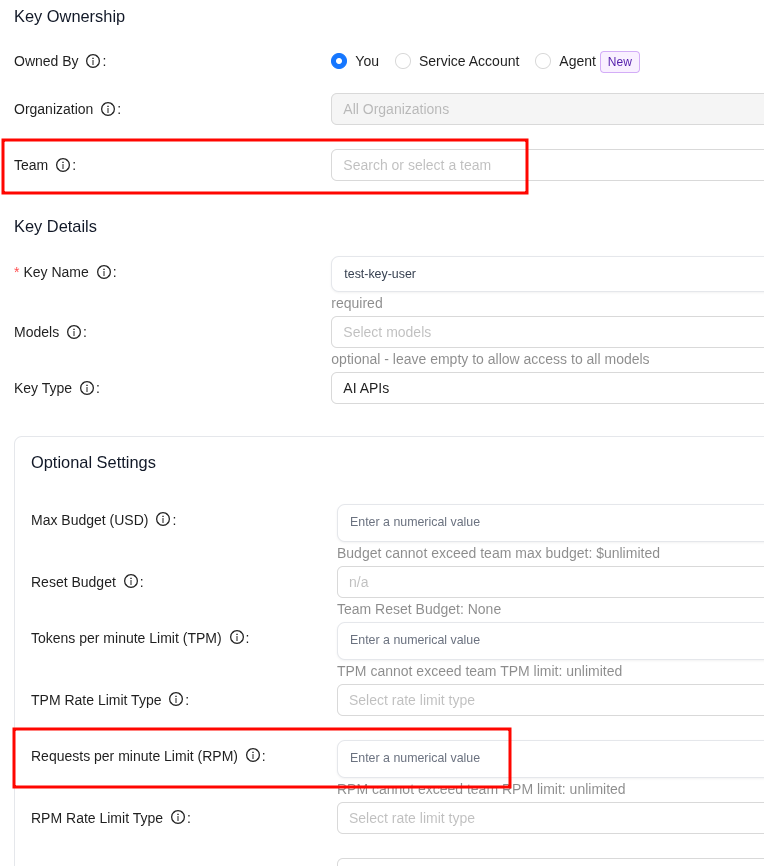
 Пора вже записати собі про MikroTik та Users Management – бо пост давно в чернетках лежить, ну і заодно і налаштувати аутентифікацію SSH з ключами.





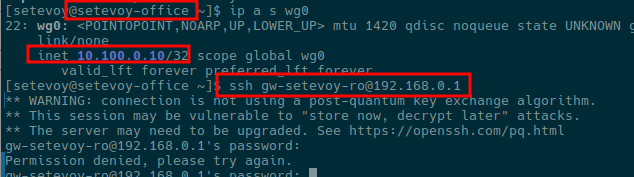
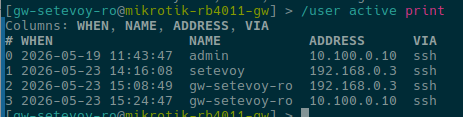


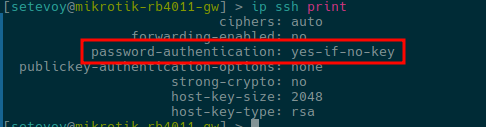
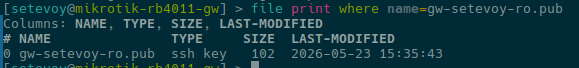

 VictoriaTraces – як і VictoriaLogs – підтримує Recording Rules (див.
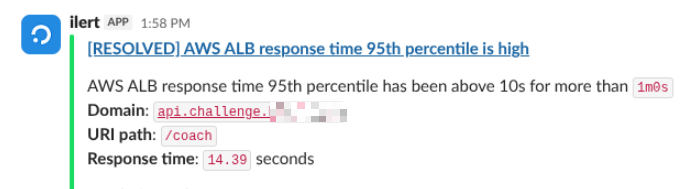
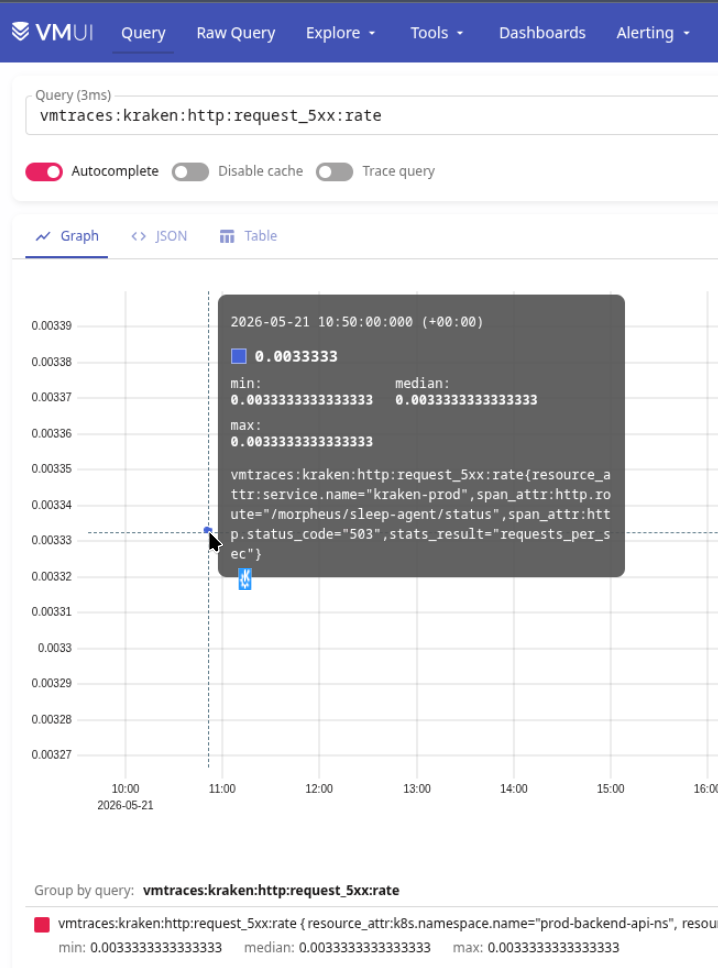
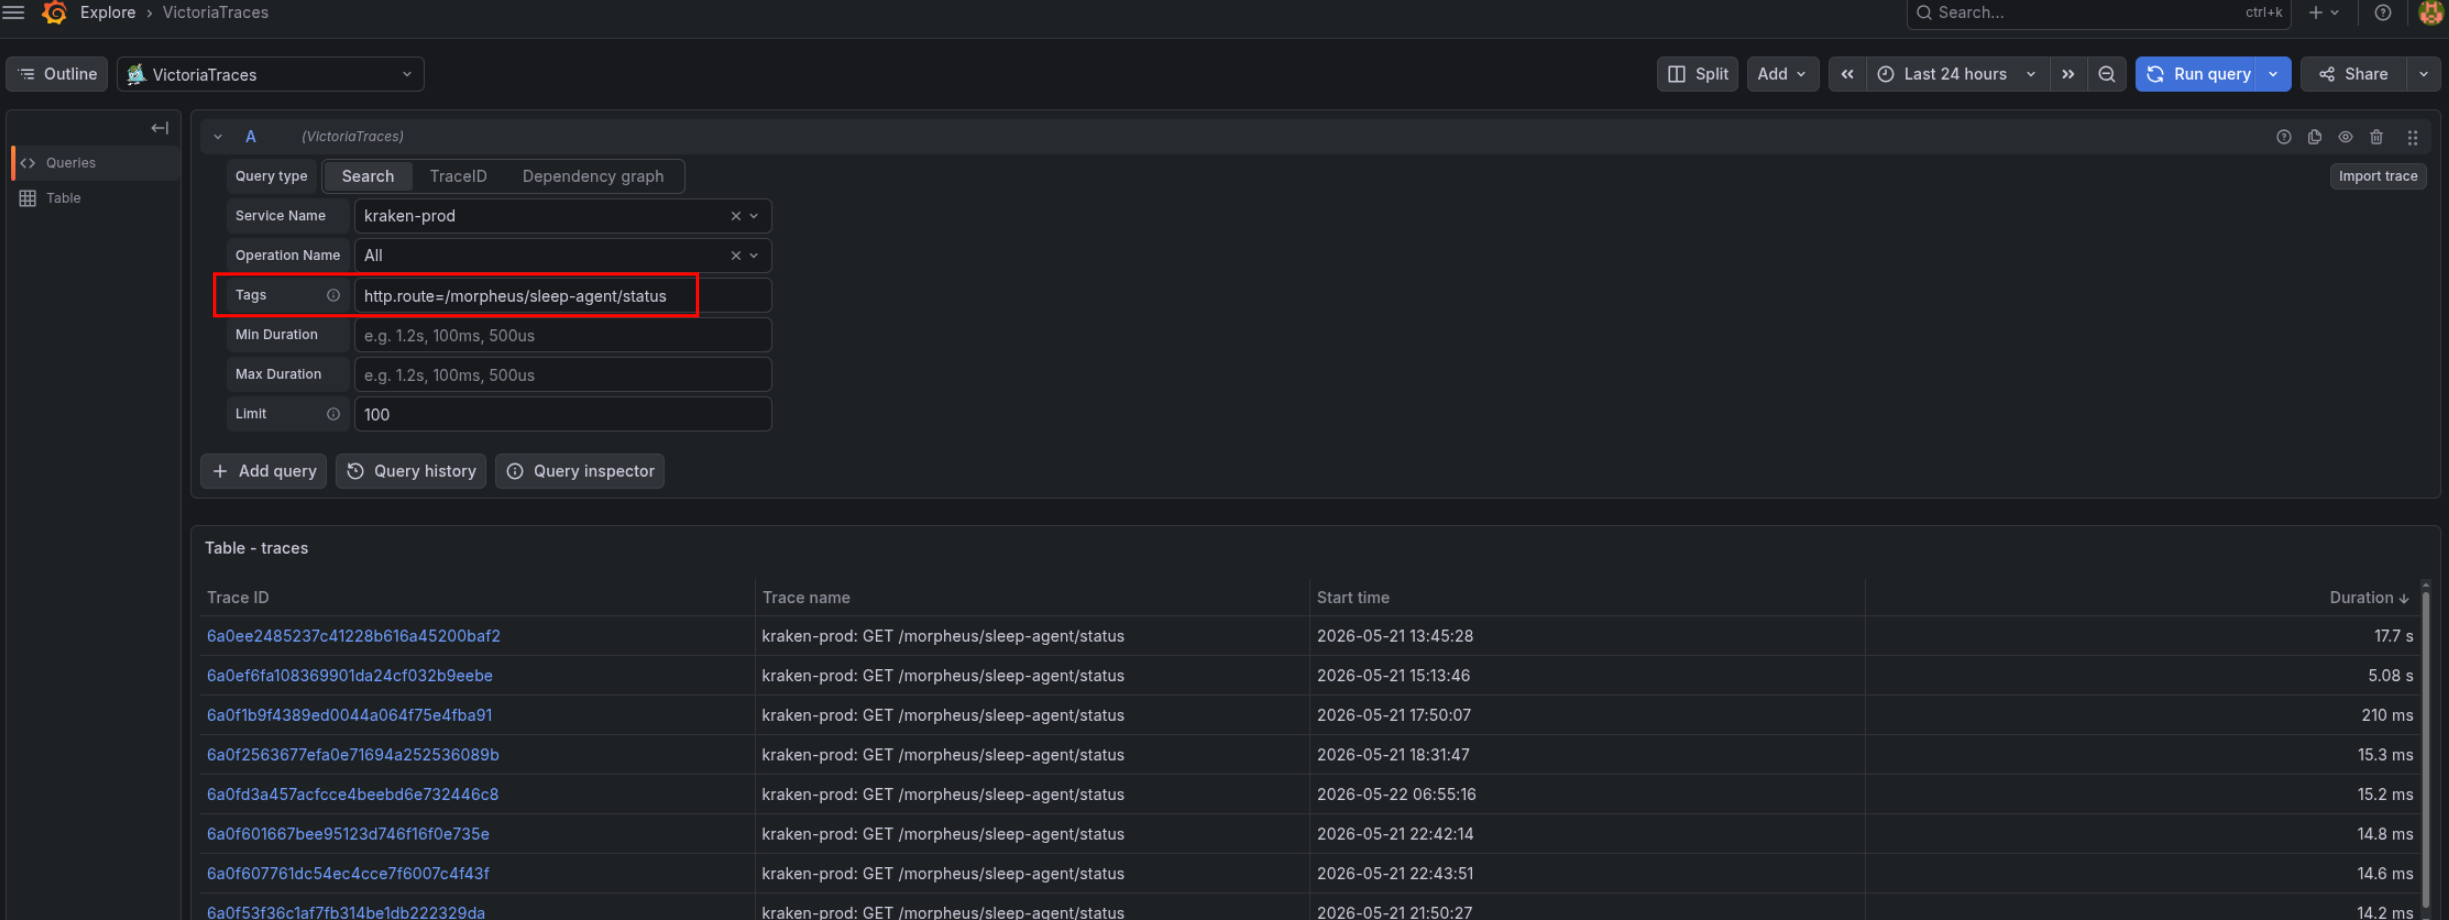
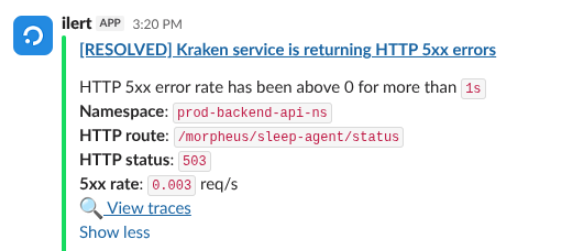
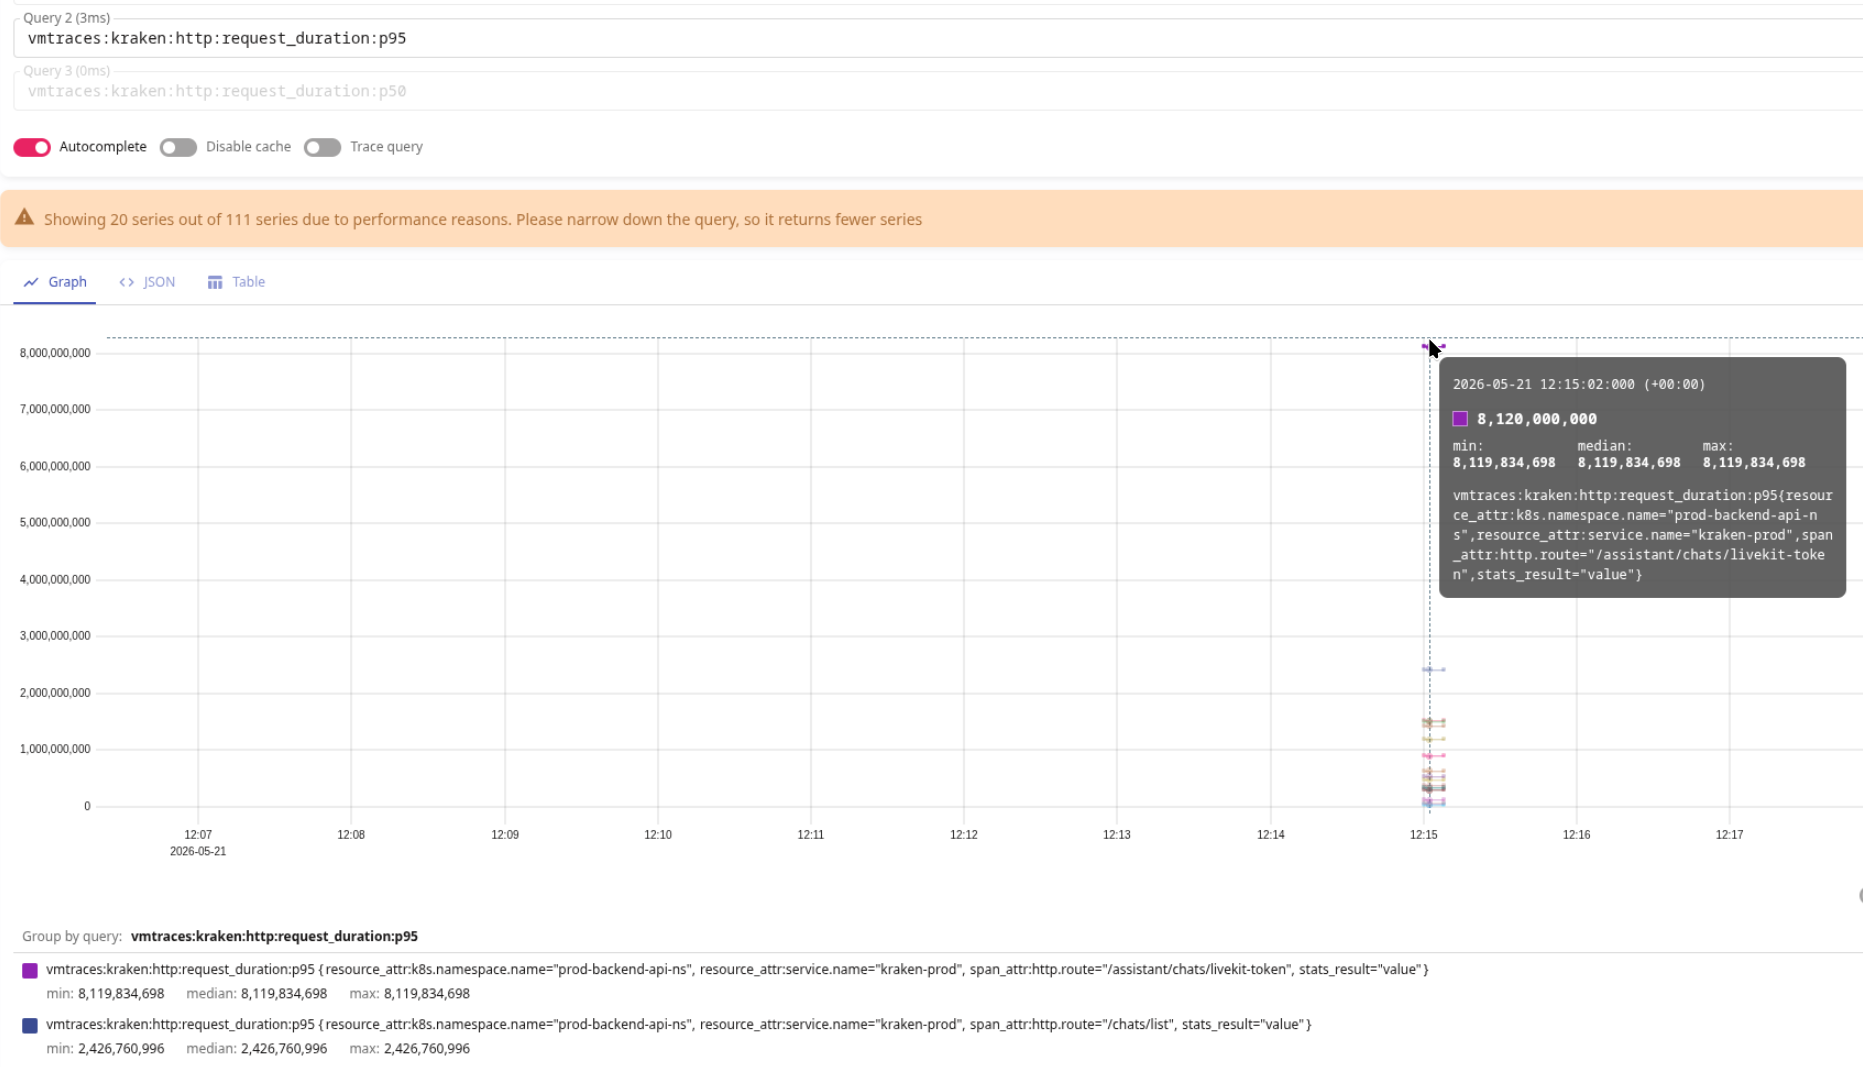
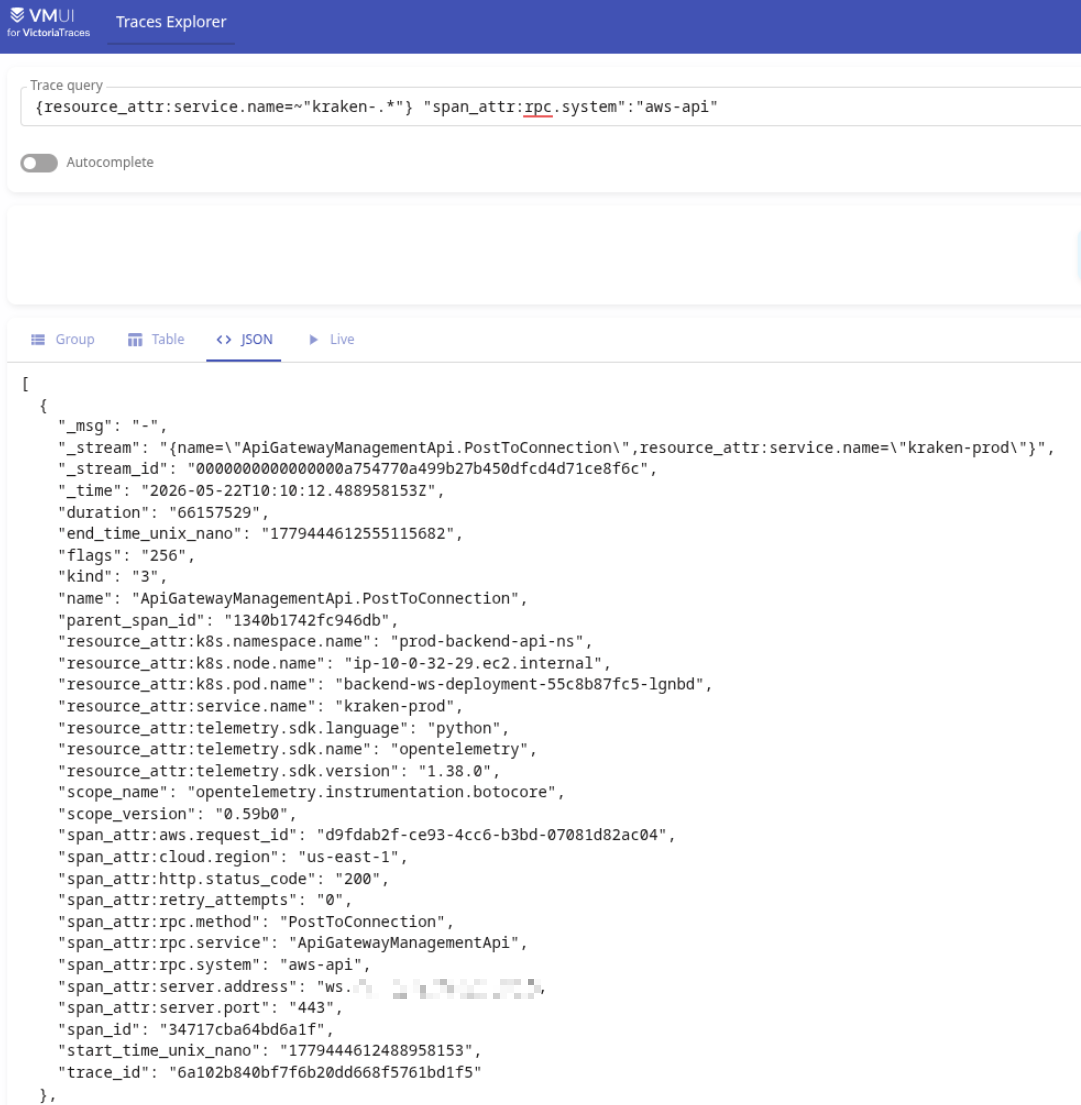
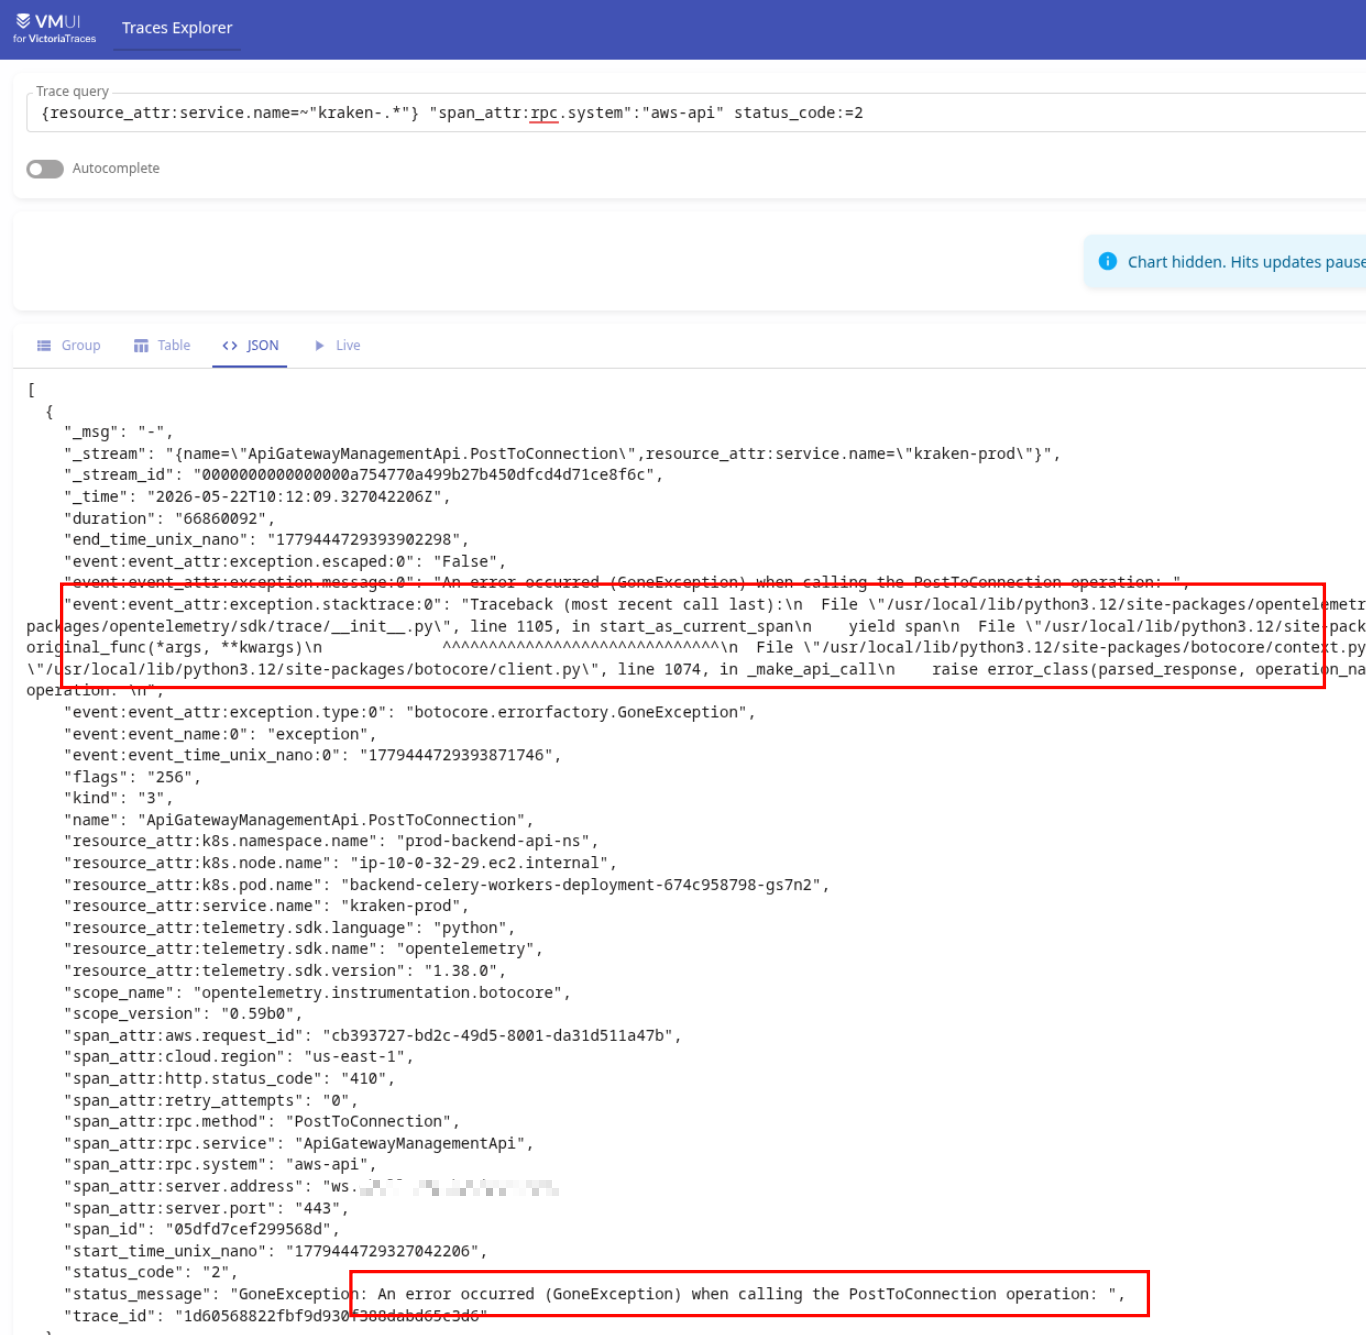
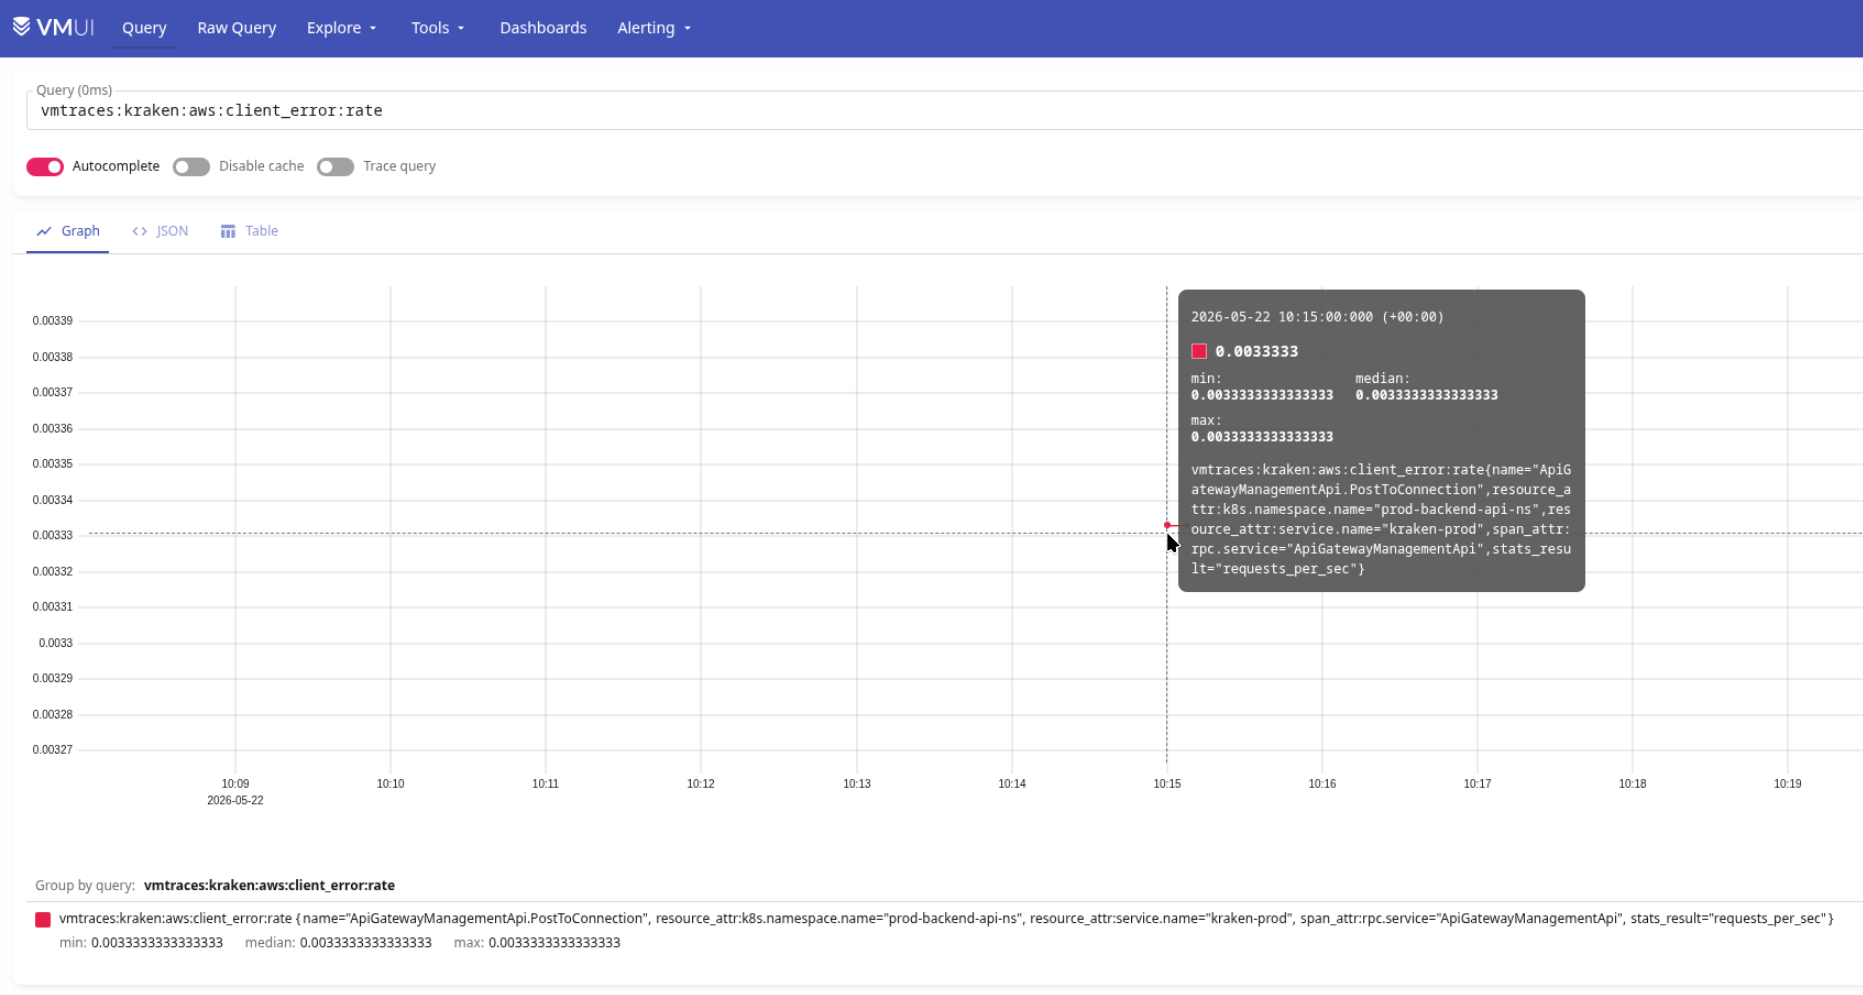
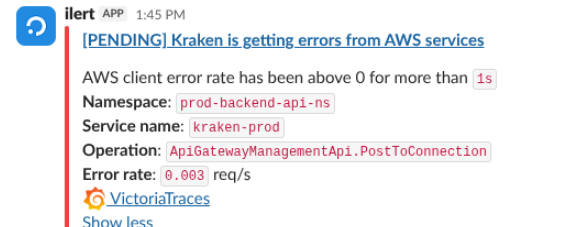
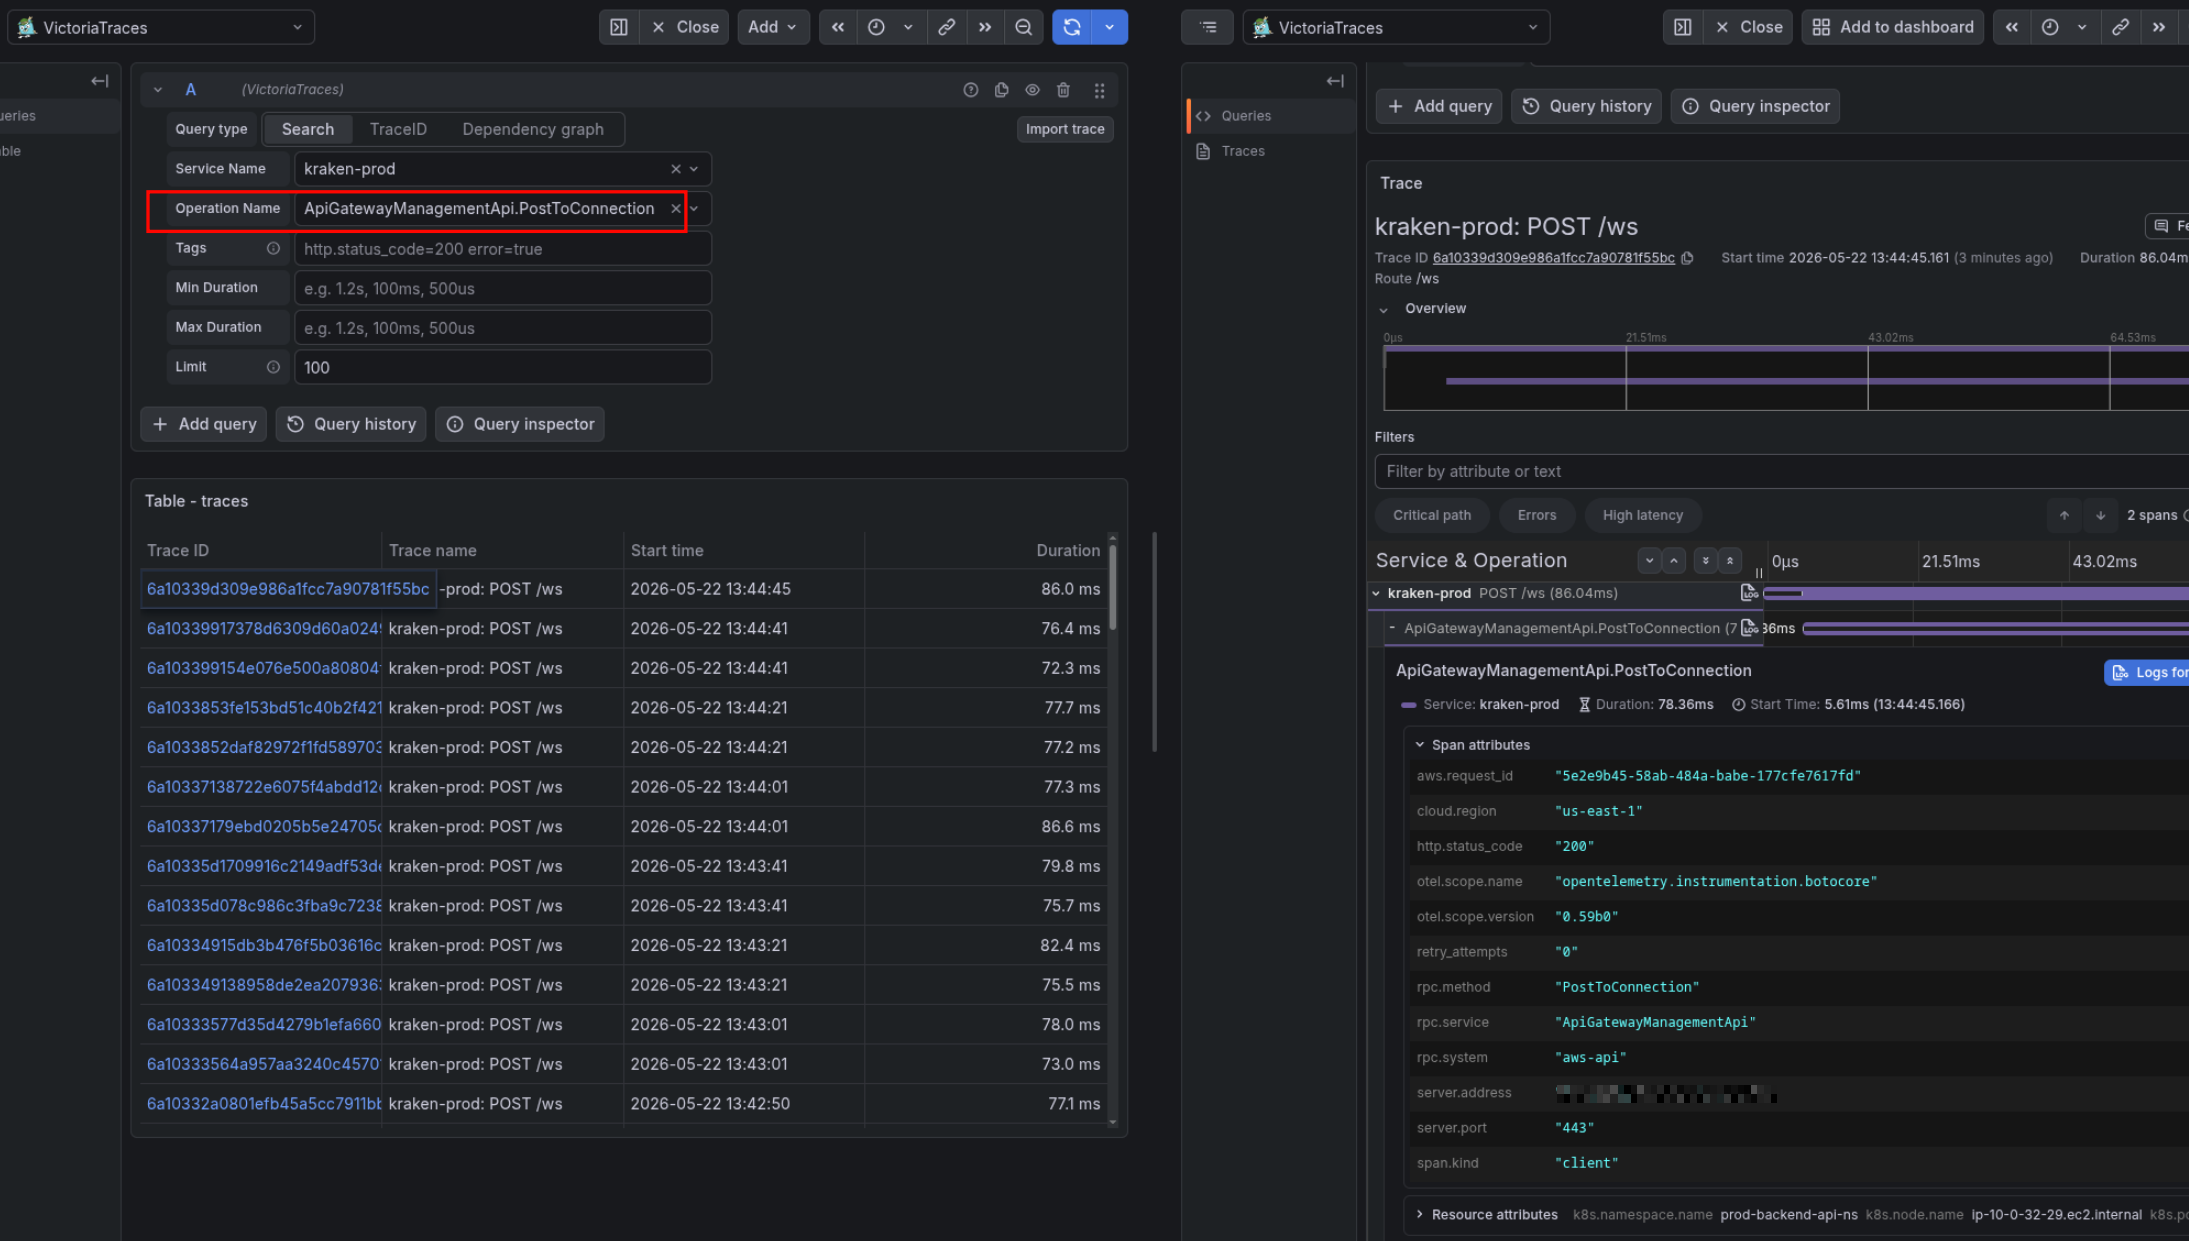
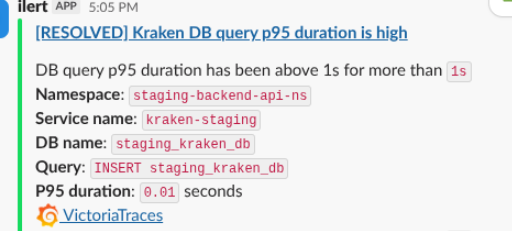
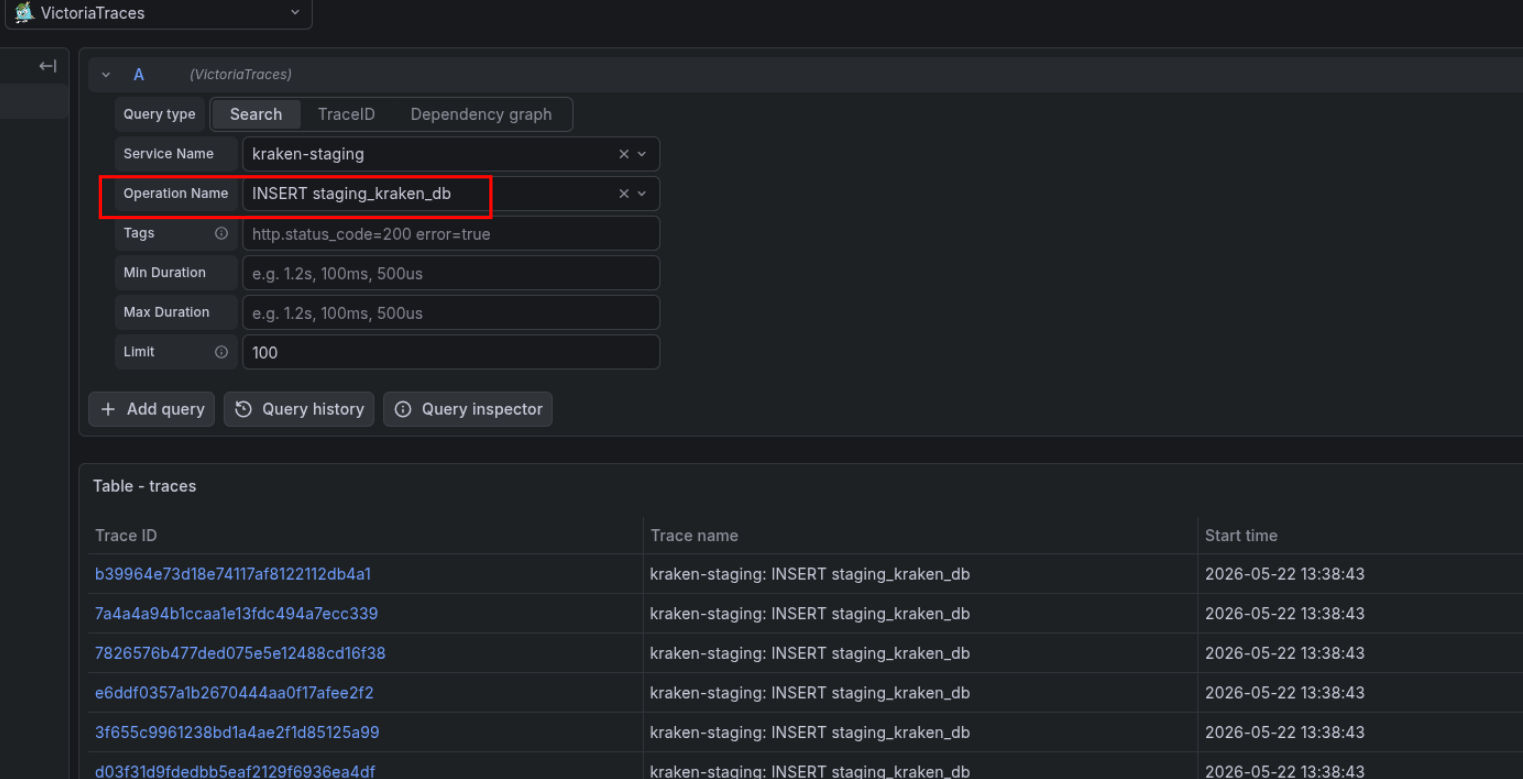
 Давно гемороївся з проблемою доступу до AWS EKS із офісу – нарешті психанув, і розібрався 🙂
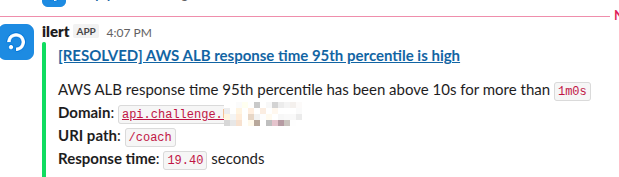
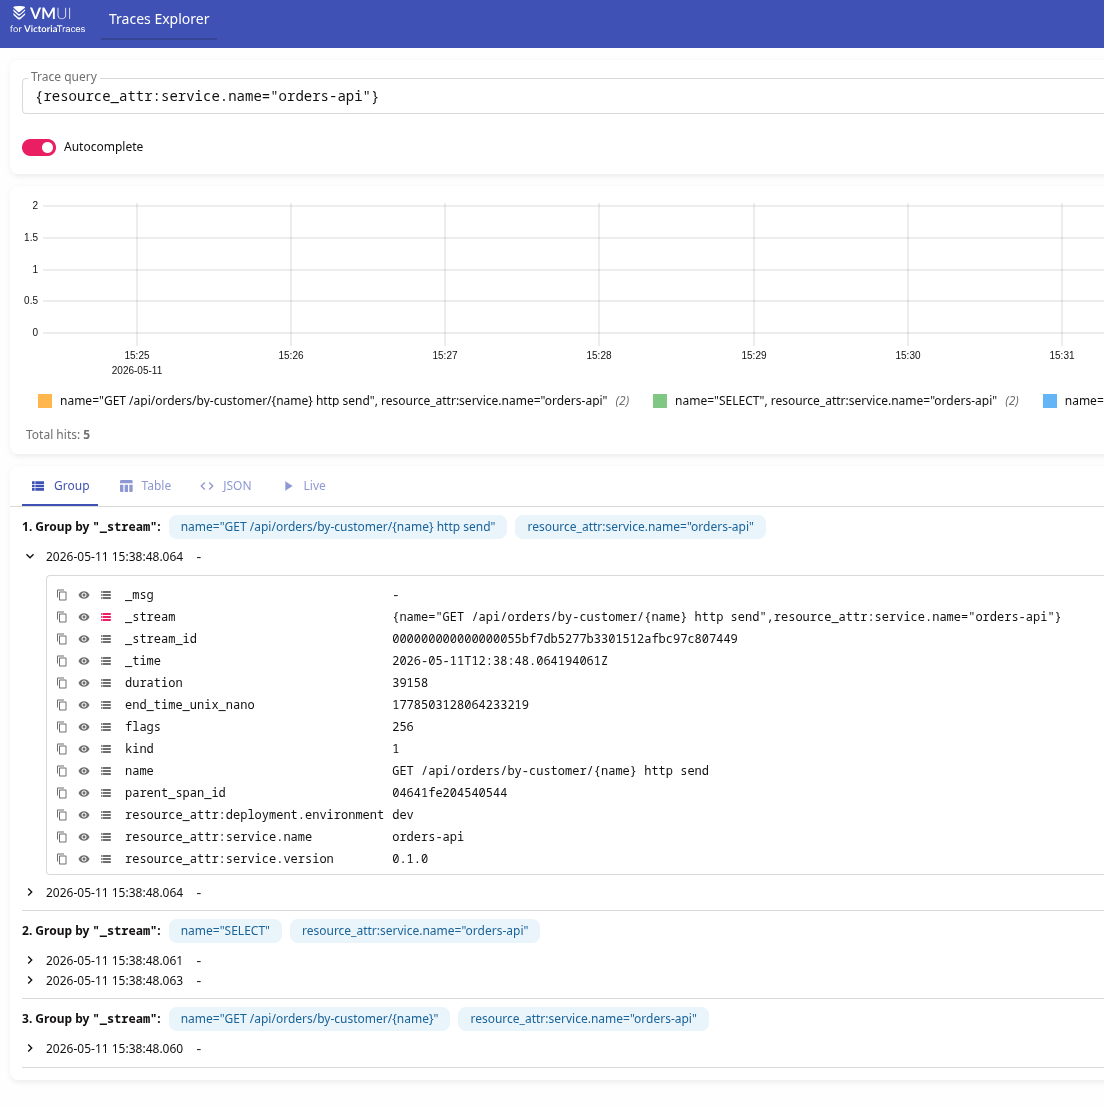
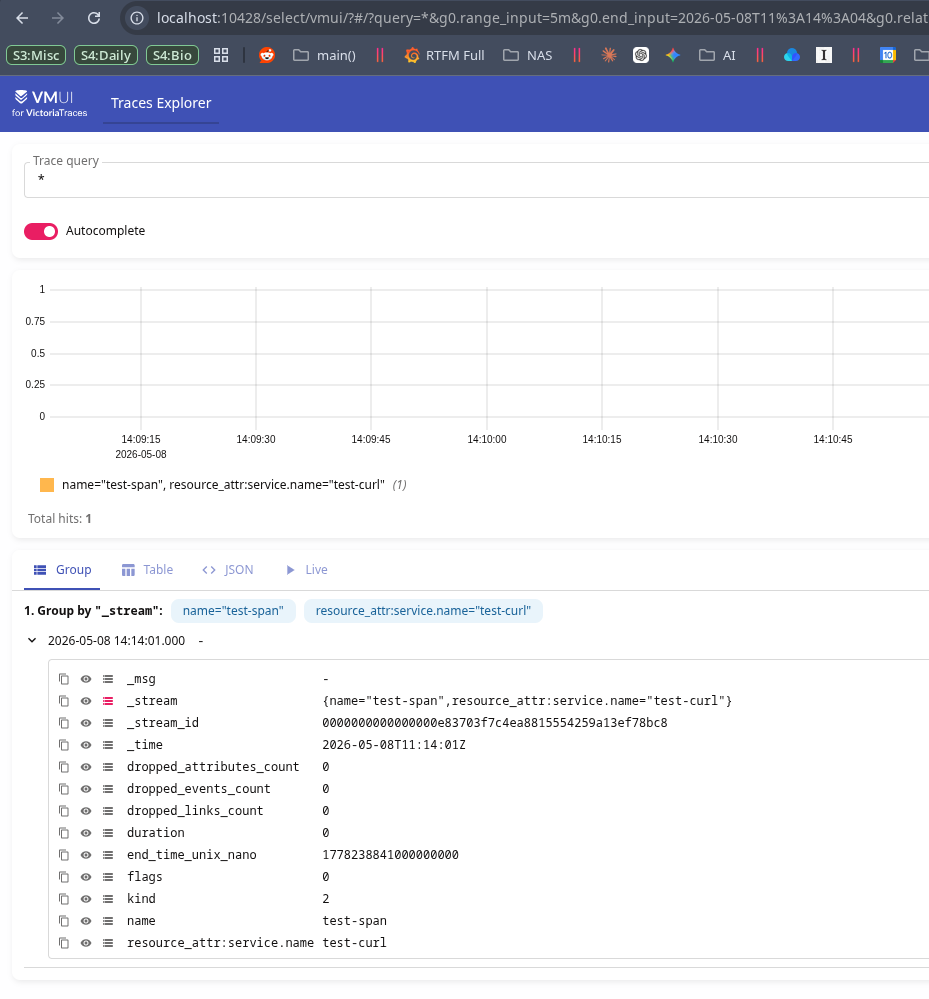
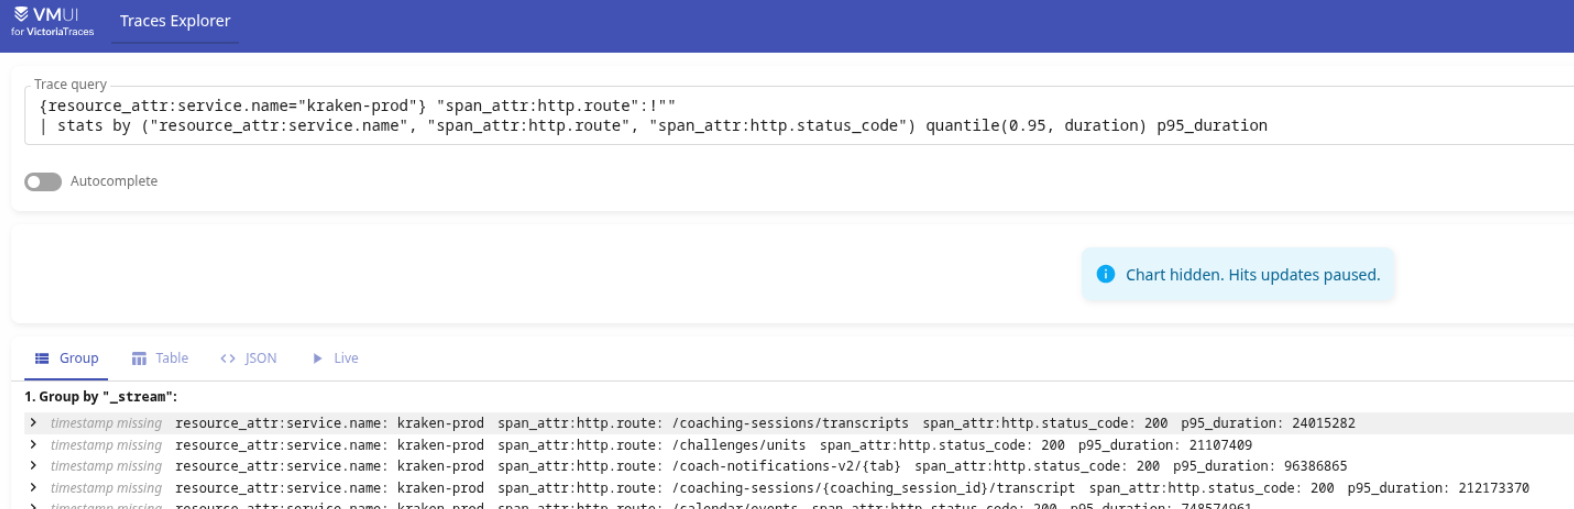
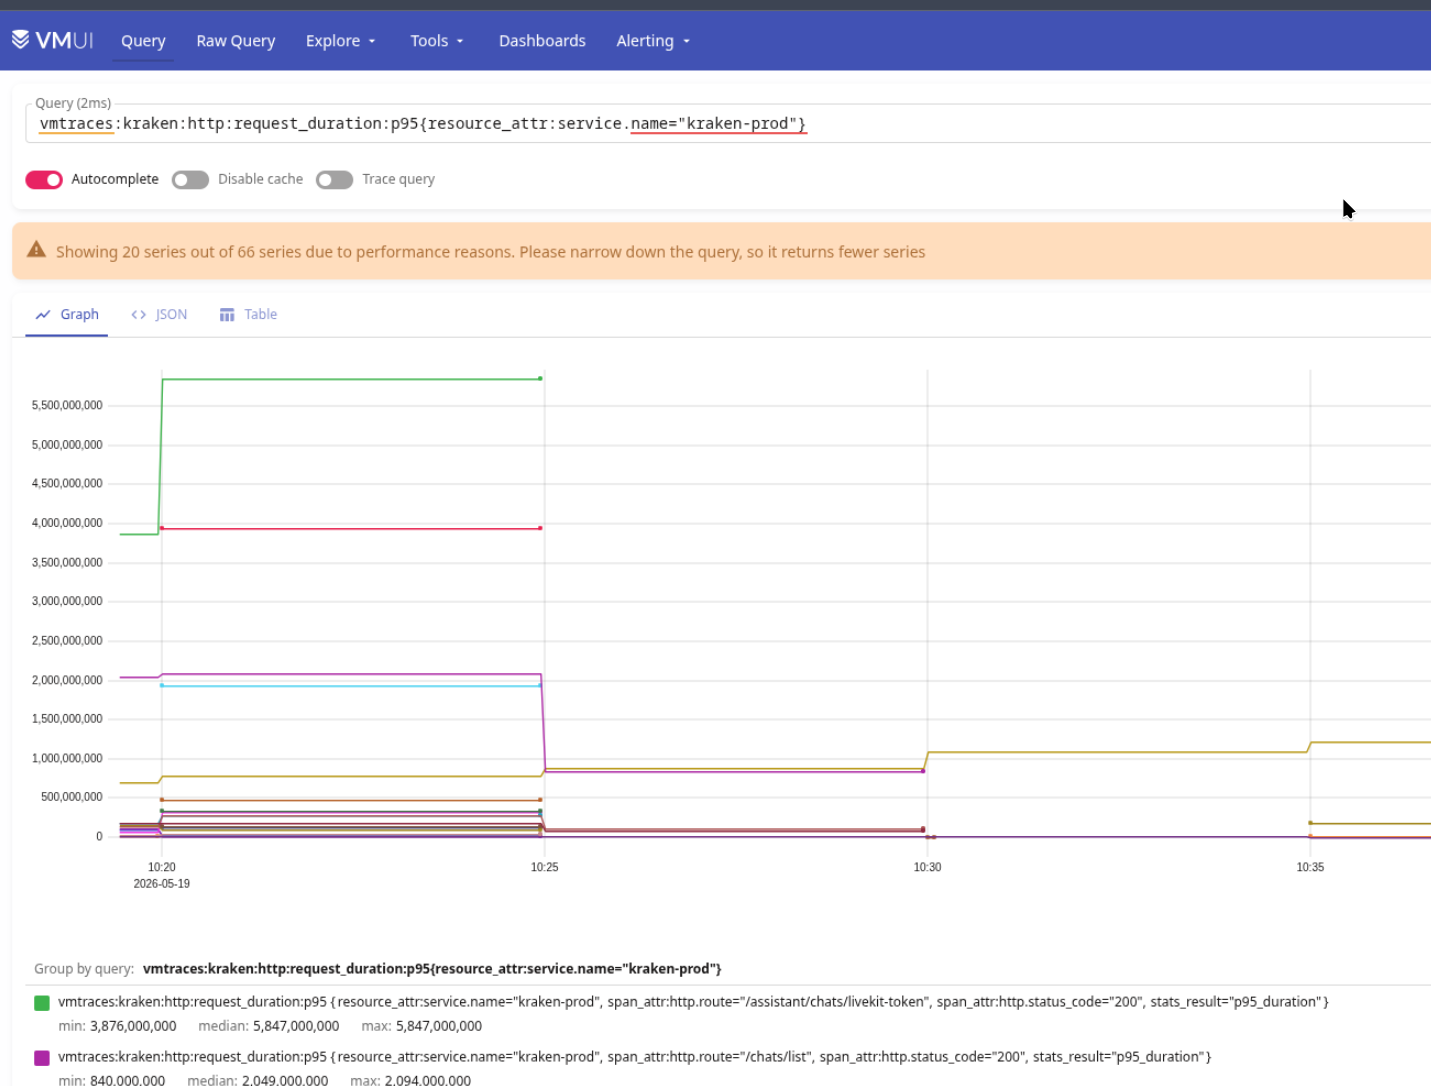
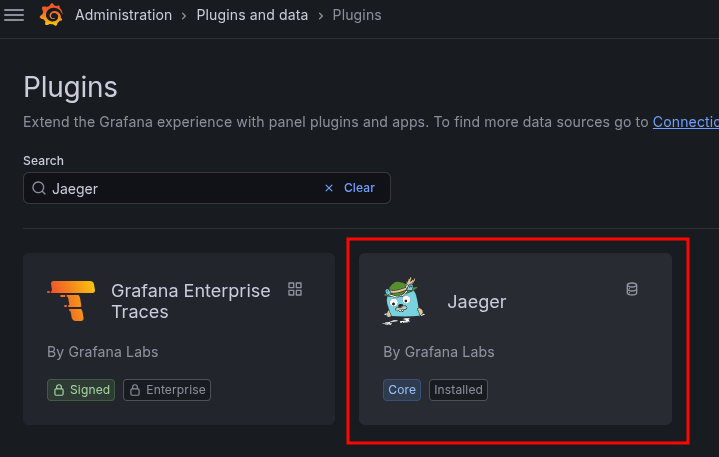
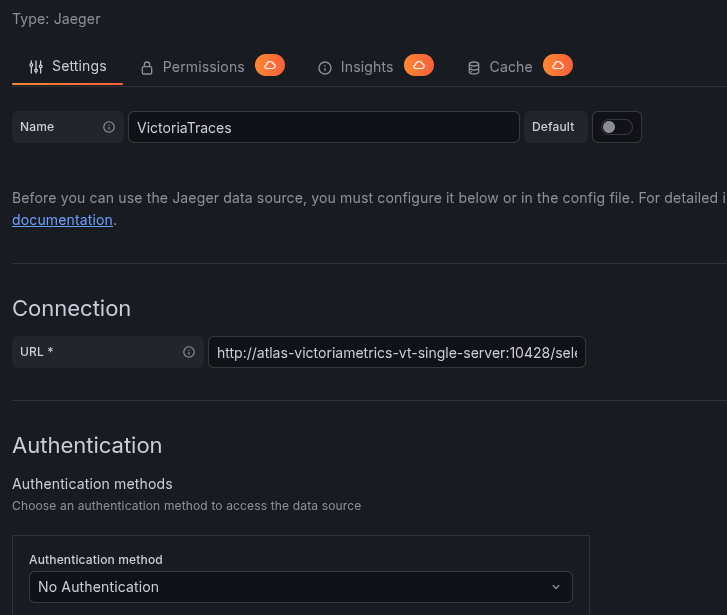
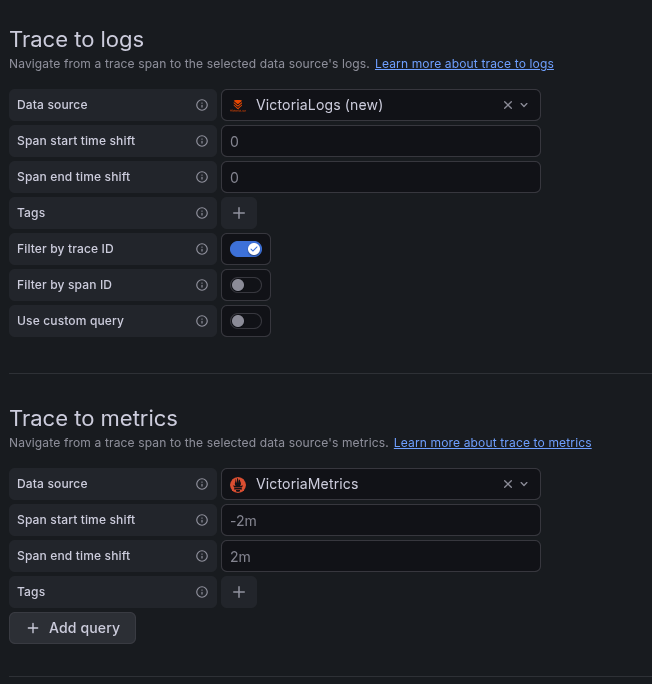
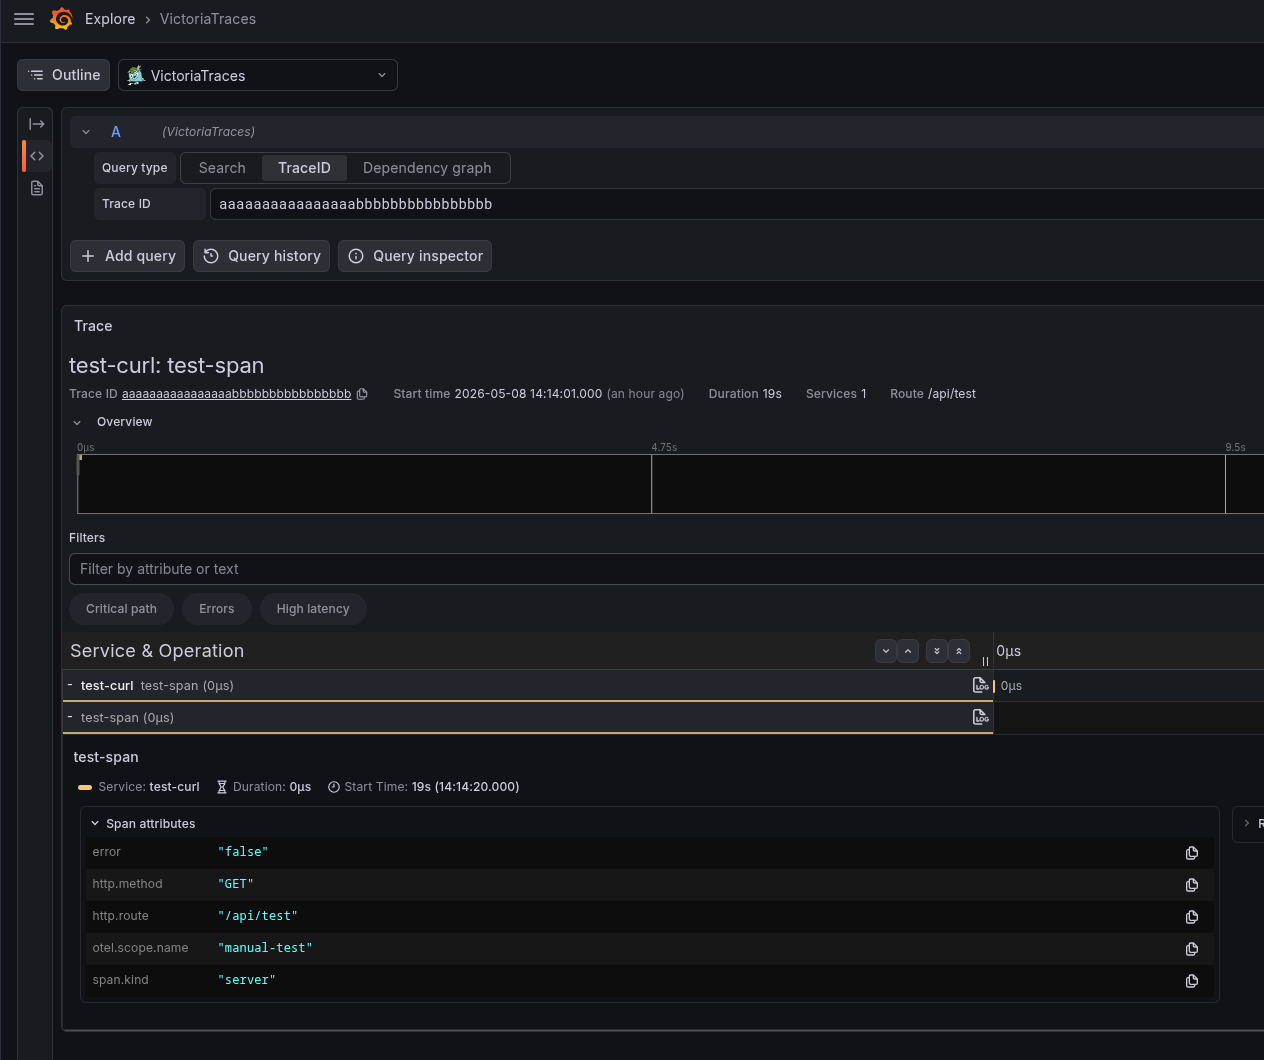
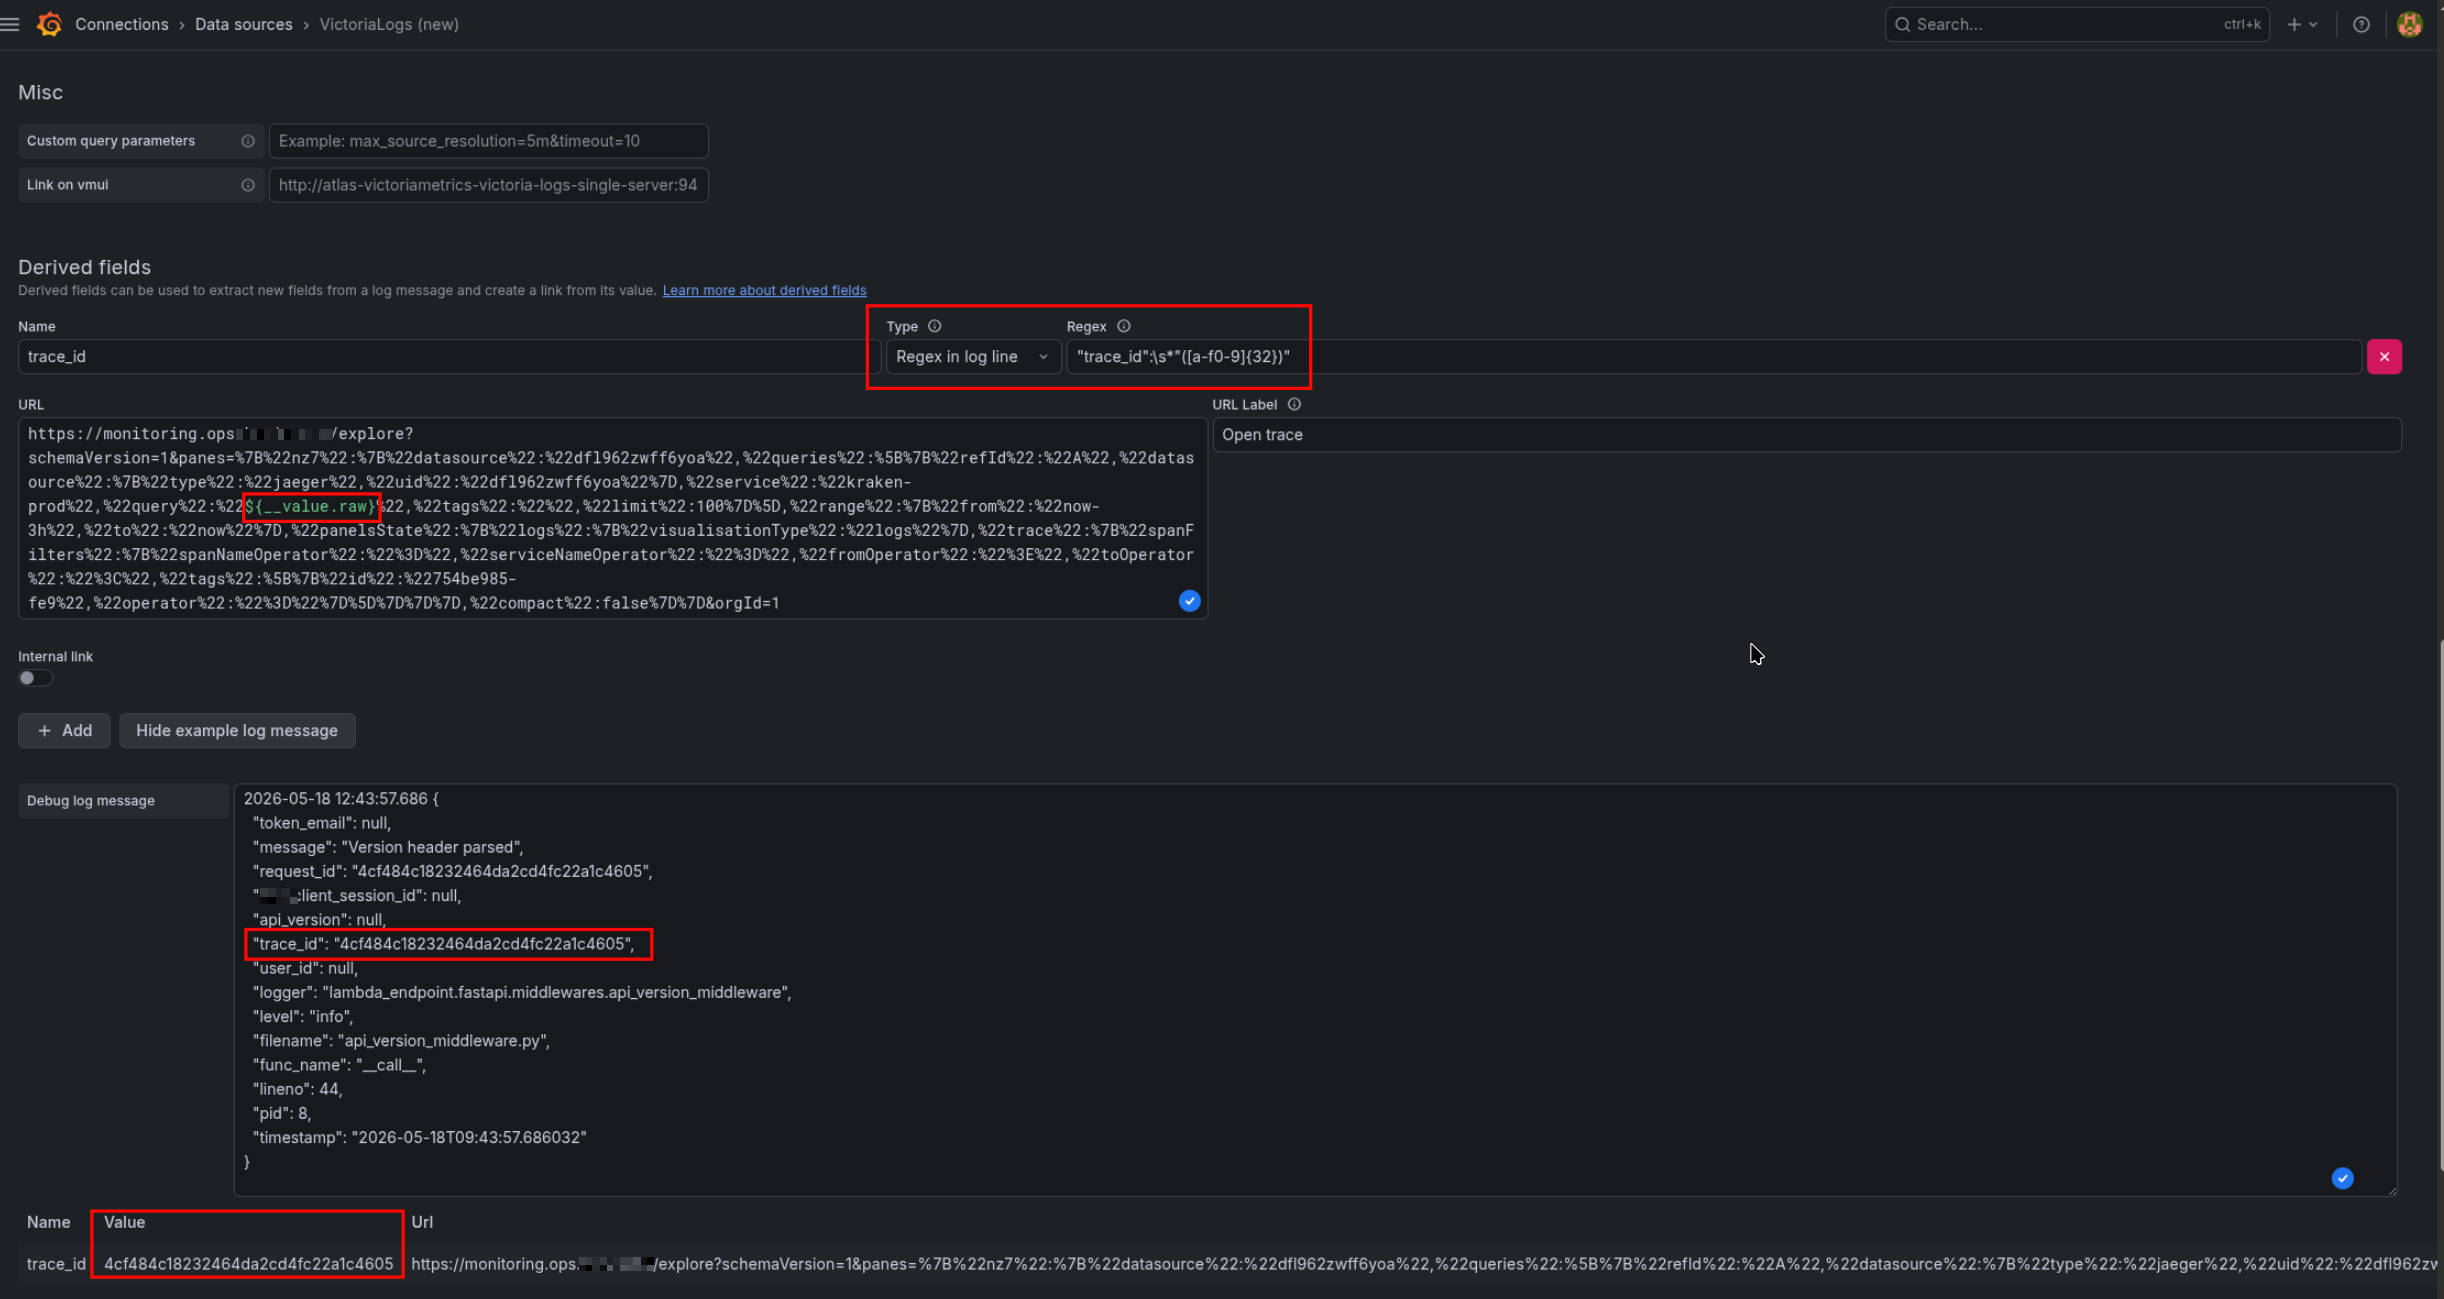
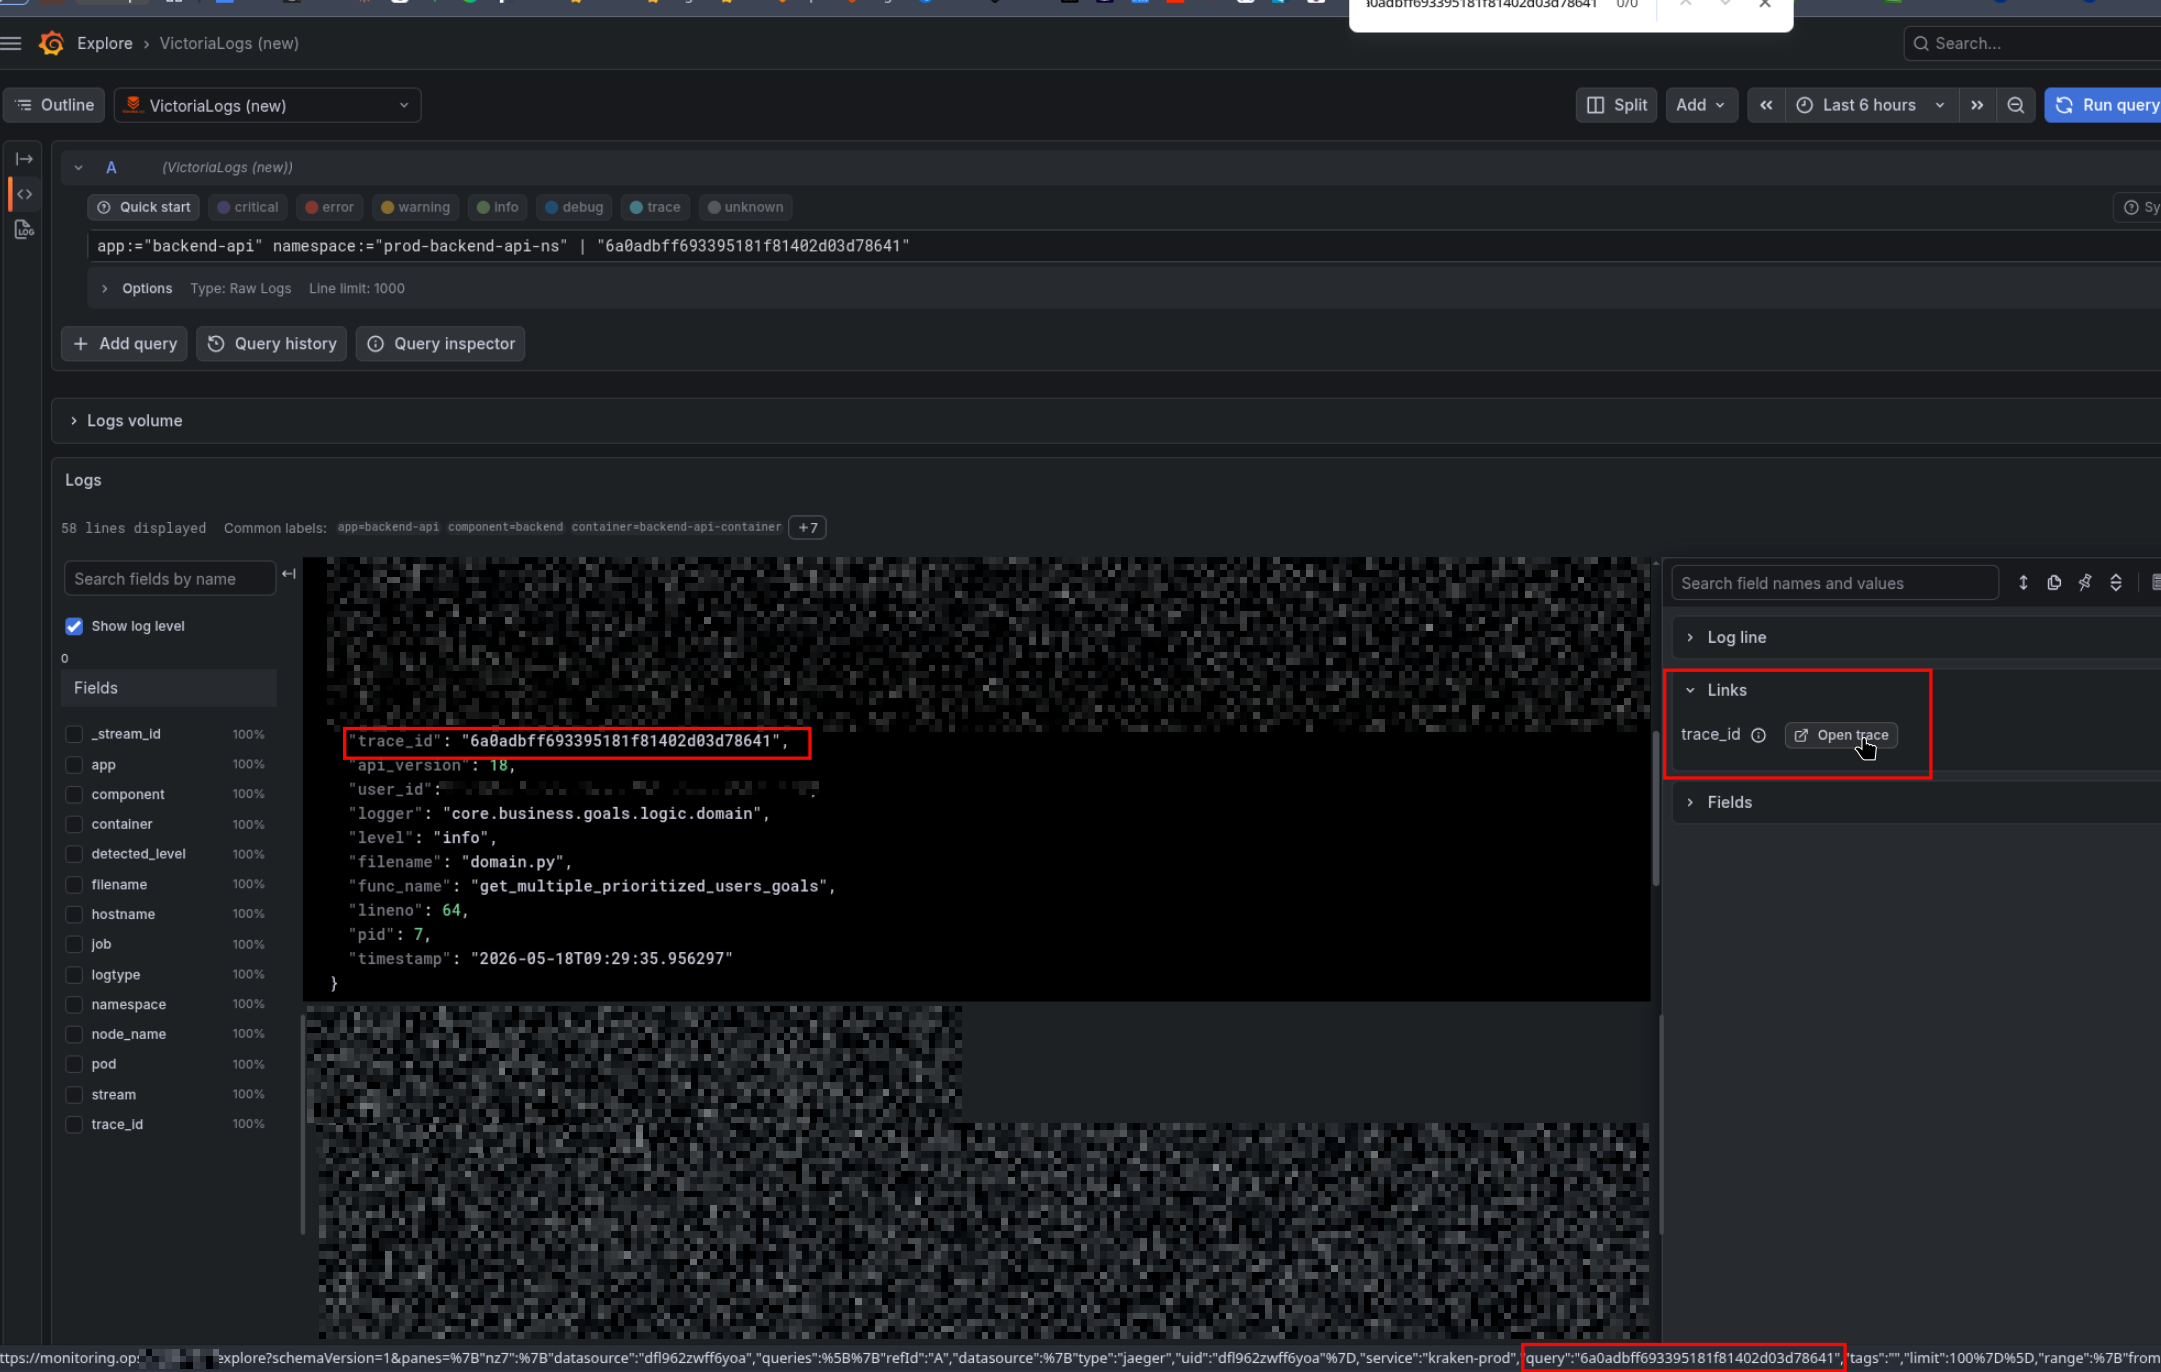
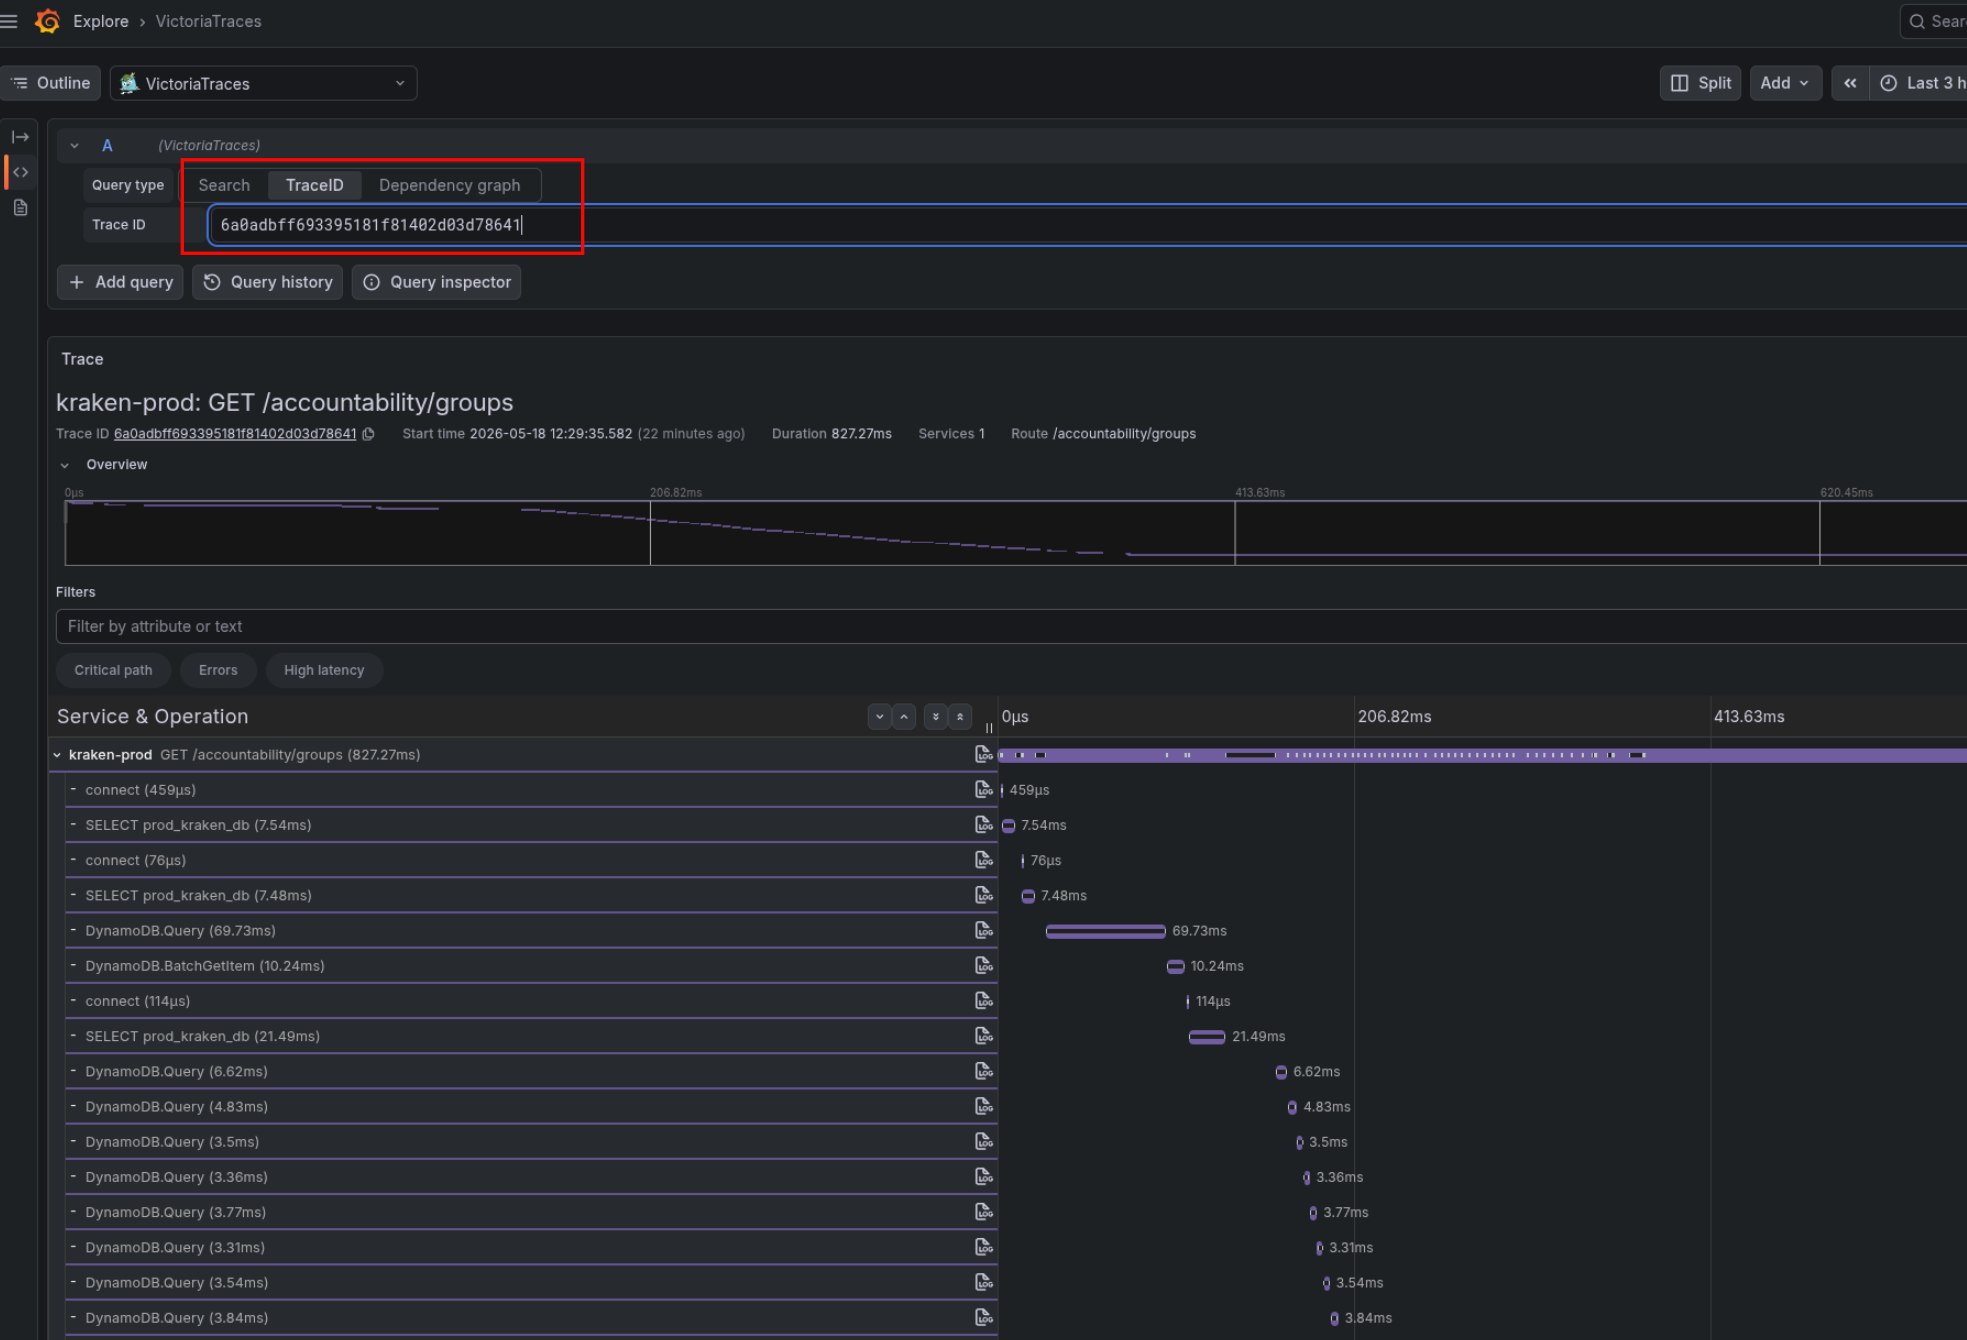
 Сьогодні поговоримо про те, як запустити OpenTelemetry в Kubernetes та інтегрувати його з VictoriaMetrics stack – VictoriaMetrics для метрик, VictoriaLogs для логів, та VictoriaTraces для трейсів.
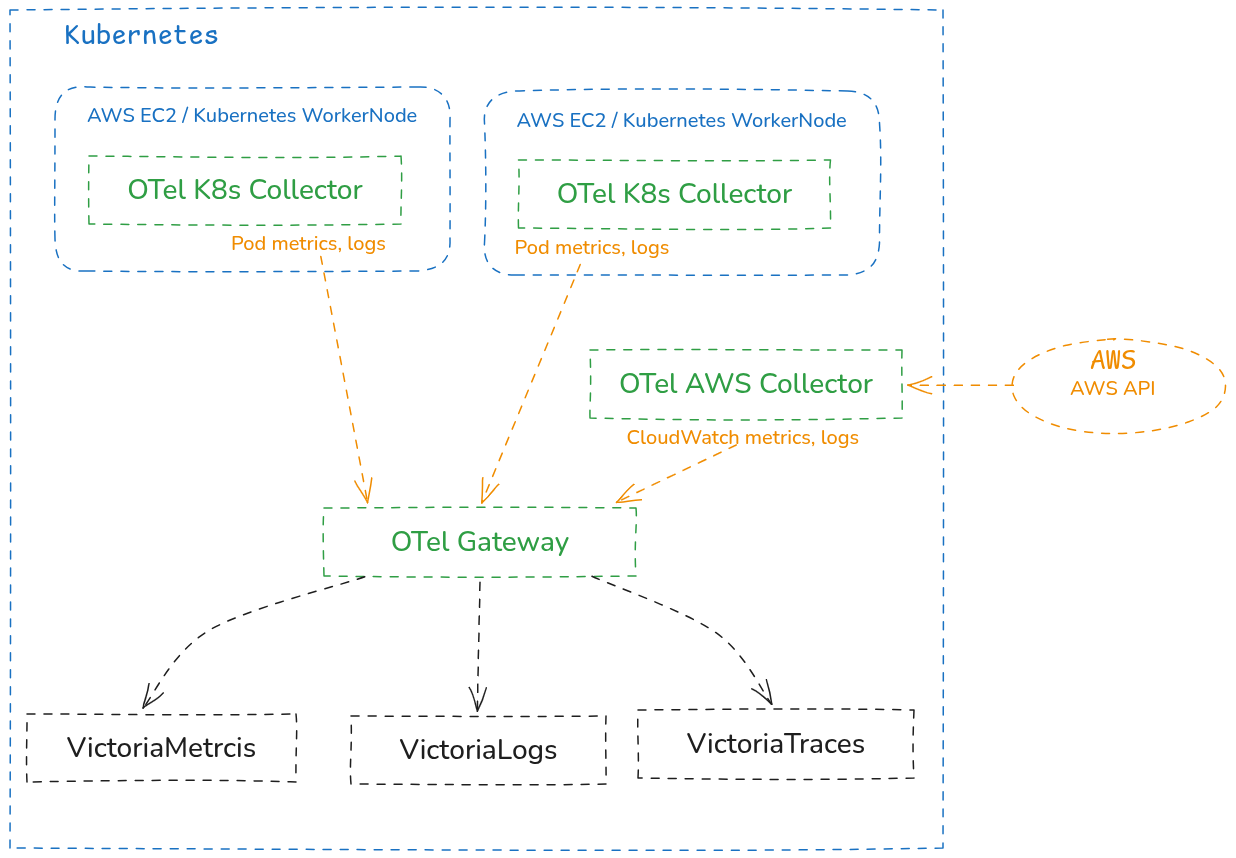
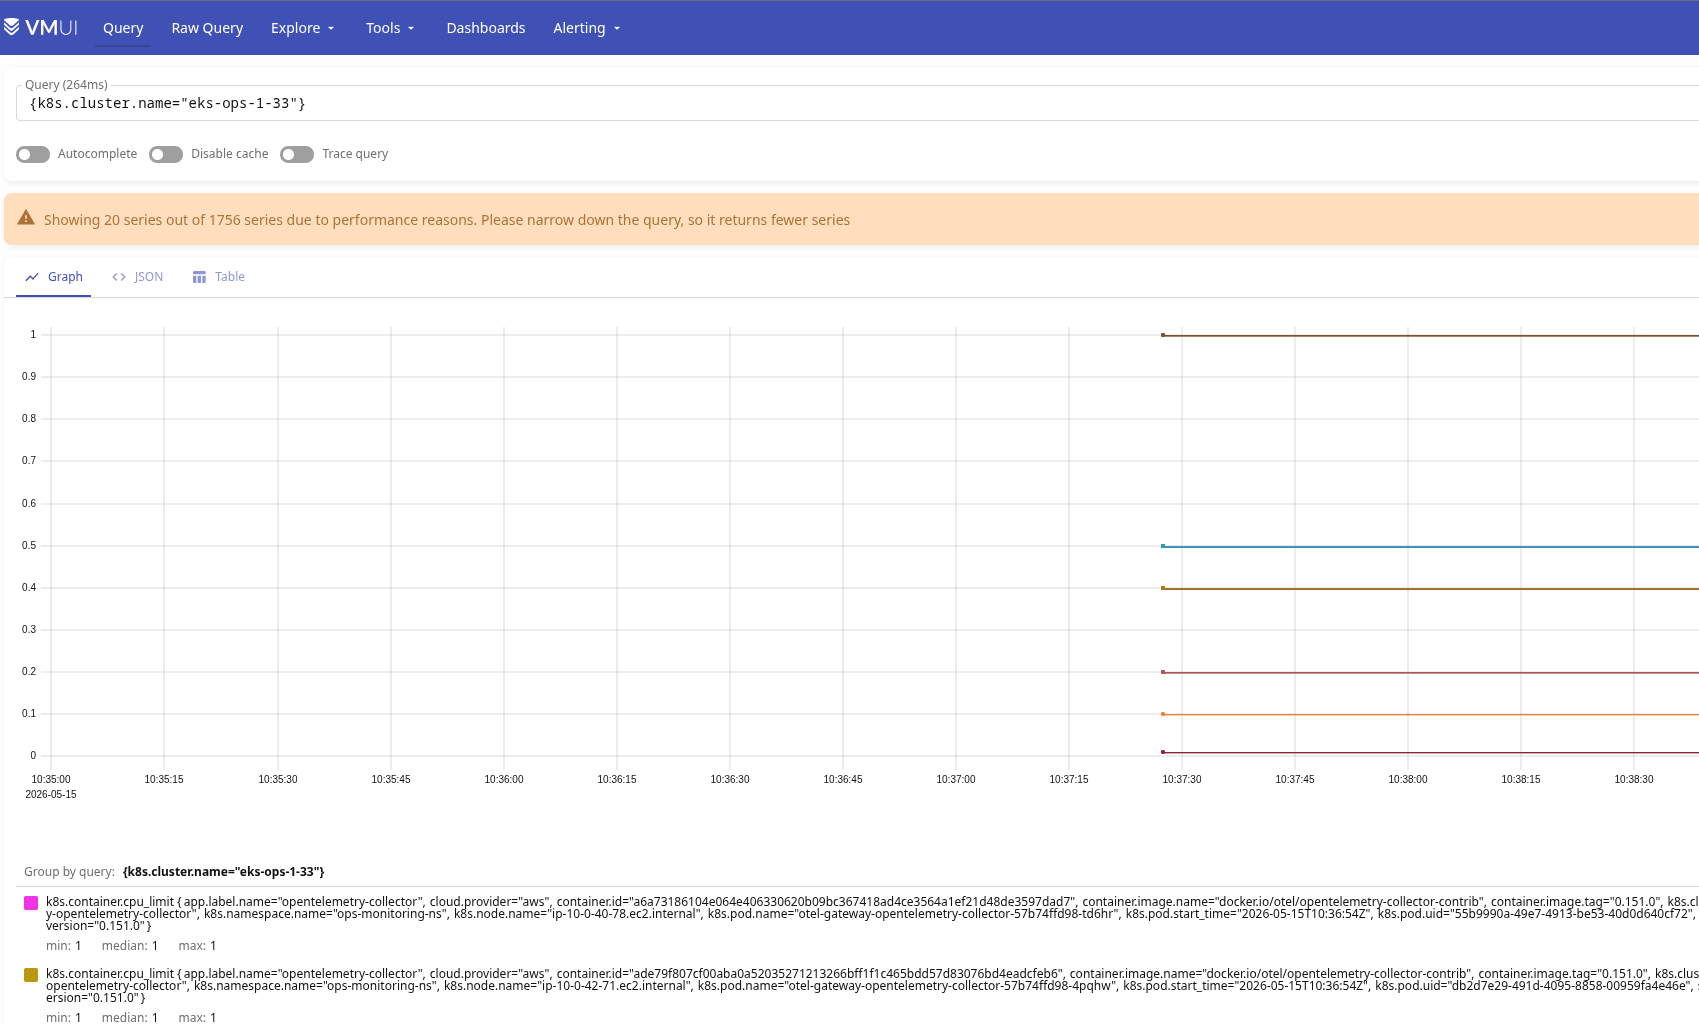
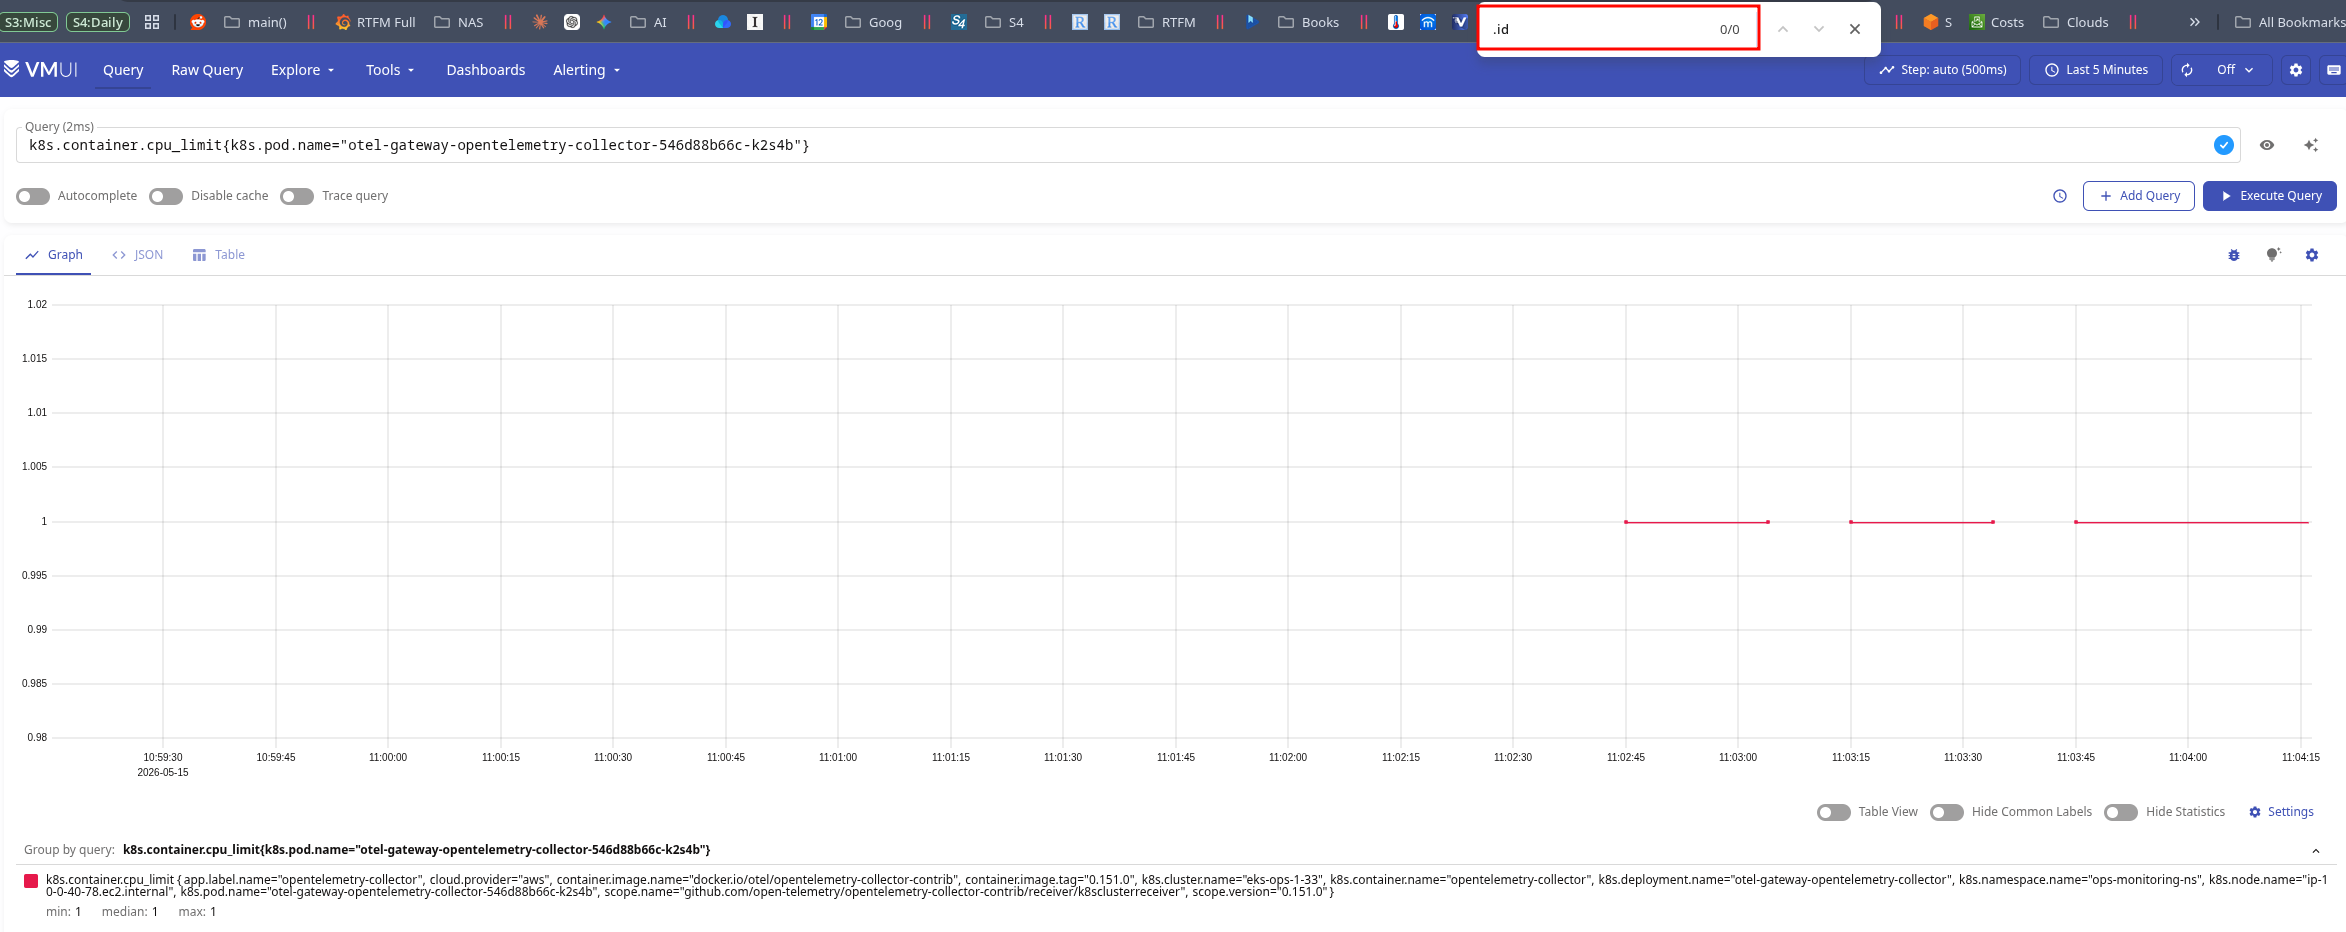
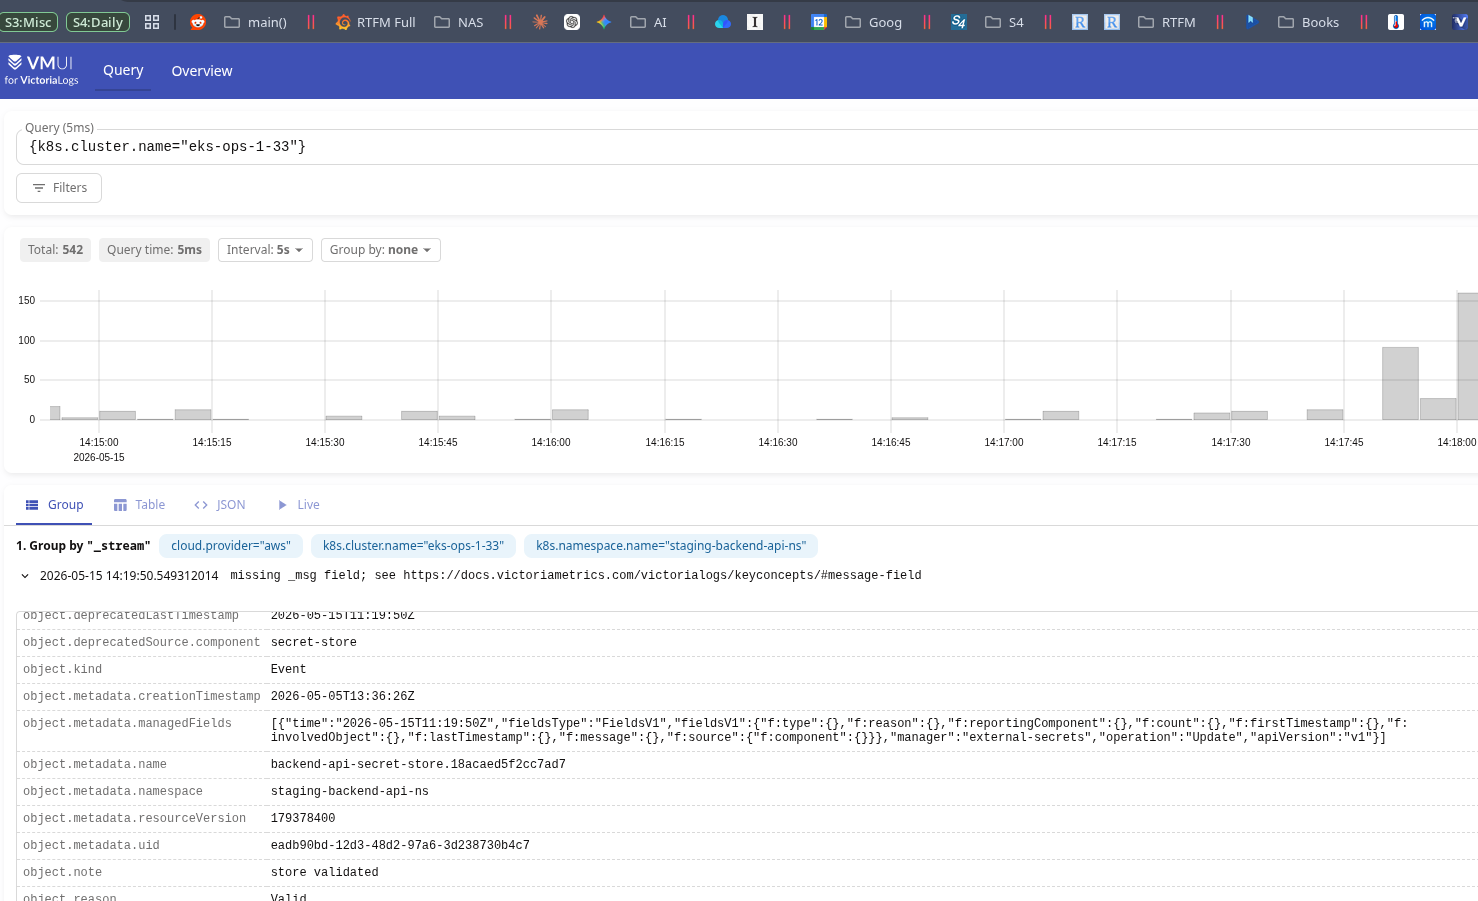
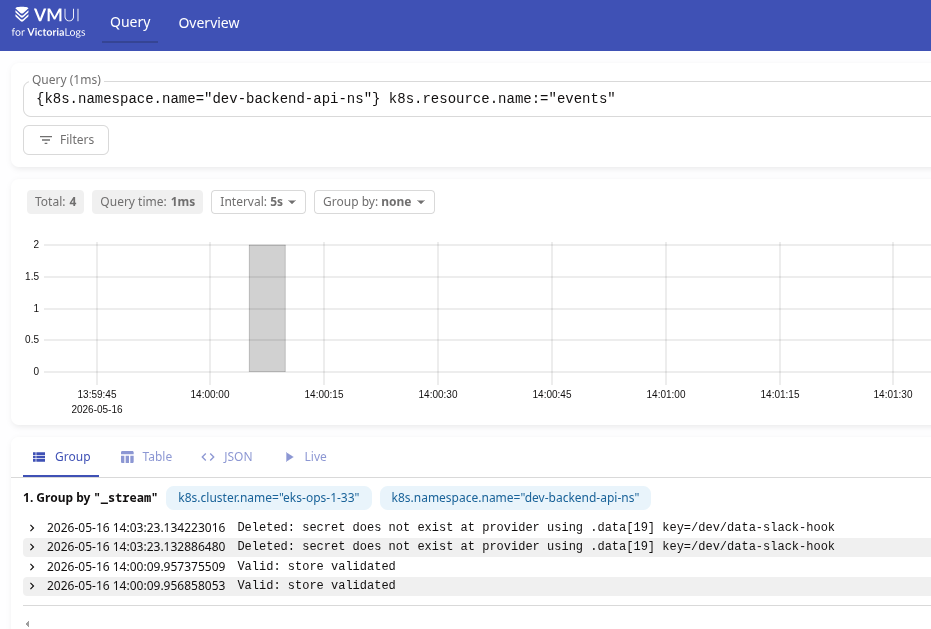
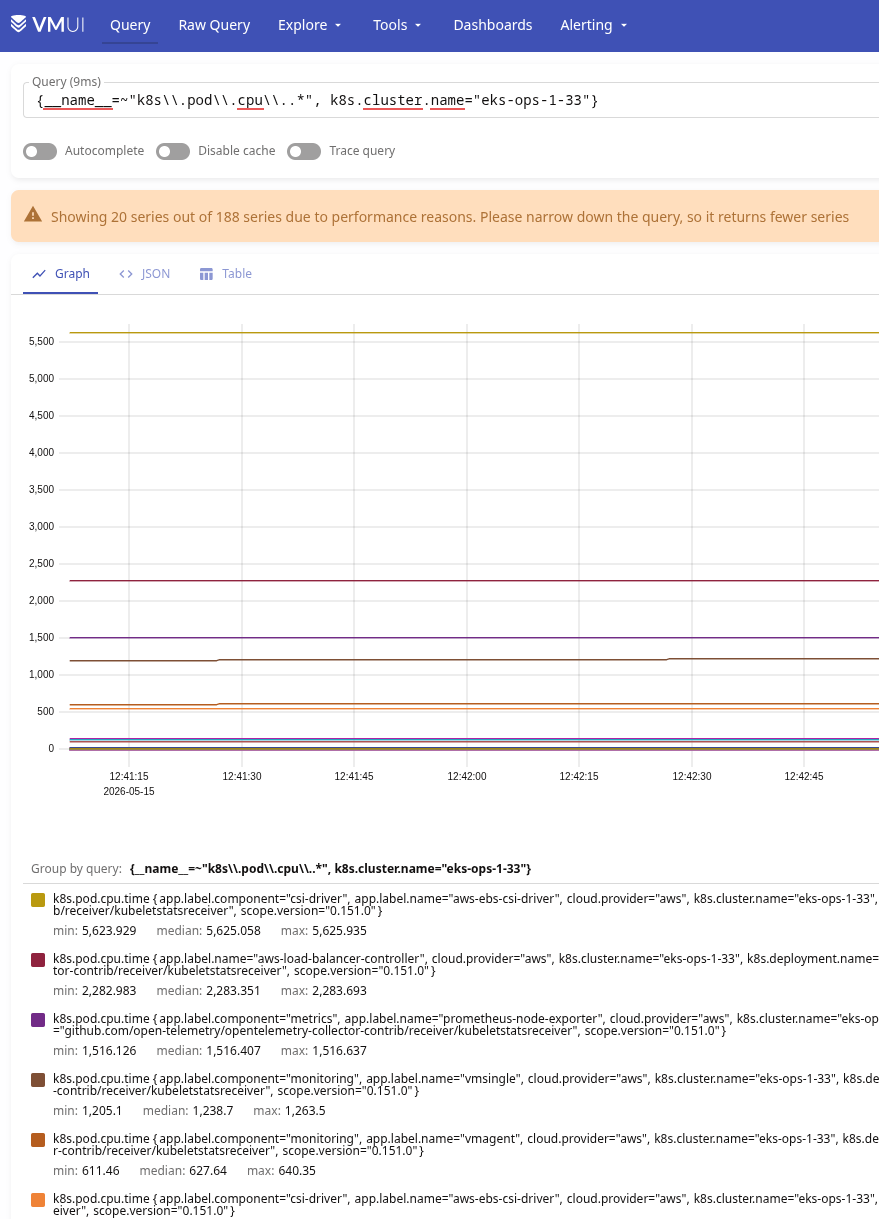
 Іноді на FreeBSD треба запустити якісь сервіси, які офіційно FreeBSD не підтримують, і власне, цей пост з’явився через те, що я встановлював Open WebUI на своєму NAS – і як раз Open WebUI простіше було зробити на Linux.
 По самому Hermes Agent і його можливостям буду писати окремо, сьогодні – як запустити його на FreeBSD.