 Дуже рандомний текст. Не планувався взагалі, і в цьому блозі не так багато таких записів – але іноді “в голові щьолкає” (поки ще є чому) і формується думка, яку хочеться висловити у вигляді такого тексту, зберігти її.
“Агентська розробка – х*єта”.
Точніше – не так. Розробка з ШІ-агентами – це круто. Це швидко, це – дуже часто – краще, ніж деякі власні рішення чи ідеї.
Для мене особисто AI-агент сприймається як Ватсон у Холмса: це сутність, якій ти можеш закидувати якісь “напівфабрикати” ідей, задавати загальний напрямок – а потім разом з цим агентом робити красиве рішення.
Але!
“Х*єта”, звісно, надто категоричне ствердження.
Точніше буде висловити це як “Агентська розробка небезпечна“. Небезпечна не в тому плані, що агент може дропнути вашу бази даних – а в тому, як це змінює нас, інженерів.
Важливо: все написане нижче – особисті думки автора цього блогу, засновані виключно на власному досвіді роботи з GenAI та ШІ-агентами
Зміст
Холмс, Ватсон і ми
Проблема починається тоді, коли Ватсон перетворюється на Майкрофта Холмса – він розумніший за тебе, він бачить більше за тебе.
І потім в якийсь момент ти помічаєш, що Холмса в цій історії більше немає – а є Майкрофт, який думає, планує і робить, а ти – просто шматок м’яса з доступом до кнопки “Approve”.
Ти тепер не архітектор, ти не контролюєш процес – ти просто “meat middleware” між агентом і кнопкою “Deploy”.
Блін – я навіть ці рядки пишу з LLM!
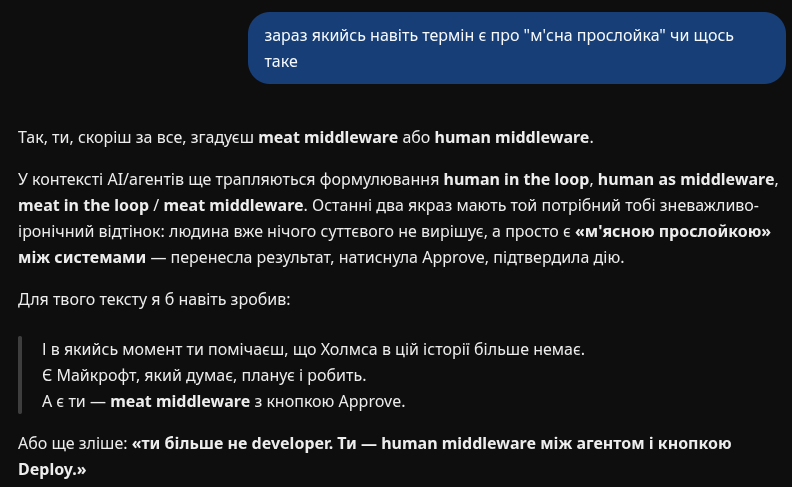 Бо мені тут лінь включати голову і згадувати – і про це теж буде далі.
Роздум перший: де мій дофамін?
Як взагалі в голову прийшла ідея написати цей текст, звідки ці роздуми.
Колись – майже рік тому, 25/10/2025 – я в цьому блозі писав про те, як робив свою систему мого власного “Self Monitoring Project”:
Тоді я витратив кілька днів чисто на те, що зробити міграцію даних з Google Sheets в InfluxDB і додати простеньку веб-сторінку для запису нових даних.
Але ще рік тому я це робив принаймні тільки з ChatGPT чи Claude.ai – обговорював функції, дії, сам запускав команди.
Сьогодні я майже закінчив реалізацію мого нового проекту “PersonalAI Health Agent” – але з Hermes Agent.
Цей проект, агент, серед багатьох інших задач робить те саме – імпортує із Google Sheets в мою self-hosted VictoriaMetrics вдома, а на додачу ще виконує імпорт даних з Google Calendar та мого власного щоденника, всякі аналізи та репорти.
В “PersonalAI Health Agent” все автоматизоване, всі дані структуровані, все кросівоє.
Це все зайняло в мене 2 дні – при тому, що тут роботи було в рази більше, ніж в згаданому вище пості.
Але: проект “PersonalAI Health Agent” я зробив з самим Hermes Agent і GPT 5.5, і на 99% відсотків все робилось агентом, тим самим “вайбокодом” – всі скрипти, всі конфіги, всі ідеї того – як робити імпорт, як організувати дані в Obsidian vault, як це все перевіряється, валідується, бекапиться.
І коли я побачив фінальний результат, коли система вже майже “production ready”, коли вона вже стала тим рішенням, про яке зазвичай хочеться писати на RTFM – я зрозумів, що…
Не хочу. Ні – я все ж (мабуть) запишу про це, бо писати в пости на RTFM – це ще і звичка до “self documention”, бо описуючи щось – ти краще структуруєш знання в голові.
Але…
Кайфу нема.
Я згадую, як мене накривала хвиля дофаміну, коли я побачив перші графіки в моїй self-hosted Grafana з метриками – той фінальний результат, який описаний в “InfluxDB: запуск на Debian з NGINX і підключення Grafana”.
Який це кайф – коли ти їб*шиш, їб*шся, мозок кипить – а потім доводиш рішення до фіналу і отримуєш свій dopamine reward.
І дивлюсь на те, що закінчив зараз…
Класно вийшло? Да, класно. Зручно, все працює саме так, як я хотів. Продумано багато деталей, про які я сам згадав би тільки вже після “запуску в продакшен”.
Швидко? Да! Якби я це робив сам (“сам” тут мається на увазі з допомогою чатиків у ChatGPT, звісно, бо ми ж живемо не в 2015 році) – то це зайняло б тиждень.
Але – чи це те рішення, яким хочеться поділитись?
Ну, таке… Бо – ділитись чим? Це не “моє рішення”. Це не я думав, планував, ходив кругами по кімнаті чи парку в “архітектурних роздумах”.
Моя задача звелась до “прочитати пропозиції від AI, вибрати те, що мені подобається, натиснути кнопку Enter”.
Справа навіть не в тому, що з агентом стало занадто легко: просто з процесу зникає саме та частина, яка давала драйв раніше – задача => тупняк => пошук => помилкова ідея => розуміння => рішення.
Ми бачимо проблему або задачу – і потім отримуємо вже готове рішення. Але весь (ну, майже і не завжди) шлях між ними пройдений не власною головою.
Ламається весь reward loop.
І це, відверто, п*зда.
Роздум другий: де розуміння і контроль?
Друге, і дуже важливе – це те, що втрачається розуміння і контроль над рішенням, яке побудоване агентом.
Як би детально все не описувалось в README.md чи AGENT.md/CLAUDE.md файлах – прочитати вже написаний агентом текст з описом архітектури і особливостей системи – це абсолютно не означає розуміти побудовану “тобою” систему.
Читання таких – вже готових, написаних кимось чи чимось – документів не дуже допоможе побудувати в голові “mental model” цієї системи.
Бо тільки тоді, коли сидиш в роздумах над логікою функції в коді, над алгоритмом виконання задачі – потім буде розуміння того, як всі функції і модулі працюють разом, де їхні сильні і слабкі сторони.
Натомість – ми починаємо покладатись на те, що “Агент краще знає, агент швидко прочитає md-файли, агент швидше зробить фікс”.
І чесно – це іноді вже навіть лякає. Ще не сильно – але тригери на “задуматись” вже є.
Я особисто в роботі все більше і більше використовую агентів (зараз Codex і Sol 5.6, раніше – Claude і… 4.6 Sonnet?).
Допомагає це мені виконувати задачі швидше?
Однозначно да!
Я за 15 хвилин можу зробити те, з чим сам копався б пару годин чи навіть цілий день – бо треба ж було знайти потрібну документацію, розібратися з тим, що саме там написано, зрозуміти, як це співвідноситься з тим, що в мене вже є в коді чи конфігах, і, нарешті, нормально прикрутити все це до існуючого рішення.
Навіть якби я робив не сам, а з вікном ChatGPT в браузері – це інший рівень, ніж писати в Codex “зроби це”.
Але – чи я повністю розумію те, що зроблено?
В мене за останні півроку по роботі, на проекті, купа нових сервісів. Купа нових рішень, систем, сервісів від девелоперів. Це все моніториться, конфігуриться, деплоїться, до всього є аутентифікація.
Чи можу я точно сказати “Тут зроблено так, бо там був такий нюанс – і тому я вирішив зробити так”?
Ні, не можу. Десь, можливо, щось пригадаю – якщо це з Codex обговорювалось, а не просто я йому сказав “ОК, роби, як вважаєш за краще”.
Але чи знаю я всю систему “під капотом” – як вона працює, які конфіги використовує, які нюанси в ній є? Ні – не знаю.
Максимум, на що я можу розраховувати – це файли README.md/AGENT.md/CLAUDE.md, і потім питати той жеж Codex “А якого біса тут така хєрня?”, а потім думати “Аааа, блін – ось чому!”.
Роздум третій: лінь!
Я (особисто я) все частіше помічаю за собою, що мені тупо лінь думати.
Нашо думати самому, якщо я за пару секунд напишу промт “А чому тут avg_over_time(), а не sum_over_time()?” – і потім просто очами прочитаю пояснення?
Чи простіше так робити Grafana dashboards?
Да.
Чи допоможе мені зберігати мої знання по MetricsQL/PromQL?
Питання риторичне.
Агент не просто дозволяє нам не знати – агент привчає нас не намагатися згадати взагалі.
Раніше ми спочатку хвилину напрягали мозок – “Блін, avg чи sum – як воно там працює, в чому різниця?” – і паралельно це тригерило ті області пам’яті, ті нейрони, де ми зберігаємо знання про метрики, тайм-серії, формати даних.
І тільки після того, як ми подумали і згадали хоча б частину цього – ми йшли в документацію, але навіть тоді, використовуючи документацію – ми думали і згадували ще якісь релевантні деталі.
Тепер цієї хвилини взагалі немає: ми віддаємо розуми і пам’ять на outsource до агенту.
Так – ми цим самим звільнюємо свої ресурси для більш цікавих задач, але в той жеж час – “звільняємо свою пам’ять” і від частини тих знань, які, власне, формують нас, як інженерів – і про це як раз буде наступна частина цього тексту.
Роздум фінальний: власне – а що далі?
І, з одного боку – ми всі, думаю, розуміємо, що такі процеси в розробці/адмініструванні – це нова реальність.
Це треба бізнесу, і – відверто – це зручно нам.
Ми полегшуємо собі життя, і дійсно є багато задач, на які не хочеться – або і не треба – витрачати час, зусилля і робити їх руками. Бувають задачі, які треба зробити швидко, бо коли в тебе лежить production – ми не можемо витрачати зайвий час на те, щоб знайти релевантні метрики, логи, будувати запити і шукати причину проблеми – швидше буде написати промт агенту.
Тобто, використовуючи AI та агентів ми дійсно швидше робимо задачі для свого проекту, швидше “задовільняємо” бізнес чи девелоперів, швидше розбираємось з проблемами.
Але ціною чого?
Ціною втрати розуміння. Ціною втрати контролю.
І це особливо важливо для нас, DevOops-інженерів – бо на нас відповідальність не просто за код якогось одного сервісу і ризики типу дропнути продакшен базу даних, яку потім все ж можна відновити з бекапів – на нас, як людях, які займаються всією інфраструктурою всього проекту, лежить відповідальність в тому числі і за самі бекапи Production database теж.
Наша помилка – чи неспроможність швидко розібратись з проблемою – може вплинути відразу на всі сервіси проекту, а не тільки якийсь окремий компонент.
Це взагалі те, що завжди мене драйвить в роботі – бо ти знаєш, що саме ти несеш відповідальність за весь проект, що твій прой*б може вплинути на всіх і вся – девелоперів, клієнтів, бізнес.
Але занадто “захоплюючись” агентами, занадто довіряючи і передаючи їм контроль – ми втрачаємо себе, як інженерів.
Ми не розвиваємо своє “інженерне мислення” – здатність планувати, здатність тримати в голові контекст всього проекту, всіх його систем, здатність розуміти, як зміни в одному місці вплинуть на інші частини механізму.
Вкрай важливо розуміти це. Усвідомлювати те, що виконуючи задачу з агентом – ми позбавляємо себе, як інженера і спеціаліста, нових нейронних зв’язків у власній голові і позбавляємо себе контролю над системами.
Те саме стосується і першого роздуму, про дофамін і reward loop – треба залишати собі “ручну роботу”. Залишати собі задачі, де думає моя голова і “кормить мій дофамін”.
До речі, писати в блог – це одна з речей, які допомагають і в тому, щоб зберігати цей “дофаміновий прихід” – і давати голові зайвий раз подумати і “подьоргати нейрони”.
То що робити?
Рішення просте і доволі очевидне – “дозувати” використання ШІ і агентів.
Усвідомлювати коли дійсно треба “швидко, але ціною втрати розуміння і контролю” – а коли можна витратити в п’ять разів більше часу на реалізацію чи фікс, але “не давати мізкам засохнути” і трохи “підкормити нейрони” в своїй голові, а заодно “розвести” власну біохімію на дофамінчік і отримати кайф.
Треба знати в яких рішеннях можна покладатись на агента, бо blast radius помилок не надто критичний – а в яких рішеннях треба зайвий раз подумати самому.
Треба думати “Чи важливо мені після виконання цієї задачі самому розуміти, як і чому це працює?” – чи “Я роблю одноразовий скрипт з read-only opeartions для аналізу” – і тоді, можливо, пох*й на те, як він там собі працює.
Думати – задля розуміння, задля контролю, і задля розвитку себе самих.
ChatGPT при ревью доволі красиво (блін! знов AI) сформулював загальну ідею цього матеріалу:
AI вперше дозволив інженеру систематично створювати речі, складність яких може перевищувати його власне розуміння цих речей. І це одночасно ох*єнно з точки зору продуктивності – але і дуже небезпечно з точки зору того, ким у цьому процесі залишається сам інженер.
І наостанок – іноді треба питати себе “А чи зможу я виконувати задачі і підтримувати систему, якщо раптом AI зникне?”
От – якось так вийшло.
Welcome на поговорити в чатик RTFM в Telegram – t.me/rtfmco/
