 Трохи нестандартний вийшов матеріал 🙂
Нестандартний в тому плані, що він насправді якраз “стандартний” – стандартний в тому, як схожі пости писались раніше, в часи мамонтів – ще до LLM і AI-агентів: сьогодні дебажив одну проблему, і вирішив робити це без використання AI взагалі, чисто в “ручному режимі” – з гуглінгом і читанням документації.
Надихнув на цей мій попередній пост – AI: LLM, агенти, робота і ми – інженери. Особисті думки, бо коли вранці побачив алерти і почав розбиратися, де проблема і як її шукати – то перша думка була “закину це в Codex, нехай розбирається”.
Але потім задумався – а як я раніше вирішував такі проблеми? А звідки починати? А які взагалі у LiteLLM є метрики і що може бути цікавого в логах?
Тому сьогодні трохи “the old school way” – включимо голову і робимо все самі.
Благо проблема для нас не настільки критична, і в мене є можливість трохи покопатись і витратити зайвий час.
Зміст
The issue: LiteLLM PostgreSQL Failed Requests
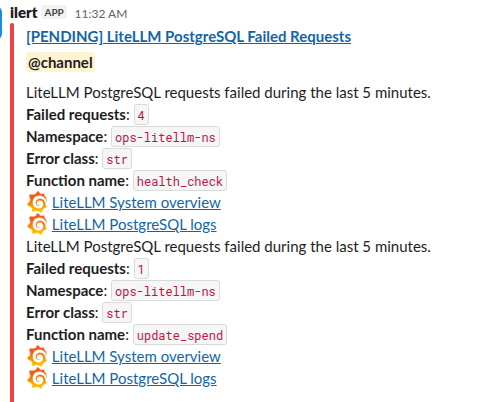
З ночі в Slack почалися алерти “LiteLLM PostgreSQL Failed Requests“:
Debugging: LiteLLM “level”
Перше, що цікаве – що взагалі з ночі змінилось?
Може маємо забагато запитів до LiteLLM і збільшилось навантаження на її PostgreSQL? Див. What is stored in the DB.
Дивимось графіки запитів – вночі спайки були, але це expected, у нас вночі завжди така картина:
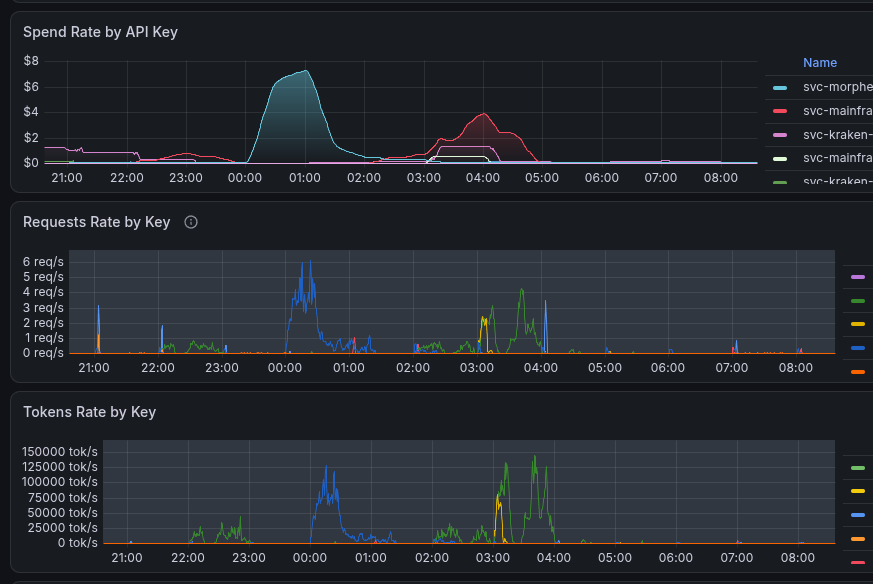
Крім того, спайки запитів завершились о 04:00, це теж наш common flow, і потім трафік вже мінімальний – а помилки PostgreSQL є прямо зараз.
Сам алерт формується з дефолтної метрики LiteLLM – litellm_postgres_failed_requests_total (див. Monitor System Health і трохи розбирав в пості LiteLLM: моніторинг з VictoriaMetrics – алерти та Grafana):
- alert: LiteLLM PostgreSQL Failed Requests
  expr: |
      sum by (namespace, error_class, function_name) (
        increase(litellm_postgres_failed_requests_total[5m])
      ) > 0
Глянемо графіки помилок – коли взагалі почалось, як виглядає частота помилок PostgreSQL?
А графік за 2 доби дуже цікавий – проблема почалась саме з сьогоднішньої ночі, з 01:00 UTC:
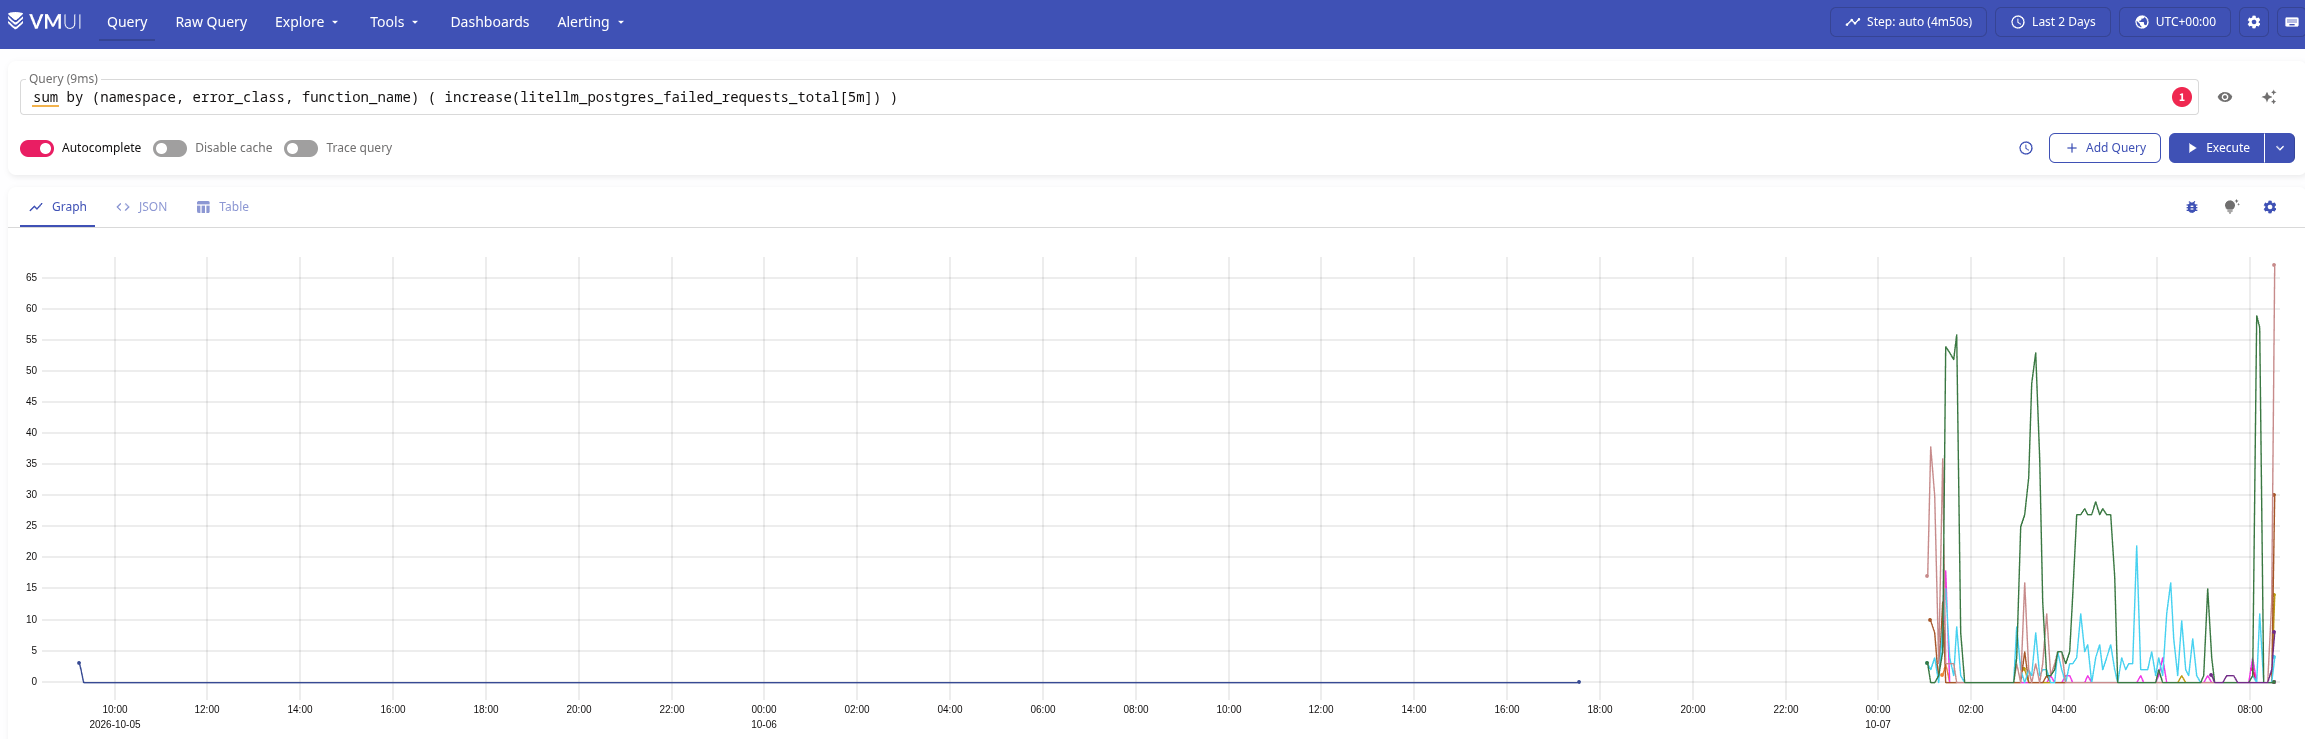
На LiteLLM ми вночі зміни точно не деплоїли – значить, причина скоріш за все не в змінах її (його? – AI Gateway – скоріш всеж “його”) коду.
Ще бачимо те, що проблема на двох оточеннях – Test та Ops (це наш production), і має різні error_class та function_name:
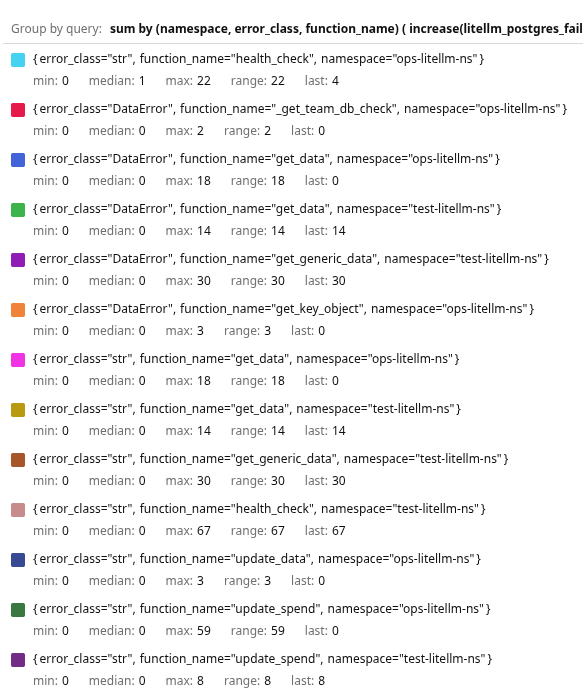
А значить, це не якась “локальна” проблема одного компоненту LiteLLM, а щось більш “глобальне”.
Добре – поїхали дивитись логи LiteLLM.
Ну а в логах бачимо “прекрасне”:
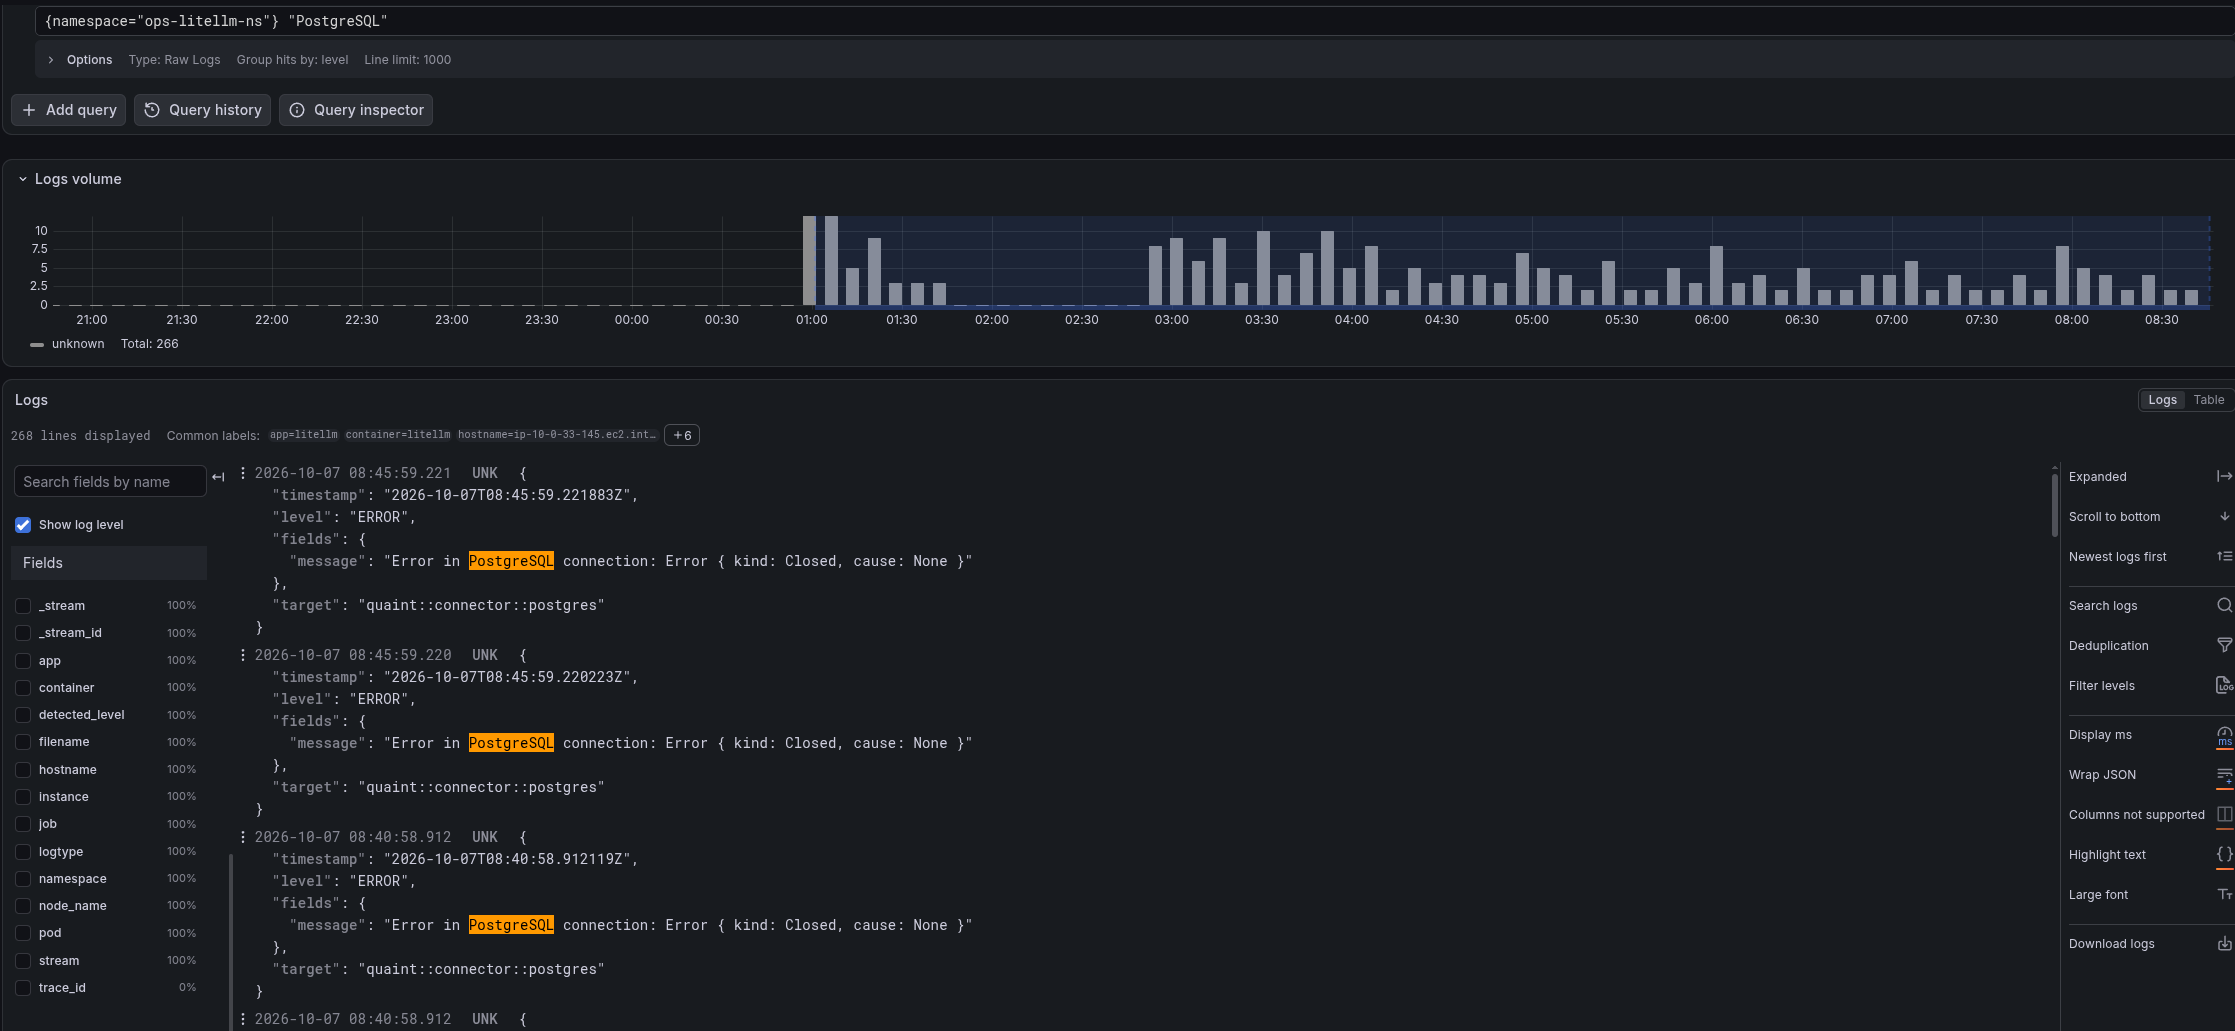
2026-10-07 08:05:57.169 unk {
  "timestamp": "2026-10-07T08:05:57.169121Z",
  "level": "ERROR",
  "fields": {
    "message": "Error in PostgreSQL connection: Error { kind: Closed, cause: None }"
  },
  "target": "quaint::connector::postgres"
}
І теж почалося з 01:00 UTC.
Проблема вже явно видна – щось трапляється під час підключень до RDS, а значить, ми вже знаємо, куди йти далі – пора глянути стан самого інстансу AWS RDS.
Debugging: AWS RDS “level”
І далеко ходити не довелось – все видно відразу на сторінці Aurora and RDS > Databases, де “atlas-monitoring-ops-rds” – це якраз інстанс з базами LiteLLM:
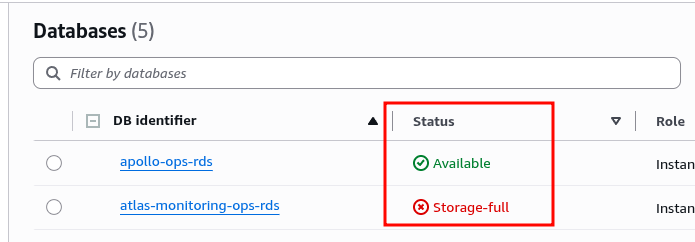
Чому я це не побачив в нашому моніторингу – бо “специфіка стартапу, який ще в MVP”: цей інстанс RDS раніше використовувався тільки для Grafana, тому і повноцінного моніторингу для нього нема.
Потім на ньому ж створили бази для LiteLLM – а моніторинг “не в пріорітеті”. Тікет на це собі робив, але “не доходили руки”.
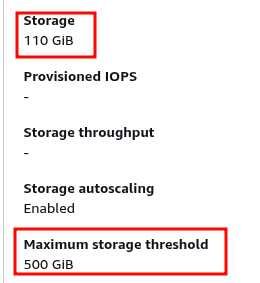
І ще “прикольно”, що Storage autoscaling при створенні інстансу я-то включив – але:
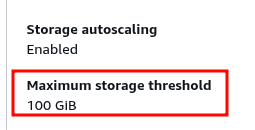
Сука 🙂
Бо знов-таки – ліміт задавався ще в ті часи, коли тут була тільки база для Grafana.
Fixing: AWS RDS Maximum storage threshold
Шо треба буде зробити:
- збільшити AWS RDS Maximum storage threshold
- таки налаштувати повноцінний моніторинг цього RDS – але вже потім
- додати алерти з логів LiteLLM при проблемах з PostgreSQL
Сам RDS створюється з Terraform і terraform-aws-modules/rds/aws, у якого є параметр max_allocated_storage – тут було 100 GB, задаємо 500:
module "monitoring_rds" {
  source  = "terraform-aws-modules/rds/aws"
  version = "~> 7.2.0"
  ...
  allocated_storage     = 20
  max_allocated_storage = 500
  ...
Але перед деплоєм спрацьовує “стоп-сигнал” – як зміни розміру існуючого EBS вплинуть на роботу RDS? Буде даунтайм – чи ні? Бо я зараз збільшу max_allocated_storage – це має запустити процес збільшення поточного розміру диску.
Ну і тут ще раз – давайте без LLM.
RTFM! Read the documentation first.
І ще один момент, коли в таких випадках корисно самому почитати документацію, а не просто скормити задачу агенту – бо я не пам’ятав деяких обмежень.
Гуглимо “aws rds change storage autoscaling“, знаходимо Managing capacity automatically with Amazon RDS storage autoscaling і читаємо:
Changing storage autoscaling settings doesn’t require a database reboot and doesn’t cause any downtime. The changes take effect immediately without disrupting database operations.
Окей.
Ще один нюанс з документації:
Storage optimization has completed on the instance for the previous storage modification, and fewer than four storage modifications have occurred in the past 24 hours.
Не більше 4-х storage modifications (в тому числі збільшення розміру) за останні 24 години – теж ОК.
Ще цікаве знайшов в Why does my Amazon RDS DB instance enter a storage-full state:
Note: If your DB instance is in the storage-full state, then you must first stop any data loads to the DB instance. This process can take a few minutes to several hours before the instance isn’t in a storage-full state.
Тобто, якщо маємо багато даних, які пишуться – треба зупинити запис нових даних (мова не про зупинку інстансу RDS, а саме про задачі, які на ньому виконуються).
Те саме про якісь великі read-only запити, які створюють багато temporary files (з ORDER BY, GROUP BY, etc).
Ок – в нашому випадку можна спокійно міняти “наживо” – деплоїмо, дивимось в AWS Console – диск вже збільшується:

За пару хвилин готово – диск був 100 GB, став 110, і Maximum оновився теж:
VictoriaLogs, Recording Rule та Alert
І наостанок хочеться додати Recording Rule на такі проблеми в LiteLLM – бо його метрика не дає пояснення в чому саме проблема.
Логи у нас пишуться в VictoriaLogs, тому запити нижче – це її LogsQL. Про Recording Rules писав у VictoriaMetrics: Recording Rules для логів AWS Load Balancer і VictoriaLogs: створення Recording Rules з VMAlert.
У нас є текст помилки:
2026-10-07 08:05:57.169 unk {
  "timestamp": "2026-10-07T08:05:57.169121Z",
  "level": "ERROR",
  "fields": {
    "message": "Error in PostgreSQL connection: Error { kind: Closed, cause: None }"
  },
  "target": "quaint::connector::postgres"
}
І є набір полів:
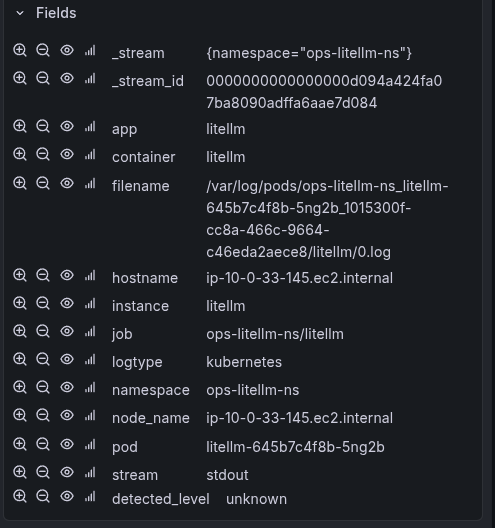
Формуємо запит – теж роблю без LLM, але і не з нуля, бо в мене вже є багато схожих Recording Rules, які (OMG!) колись писав сам.
З unpack_json глянемо що буде в fields:
app:="litellm" "PostgreSQL" | unpack_json
Всі потрібні поля є – можемо обійтись навіть без extract_regexp:
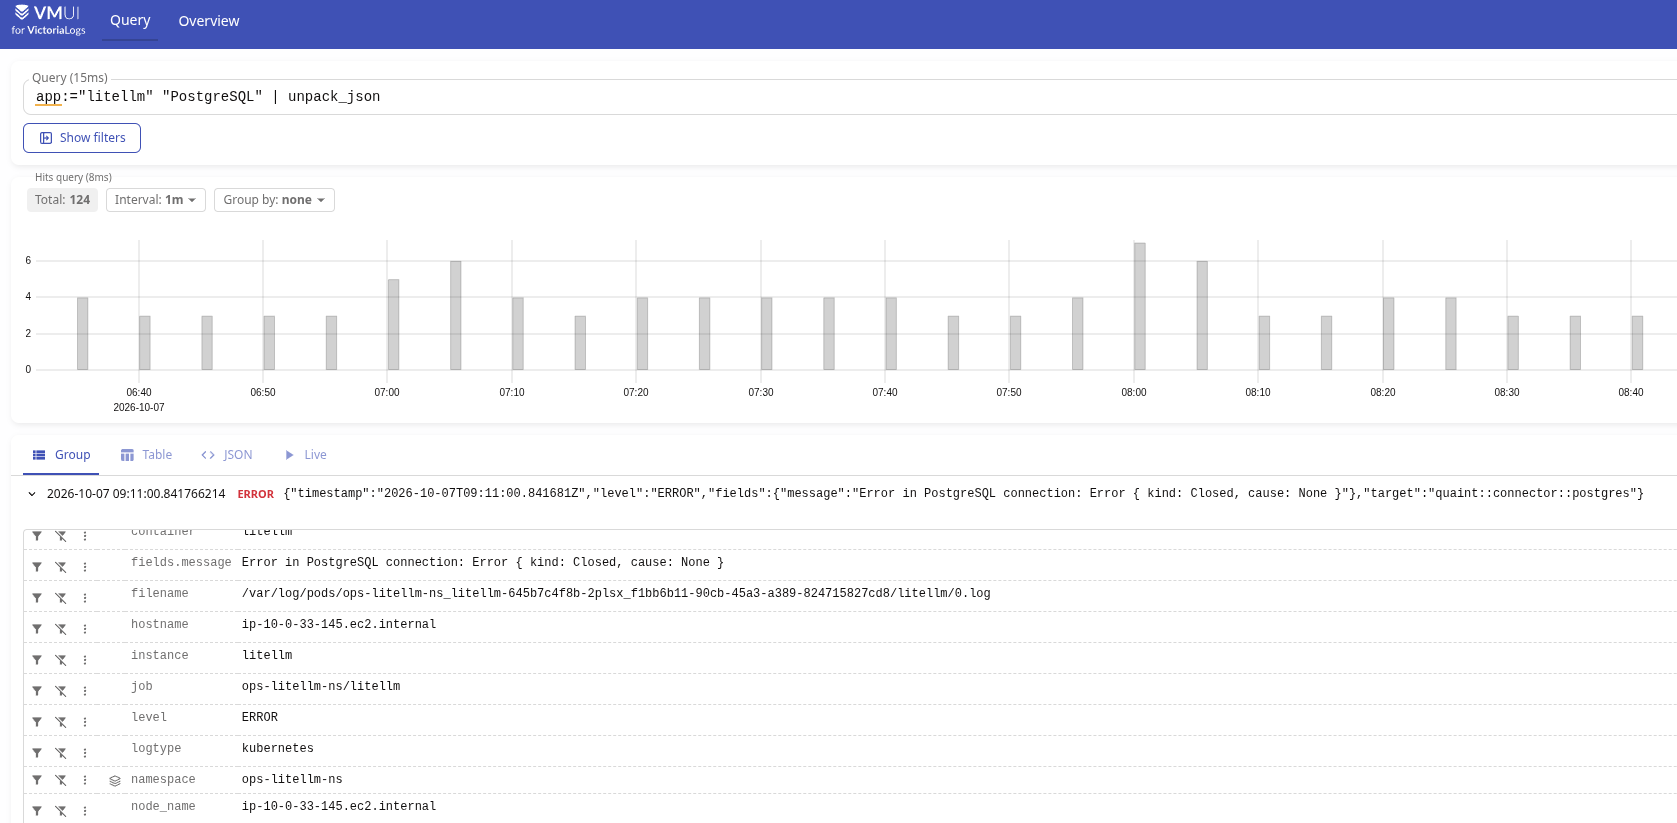
З корисних полів тут:
level="ERROR": можна додати в загальний фільтр запиту, щоб зменшити роботу VMAlertnamespace="ops-litellm-ns": буде корисно в самому алерті, аби в Slack відразу бачити, на якому оточенні проблема (бо у кожного оточення власний Kubernetes Namespace, і взагалі це стандартне поле в наших алертах)fields.message="Error in PostgreSQL connection: Error { kind: Closed, cause: None }": і сам текст помилки, теж писати в Slack
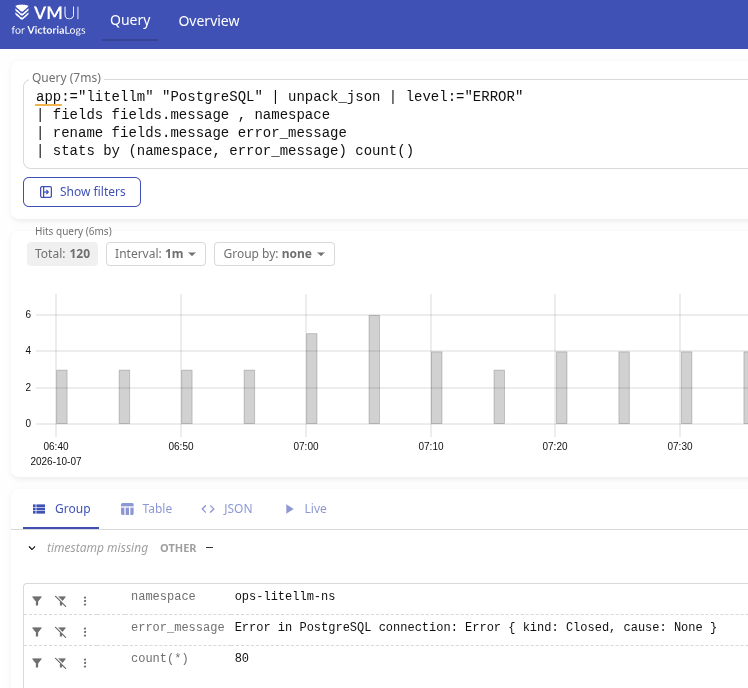
Формуємо запит:
app:="litellm" "PostgreSQL" | unpack_json | level:="ERROR"
| fields fields.message , namespace
| rename fields.message error_message
| stats by (namespace, error_message) count()
Єдиний момент тут – поле error_message: воно стане лейблою в метриці, і якщо тут буде багато різних значень – то можна зловити High Cardinality issue, див. VictoriaMetrics: Churn Rate, High cardinality, метрики та IndexDB.
Але конкретно в цьому випадку не думаю, що щось таке буде – тому поки що ОК, нехай буде так.
Спершу перевіряємо в VM UI для VictoriaLogs:
Описуємо новий Recording Rule та нову метрику vmlogs:litellm:logs:database_errors:count:
- record: vmlogs:litellm:logs:database_errors:count
  expr: |
    app:="litellm" "PostgreSQL" | unpack_json | level:="ERROR"
    | fields fields.message , namespace
    | rename fields.message error_message
    | stats by (namespace, error_message) count()
І додаємо алерт:
# PostgreSQL database errors detected in logs
- alert: LiteLLM PostgreSQL Database Error Detected
  expr: vmlogs:litellm:logs:database_errors:count > 0
  for: 0m
  labels:
    component: devops
    environment: ops
    severity: critical
    ilert_routingkey: devops-ops-critical
  annotations:
    summary: LiteLLM PostgreSQL database error detected
    description: |-
      LiteLLM reported a PostgreSQL database error during the latest recording rule evaluation.
      **Events**: `{{ "{{" }} printf "%.0f" $value }}`
      **Namespace**: `{{ "{{" }} $labels.namespace }}`
      **Error message**:
      ```
      {{ "{{" }} $labels.error_message }}
      ```
      :grafana: [LiteLLM System overview](https://{{ $.Values.monitoring.root_url }}/d/adtt9jj/adrmshg/litellm-system-overview)
Почекаємо спрацювання – подивимось, що треба буде ще підтюнити в Recording Rule або алерті.
І наостанок: це все ж якийсь окремий і трохи підзабутий кайф – шукати і фіксити проблему в такому от “ручному режимі”, а не просто дати задачу LLM і агенту, який все зробить сам.
Хоча текст цього матеріалу на вичитку до GPT 5.6 Sol все ж закинув 🙂 Добре ловить всякі опечатки та помилки в пунктуації.
