 Трапився доволі цікавий випадок відносно моніторингу вартості LLM через LiteLLM при кількох провайдерах.
Що маємо:
- LiteLLM: AI Gateway, всі наші сервіси працюють через нього, він проксює запити до провайдерів, генерує метрики і трейси, контролює доступи, витрати тощо
- OpenAI та OpenRouter: зараз два основних провайдери, на які LiteLLM передає запити
- частина клієнтів (наших сервісів) працюють через LiteLLM на OpenAI, частина йде через OpenRouter
- LiteLLM має fallbacks для OpenRouter – якщо туди реквест фейлиться, запит переходить напряму до OpenAI
Моніторинг стек – VictoriaMetrics, VictoriaTraces, VictoriaLogs, тому, звісно, всі приклади запитів будуть з MetricsQL або LogsQL, хоча запити MetricsQL можна використовувати з Prometheus – наче не використовував функції, які є тільки у VictoriaMetrics.
Про моніторинг LiteLLM писав у LiteLLM: моніторинг з VictoriaMetrics – алерти та Grafana і LiteLLM: метрики, traces та інтеграція з VictoriaMetrics Stack.
Власне, до суті проблеми.
Зміст
The Issue: OpenAI costs spike
Почав налаштовувати LiteLLM Budgets (про них допишу окремо), і коли робив Grafana dashboard з графіками витрат – помітив різкий спайк на одному з наших сервісів.
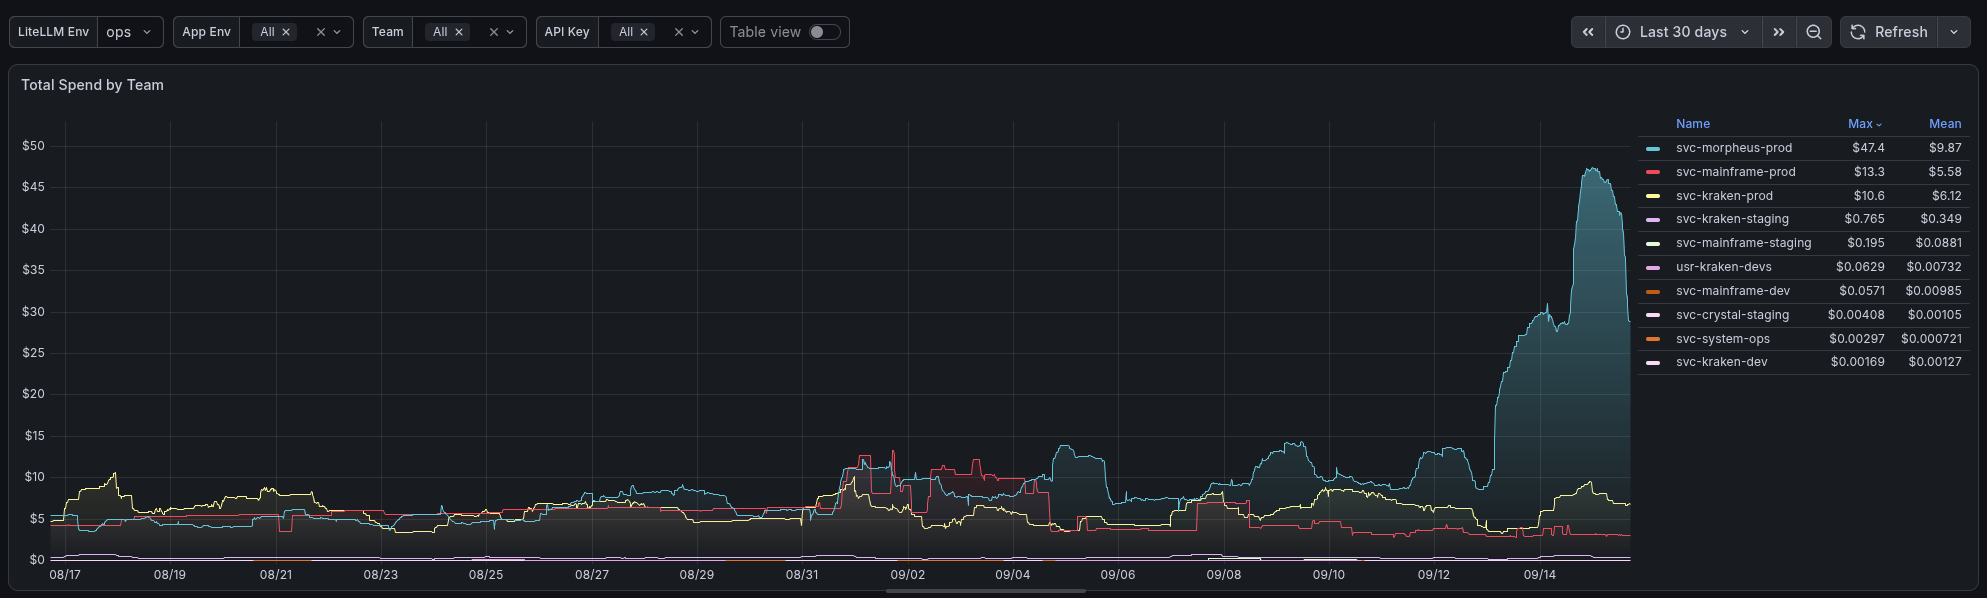
Запит:
sum(increase(litellm_spend_metric_total{api_key_alias="svc-morpheus-prod"}[24h]))
Debugging the Cost Spike
Власне – як дебажив, що знайшов.
З графіками і прикладами запитів до VictoriaMetrics та VictoriaTraces.
Request or Token Spike?
Перше, що спадає на думку – спайк запитів або токенів, вірно?
Перевіряємо requests:
sum(
  increase(
    litellm_requests_metric_total{
      api_key_alias="svc-morpheus-prod"
    }[24h]
  )
)
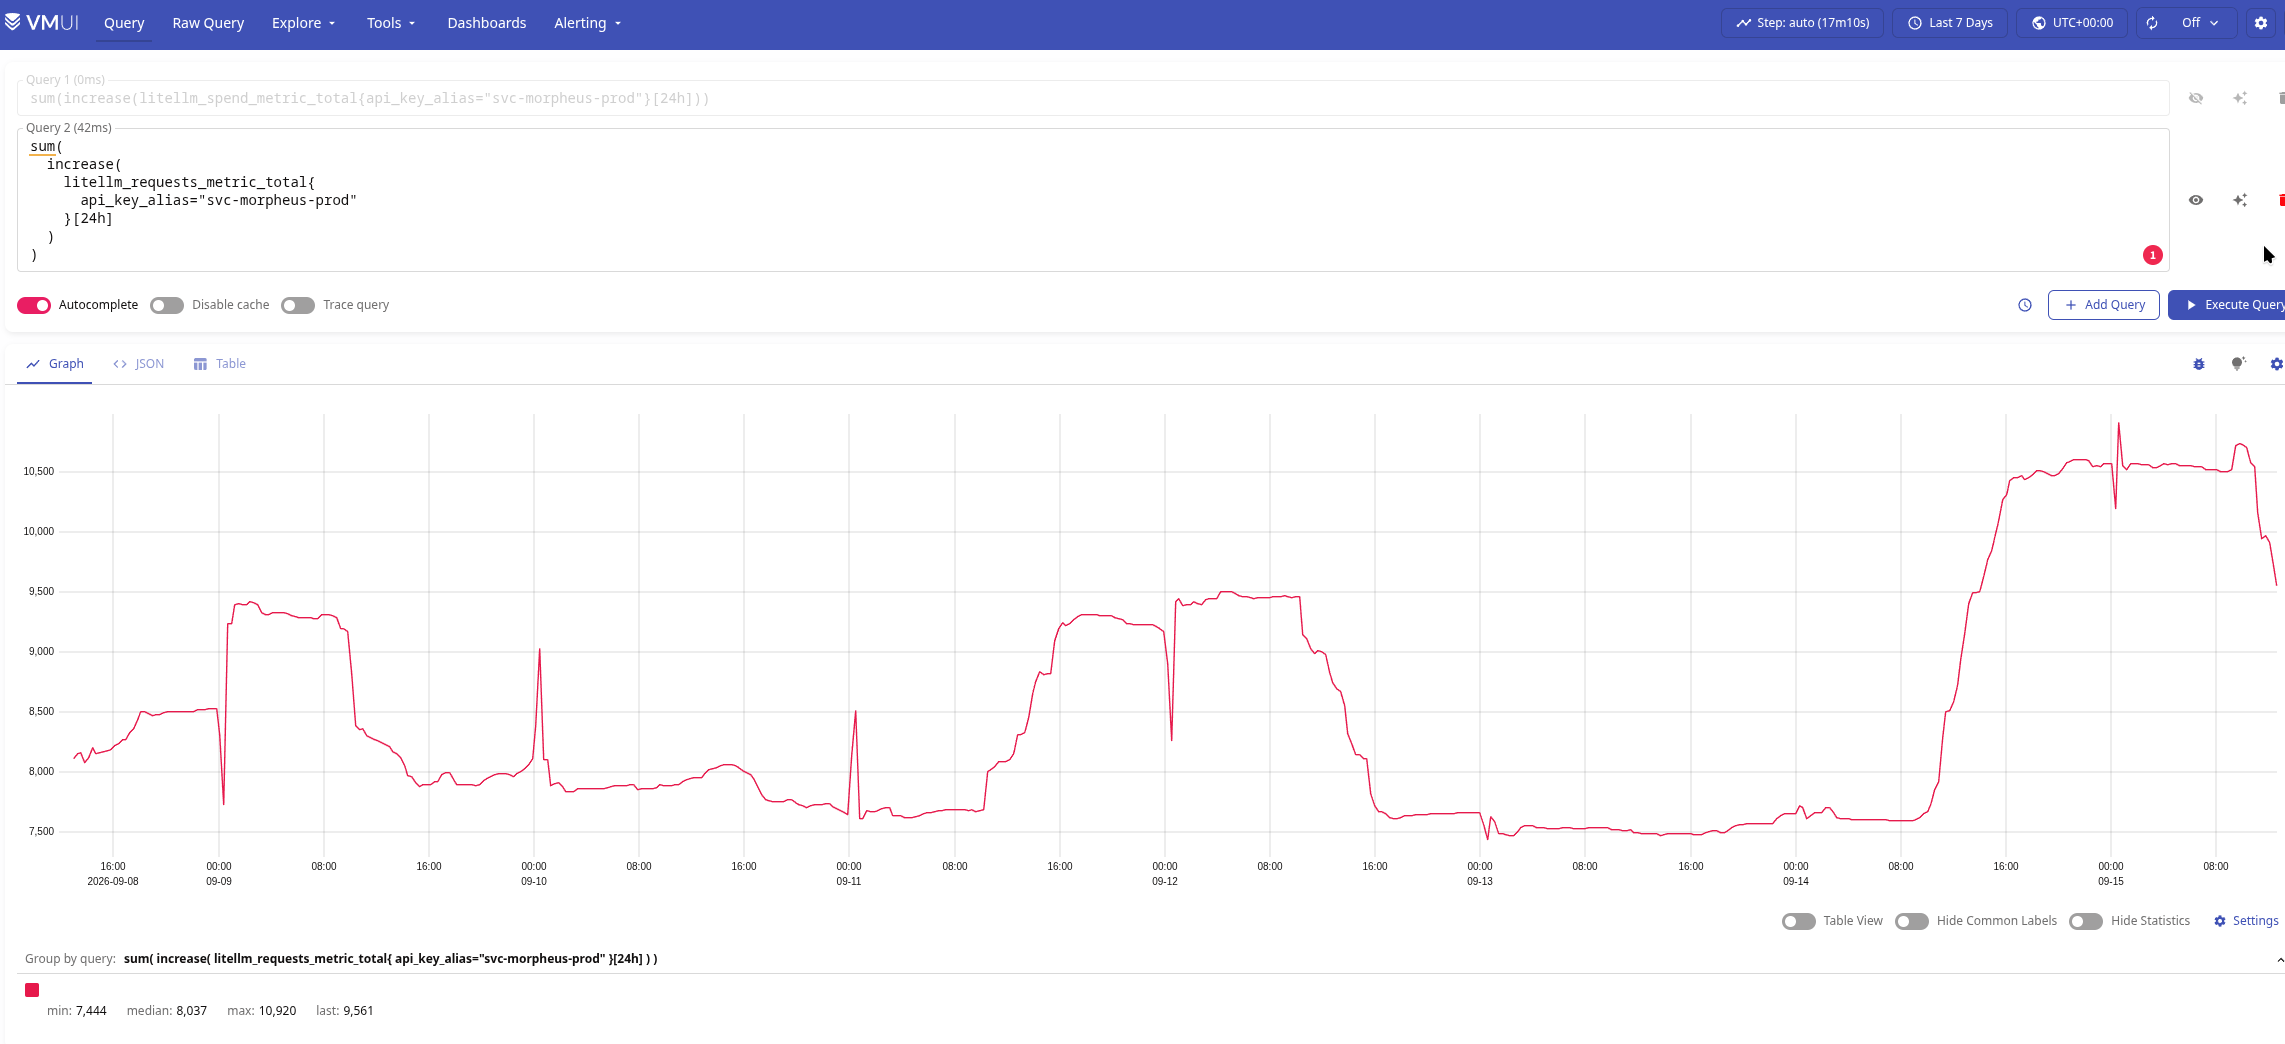
Кількість реквестів росте – але не такий спайк в кілька раз, як на графіку витрат.
Окей – токени? Перевіряємо:
sum(
  increase(
    litellm_total_tokens_metric_total{
      api_key_alias="svc-morpheus-prod"
    }[24h]
  )
)
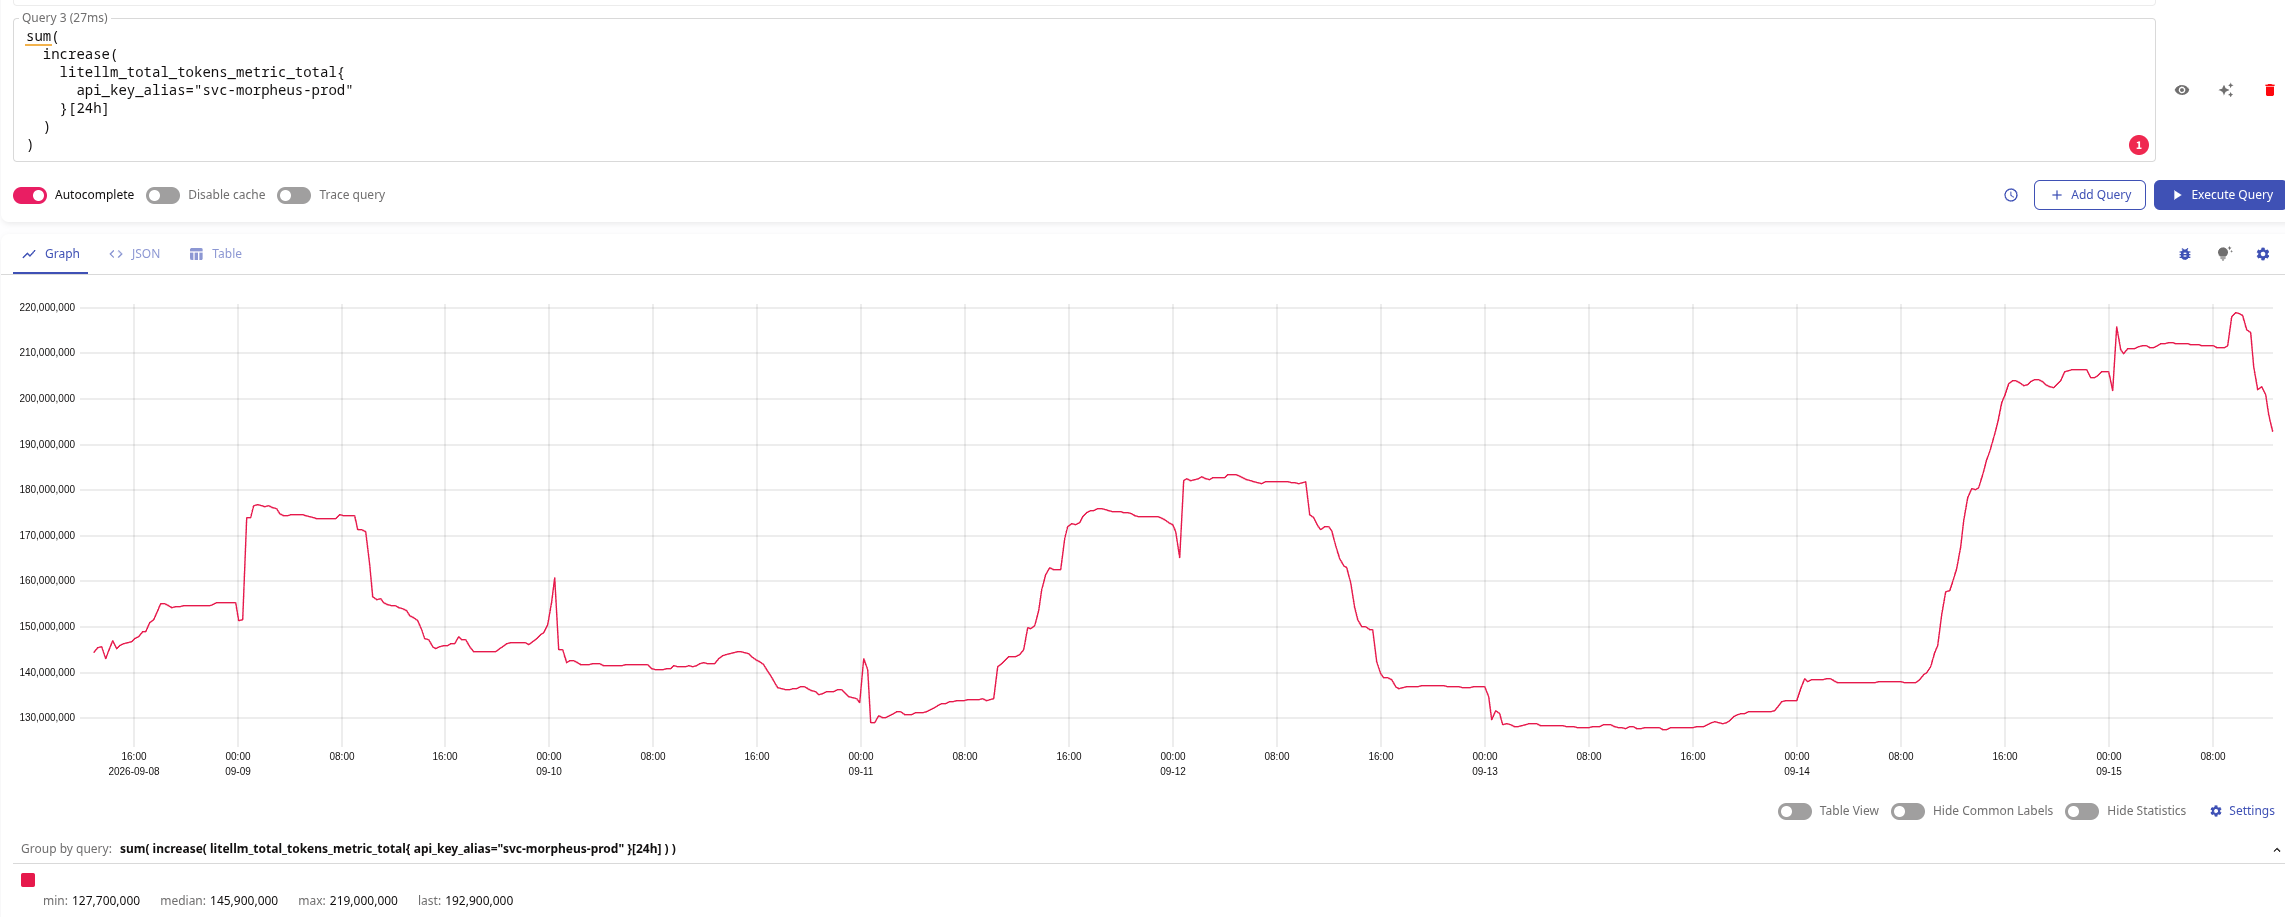
Теж ні.
Да – теж є спайк в останні дні, але не в рази, як на графіку костів.
OpenAI Real Spend vs LiteLLM-Reported Spend
Може – це LiteLLM і метрика litellm_spend_metric_total бреше? Тут я вже був близько – але ще не знав про це 🙂
Перевіримо дані з нашого власного експортеру, який збирає дані напряму з OpenAI API, див Golang: створення OpenAI Exporter для VictoriaMetrics (правда зараз вже інша версія, на Python, але про неї не писав):
max(
  openai_cost_usd_today_total{
    project="litellm-prod"
  }
)
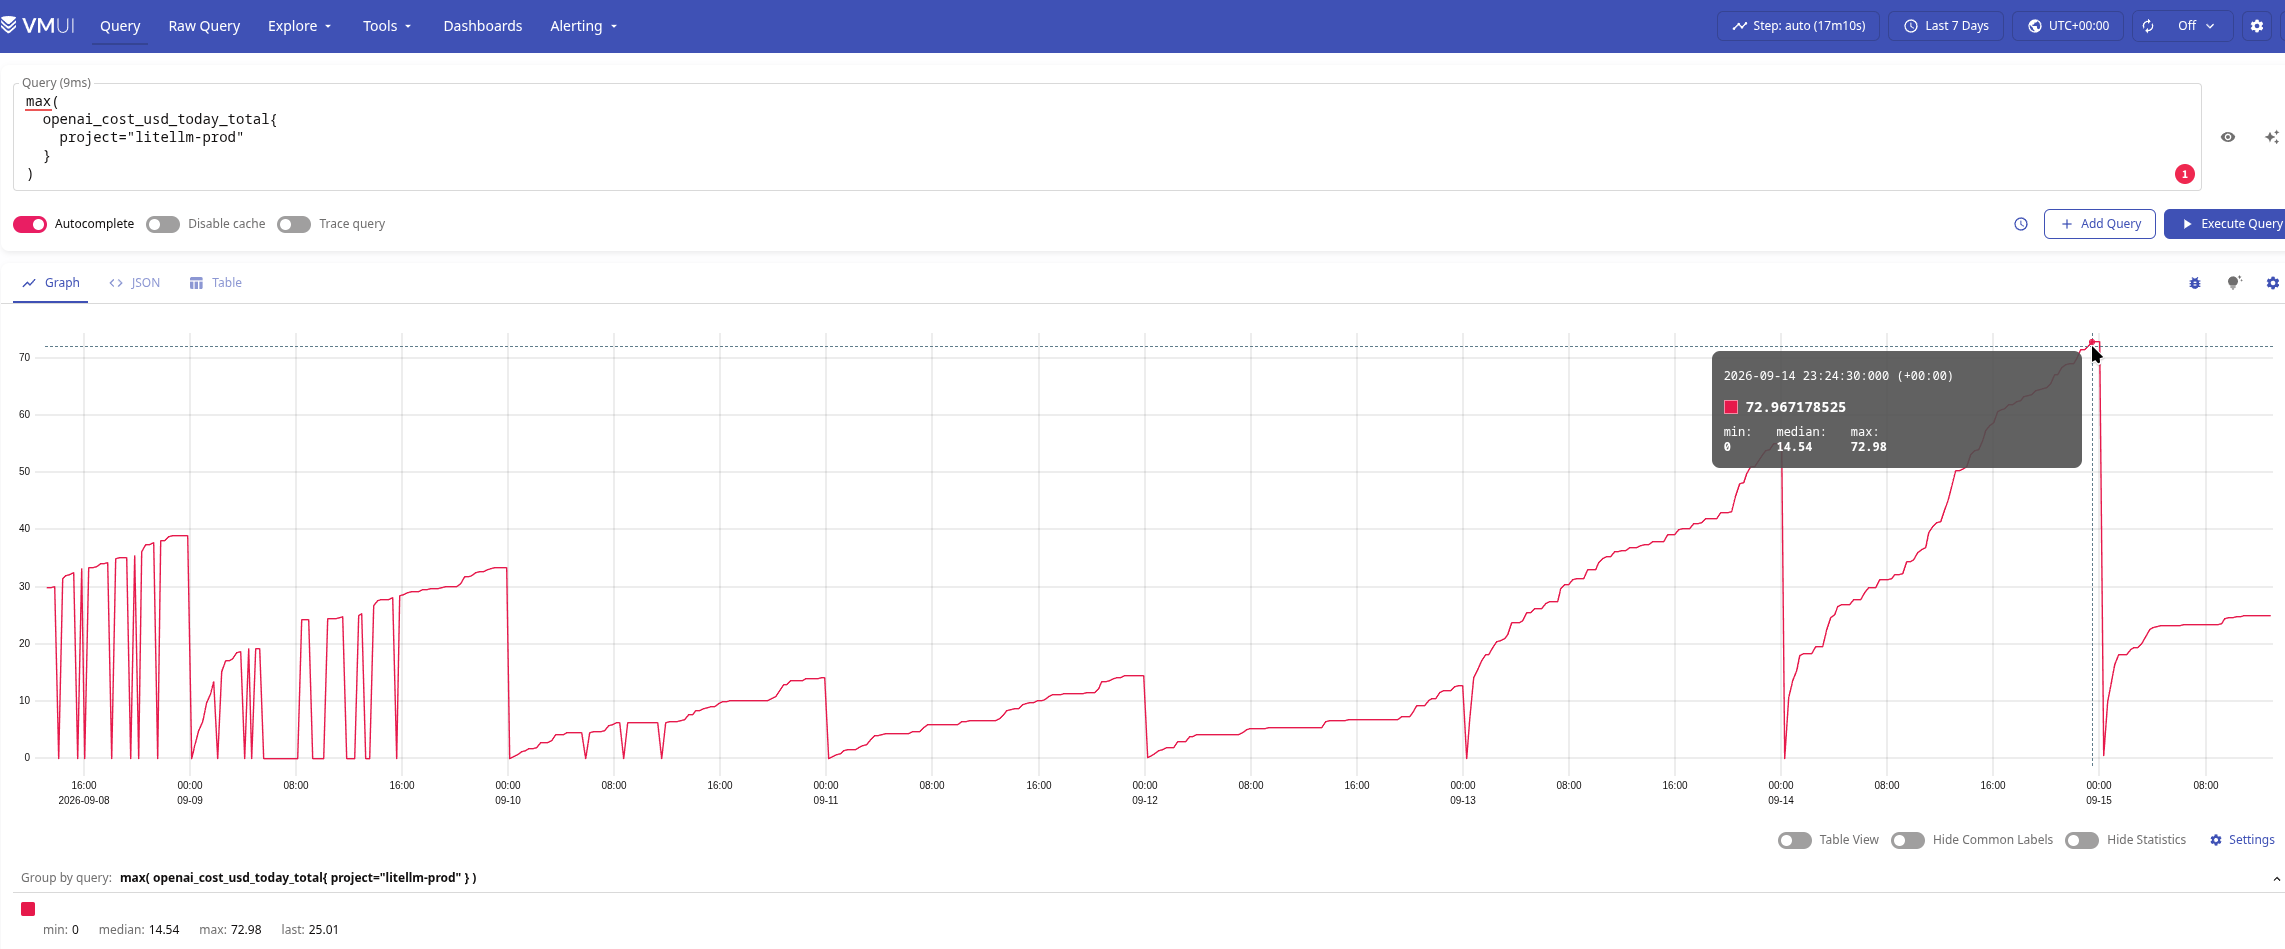
Бачимо 72 за 14-те число – при тому, що до цього витрати були на рівні 30-40 доларів.
Звіримо дані в самому OpenAI Platform Admin Page:
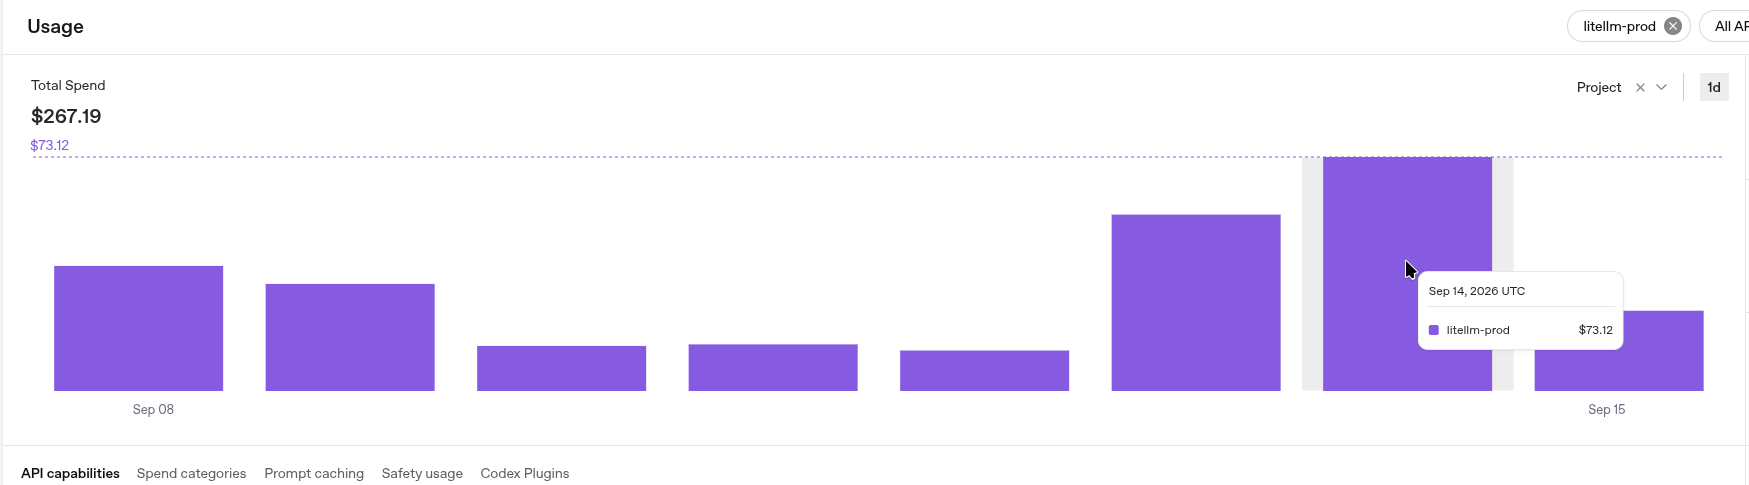
Все сходиться з метрикою openai_cost_usd_today_total, і дійсно – витрати OpenAI з 13-14 числа відчутно зросли.
Чому?
OpenRouter vs OpenAI providers та LiteLLM Fallbacks
Далі подумав, що девелопери переключили модель – почали використовувати якусь дуже дорогу. Це дійсно було так, але проблема була не в цьому – це вже був “side effect” впливу на графік витрати.
Перевіряємо імена моделей, які використовуються для запитів Morpheus:
sum(
  increase(
    litellm_spend_metric_total{
      api_key_alias="svc-morpheus-prod"
    }[1h]
  )
) by (requested_model)
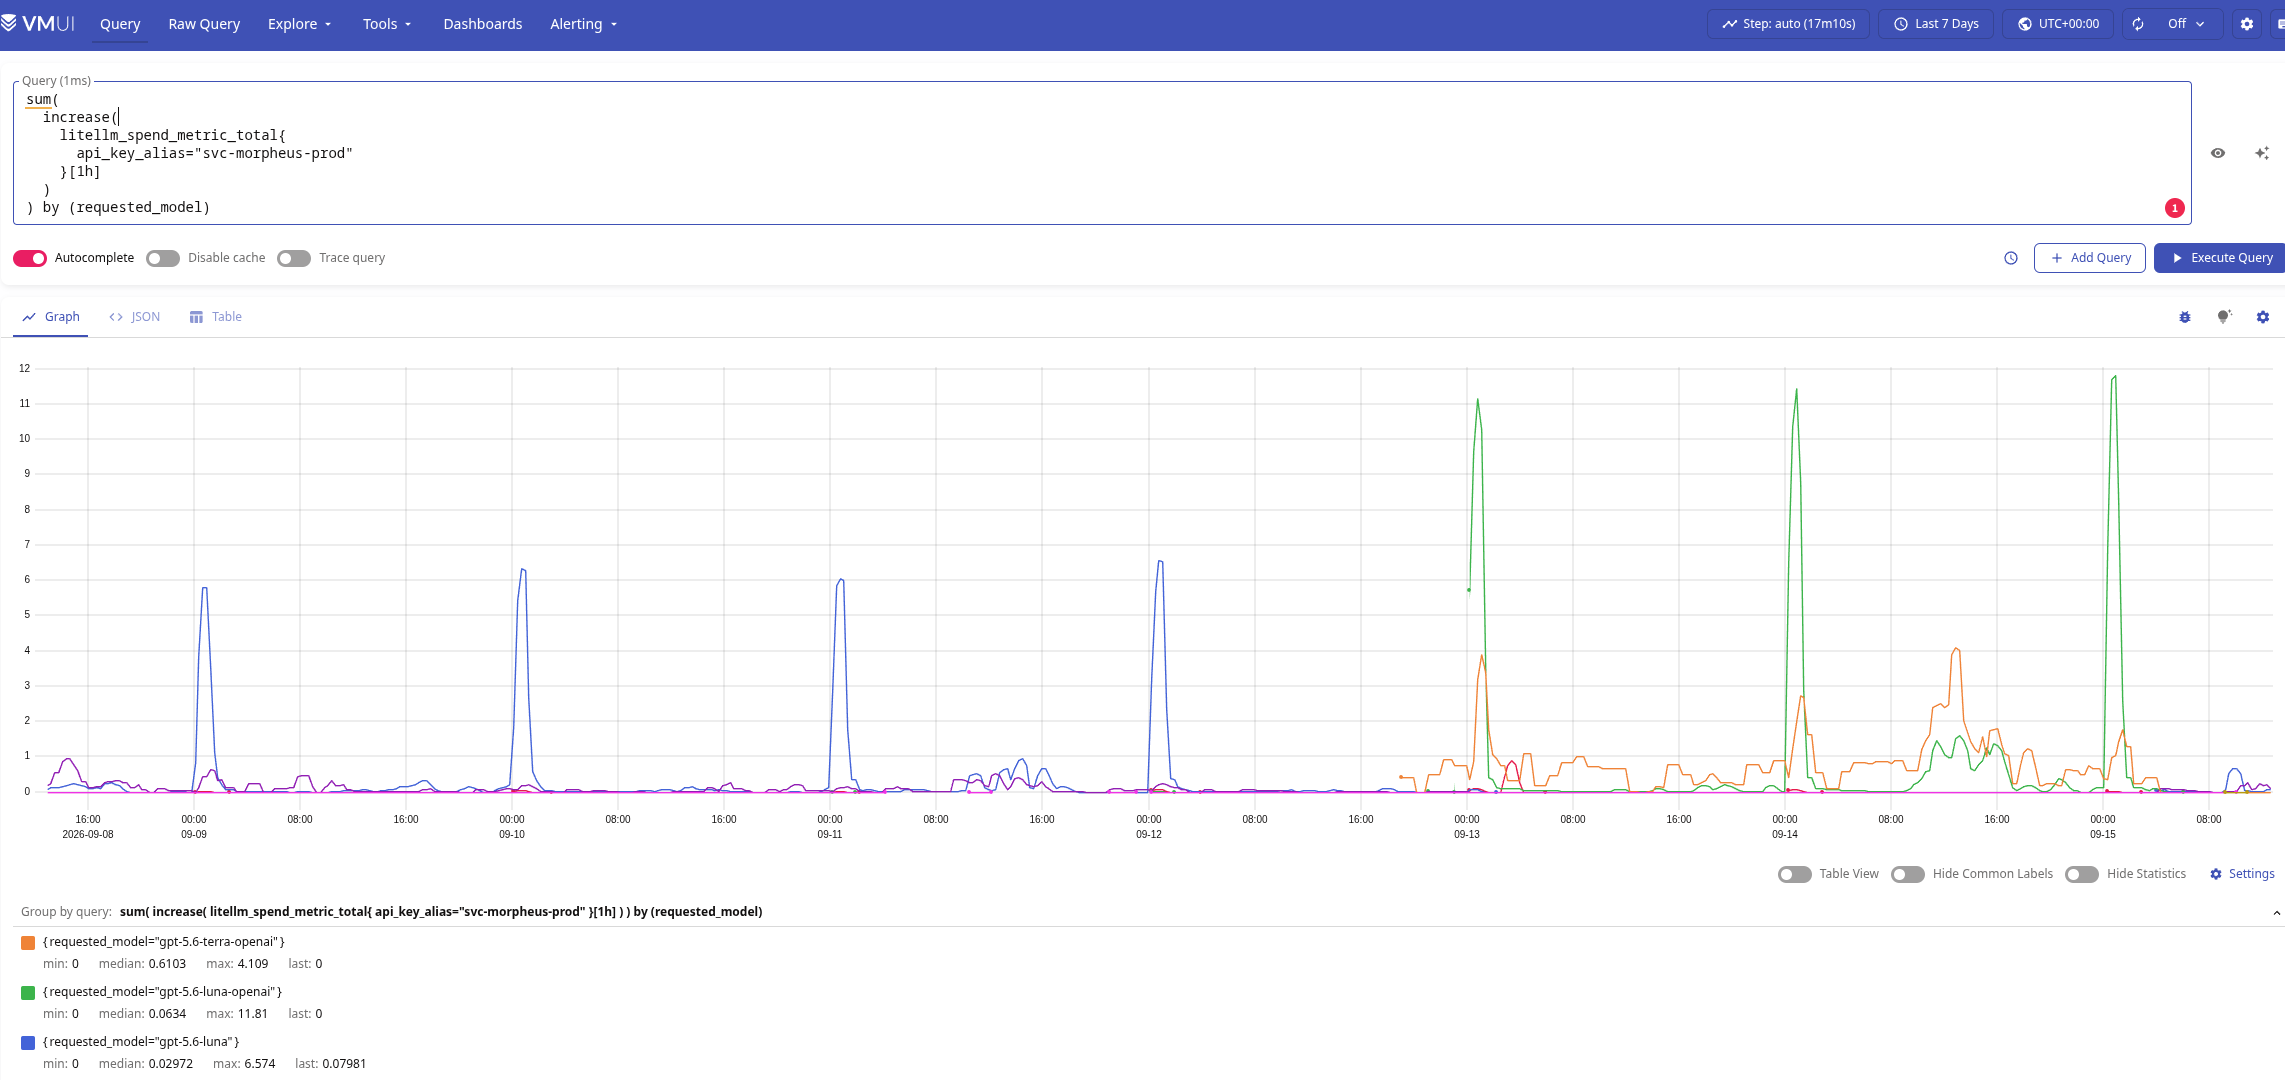
І тут вже бачимо дещо цікаве:
- до 13-го числа – була gpt-5.6-luna
- з 13-го – з’явилась gpt-5.6-luna-openai
- з 13-го – додалась gpt-5.6-terra-openai
Фішка імен тут в тому, що *-openai – це fallback моделі в LiteLLM: gpt-5.6-luna – це запит до OpenRouter, а gpt-5.6-luna-openai – це fallback на OpenAI:
...
    router_settings:
      enable_tag_filtering: true
      fallbacks:
        # OpenRouter primary → direct OpenAI
        - {"gpt-5.6-terra": ["gpt-5.6-terra-openai"]}
        - {"gpt-5.6-luna": ["gpt-5.6-luna-openai"]}
...
Про fallbacks детальніше писав в LiteLLM: OpenRouter та налаштування Fallbacks.
Отже, виходить так, що з 13-го числа запити до OpenRouter почали оброблюватись через direct OpenAI fallback.
Перевіряємо за лейблою api_provider:
sum(
  increase(
    litellm_requests_metric_total{
      api_key_alias="svc-morpheus-prod"
    }[24h]
  )
) by (api_provider)
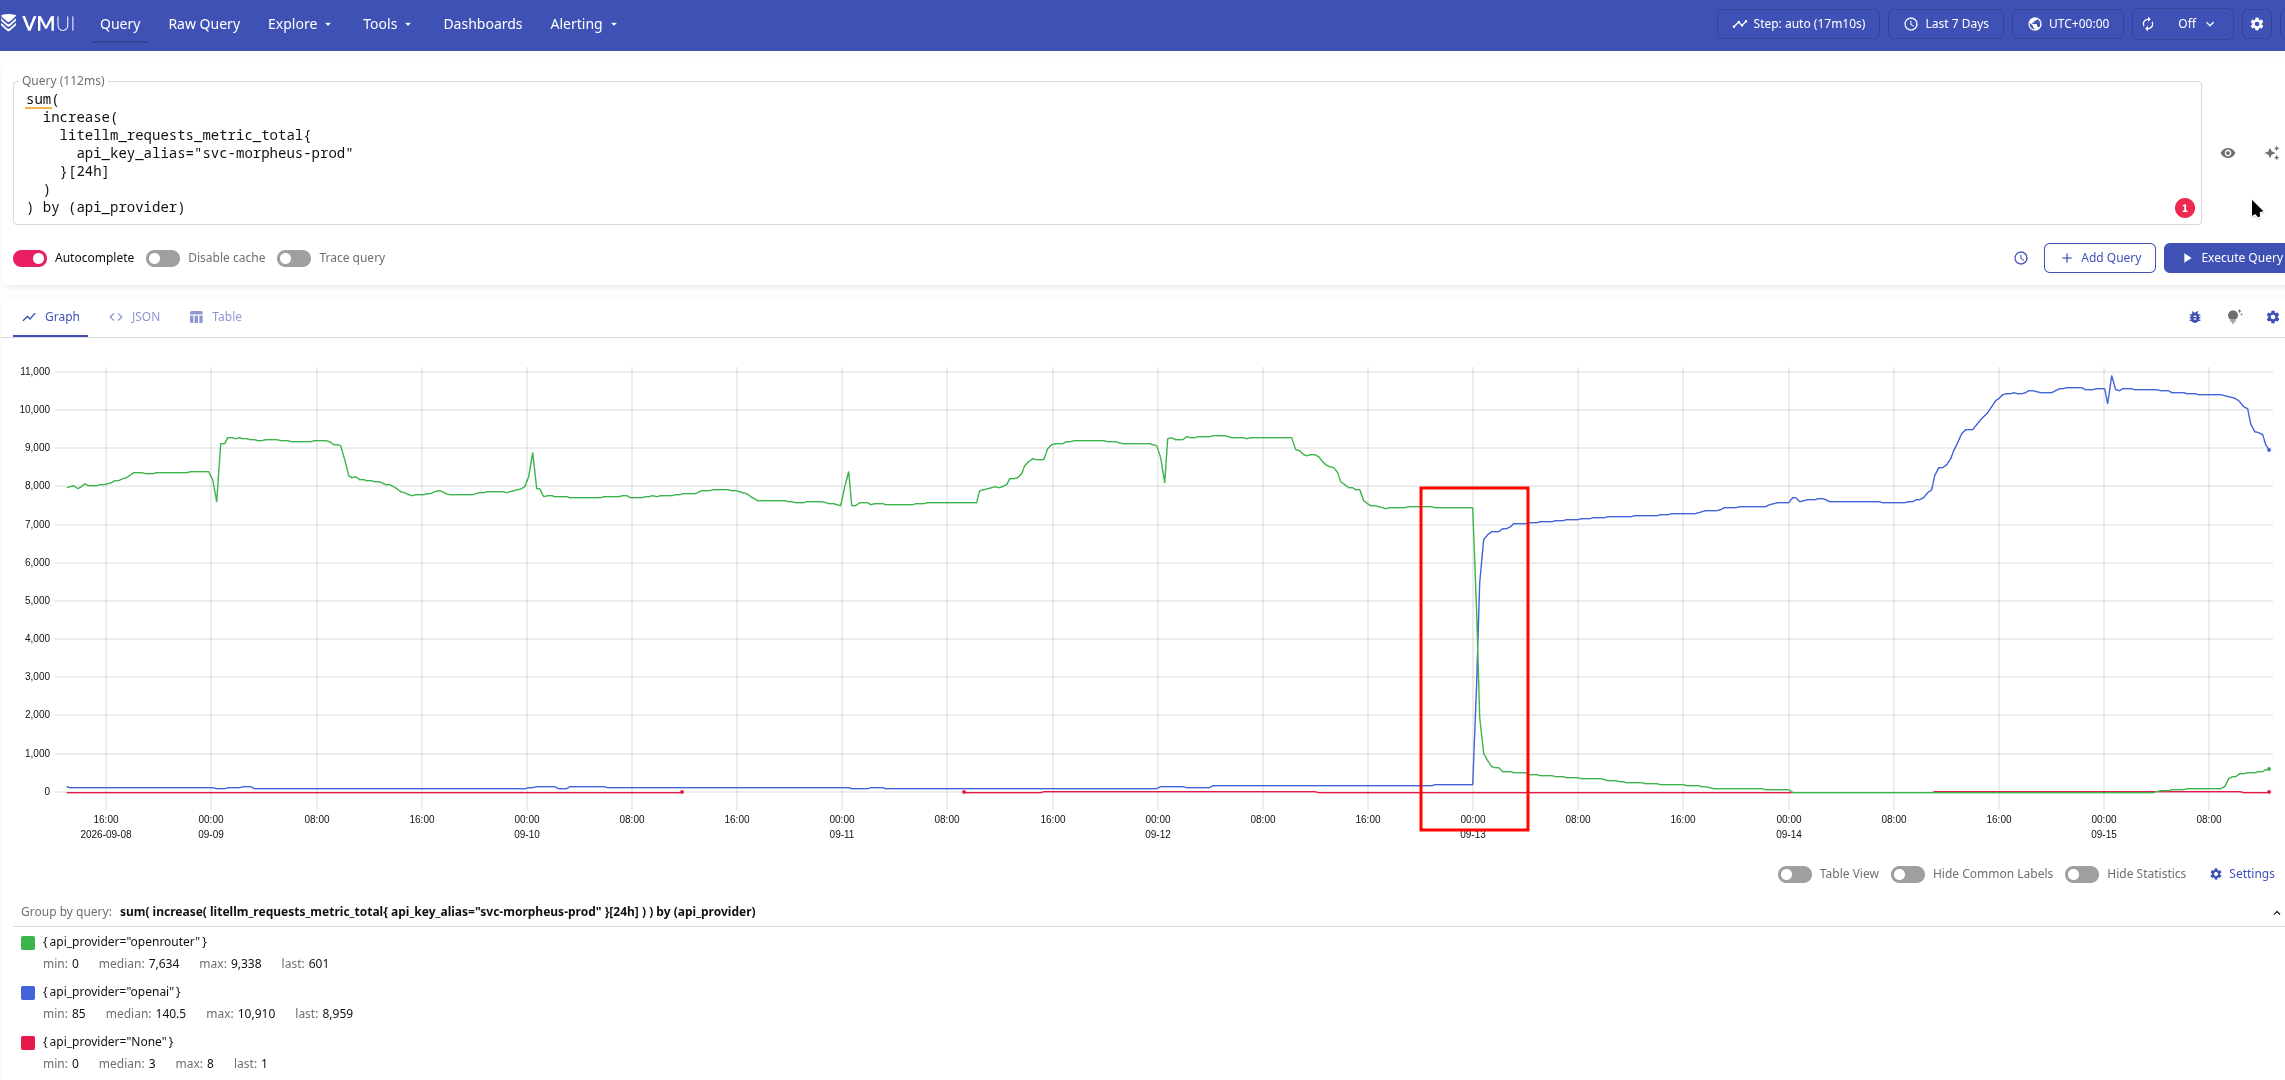
Surprise…
Перевіряємо спрацювання fallbacks:
sum(
  increase(
    litellm_deployment_successful_fallbacks_total{
      api_key_alias="svc-morpheus-prod"
    }[24h]
  )
) by (
  requested_model,
  fallback_model,
  exception_class,
  exception_status
)
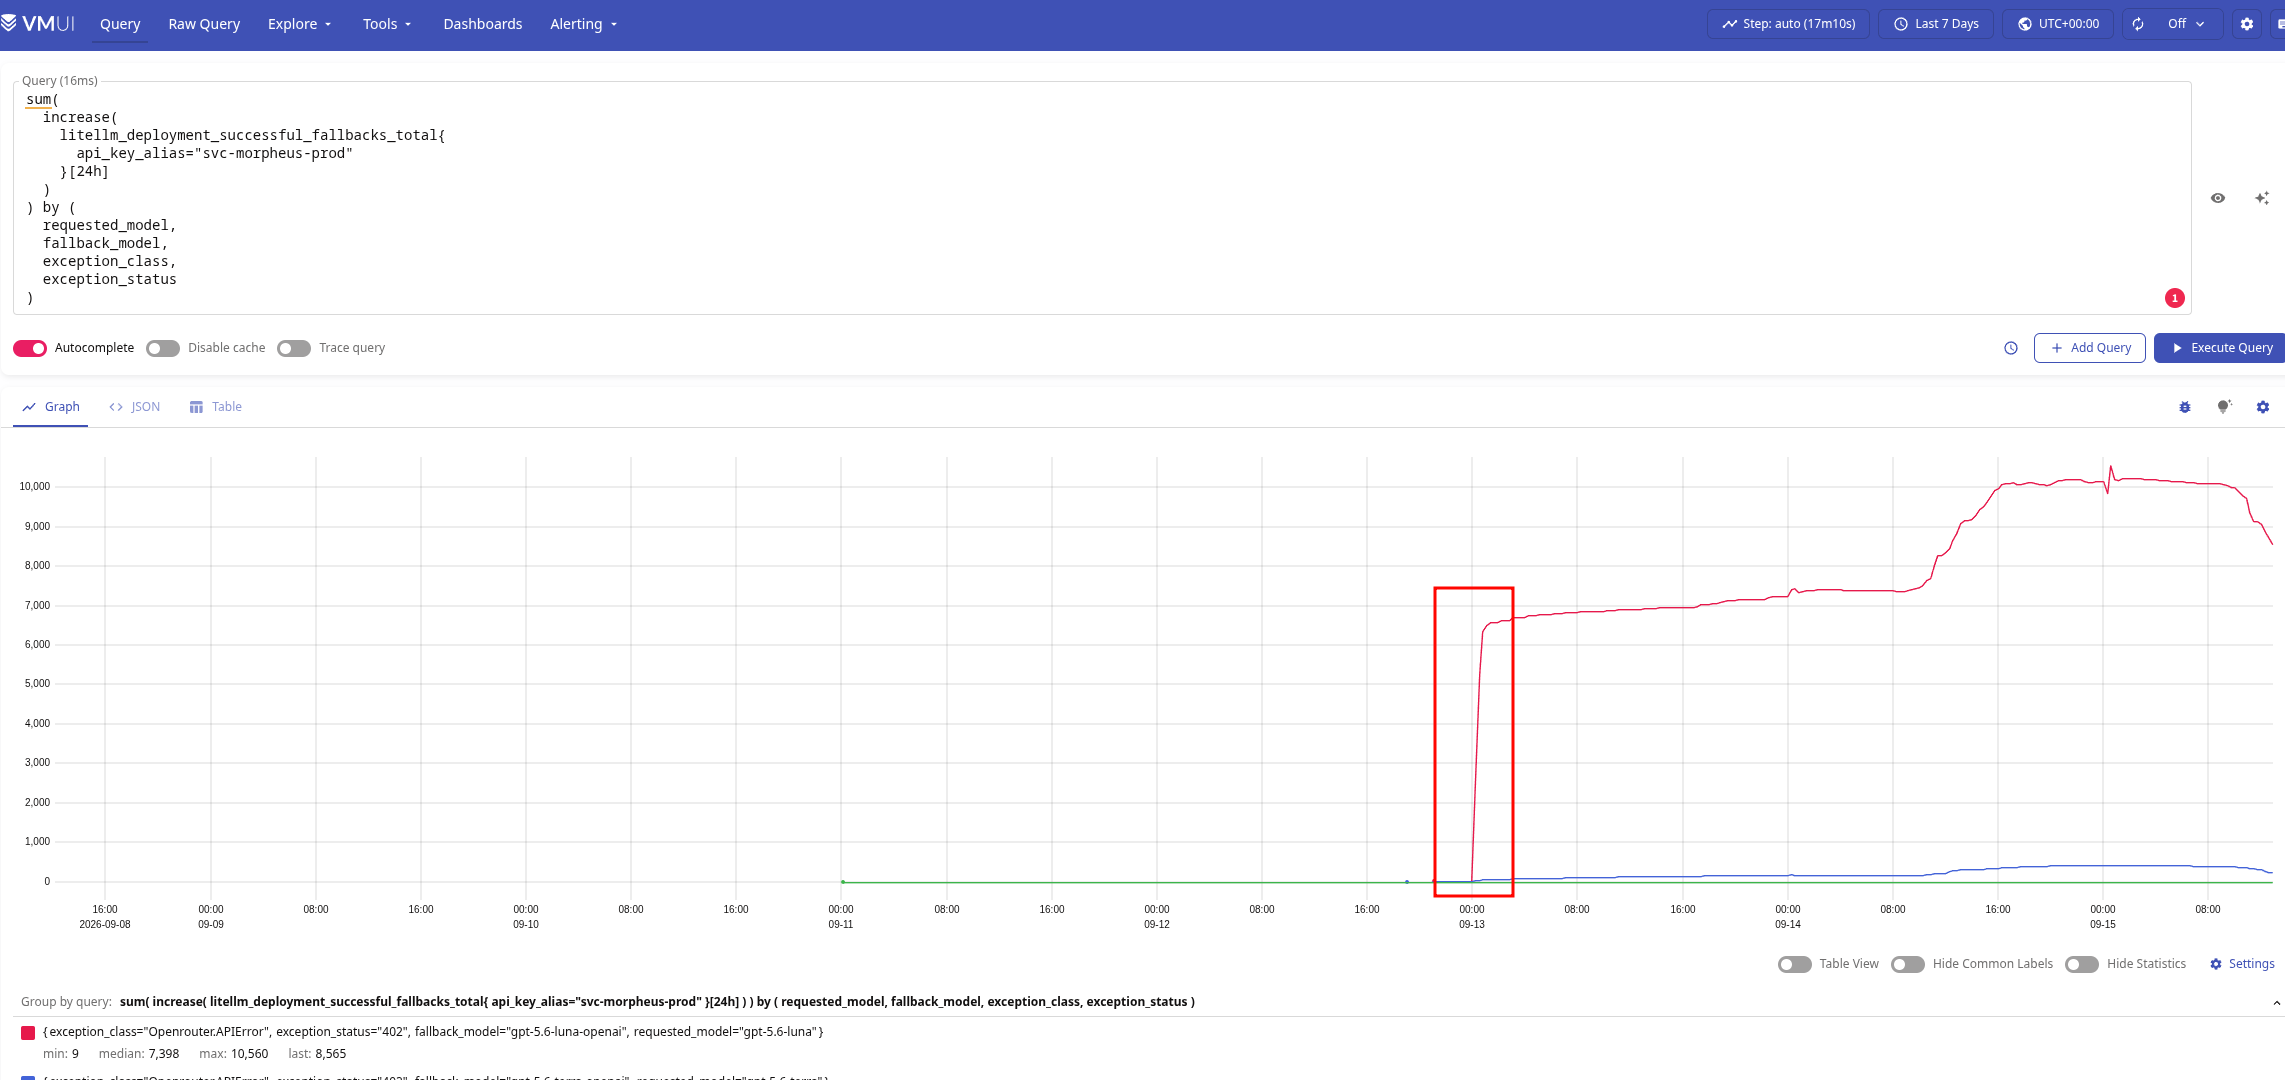
Да – з 13-го числа ми постійно фолбечимось.
Чому саме – можемо глянути в трейсах від LiteLLM (запит для VictoriaTraces):
{
  resource_attr:service.name="litellm",
  name=~"^chat gpt-5.6-(luna|terra)$"
}
_time:4d
"span_attr:litellm.metadata.user_api_key_alias":="svc-morpheus-prod"
"event:event_attr:exception.message:0":*
| stats by (
    "event:event_attr:exception.type:0",
    "event:event_attr:exception.message:0"
  )
    count() as errors
| sort by (errors) desc
| limit 50
Де бачимо причину:
litellm.APIError: APIError: OpenrouterException – {“error”:{“message”:”This request requires more credits, or fewer max_tokens. You requested up to 16384 tokens, but can only afford 1549. To increase, visit https://openrouter.ai/settings/credits and add more credits”,”code”:402,”metadata”:{“limit_source”:”openrouter_credits”,”remedy_hint”:”Add credits at https://openrouter.ai/settings/credits, or lower max_tokens / prompt size to fit your remaining balance.”,”provider_name”:null}}
Нема грошей на акаунті?
А що у нас з кредитами?
Для OpenRouter у нас є власний експортер, аналогічний до OpenAI – глянемо, що там:
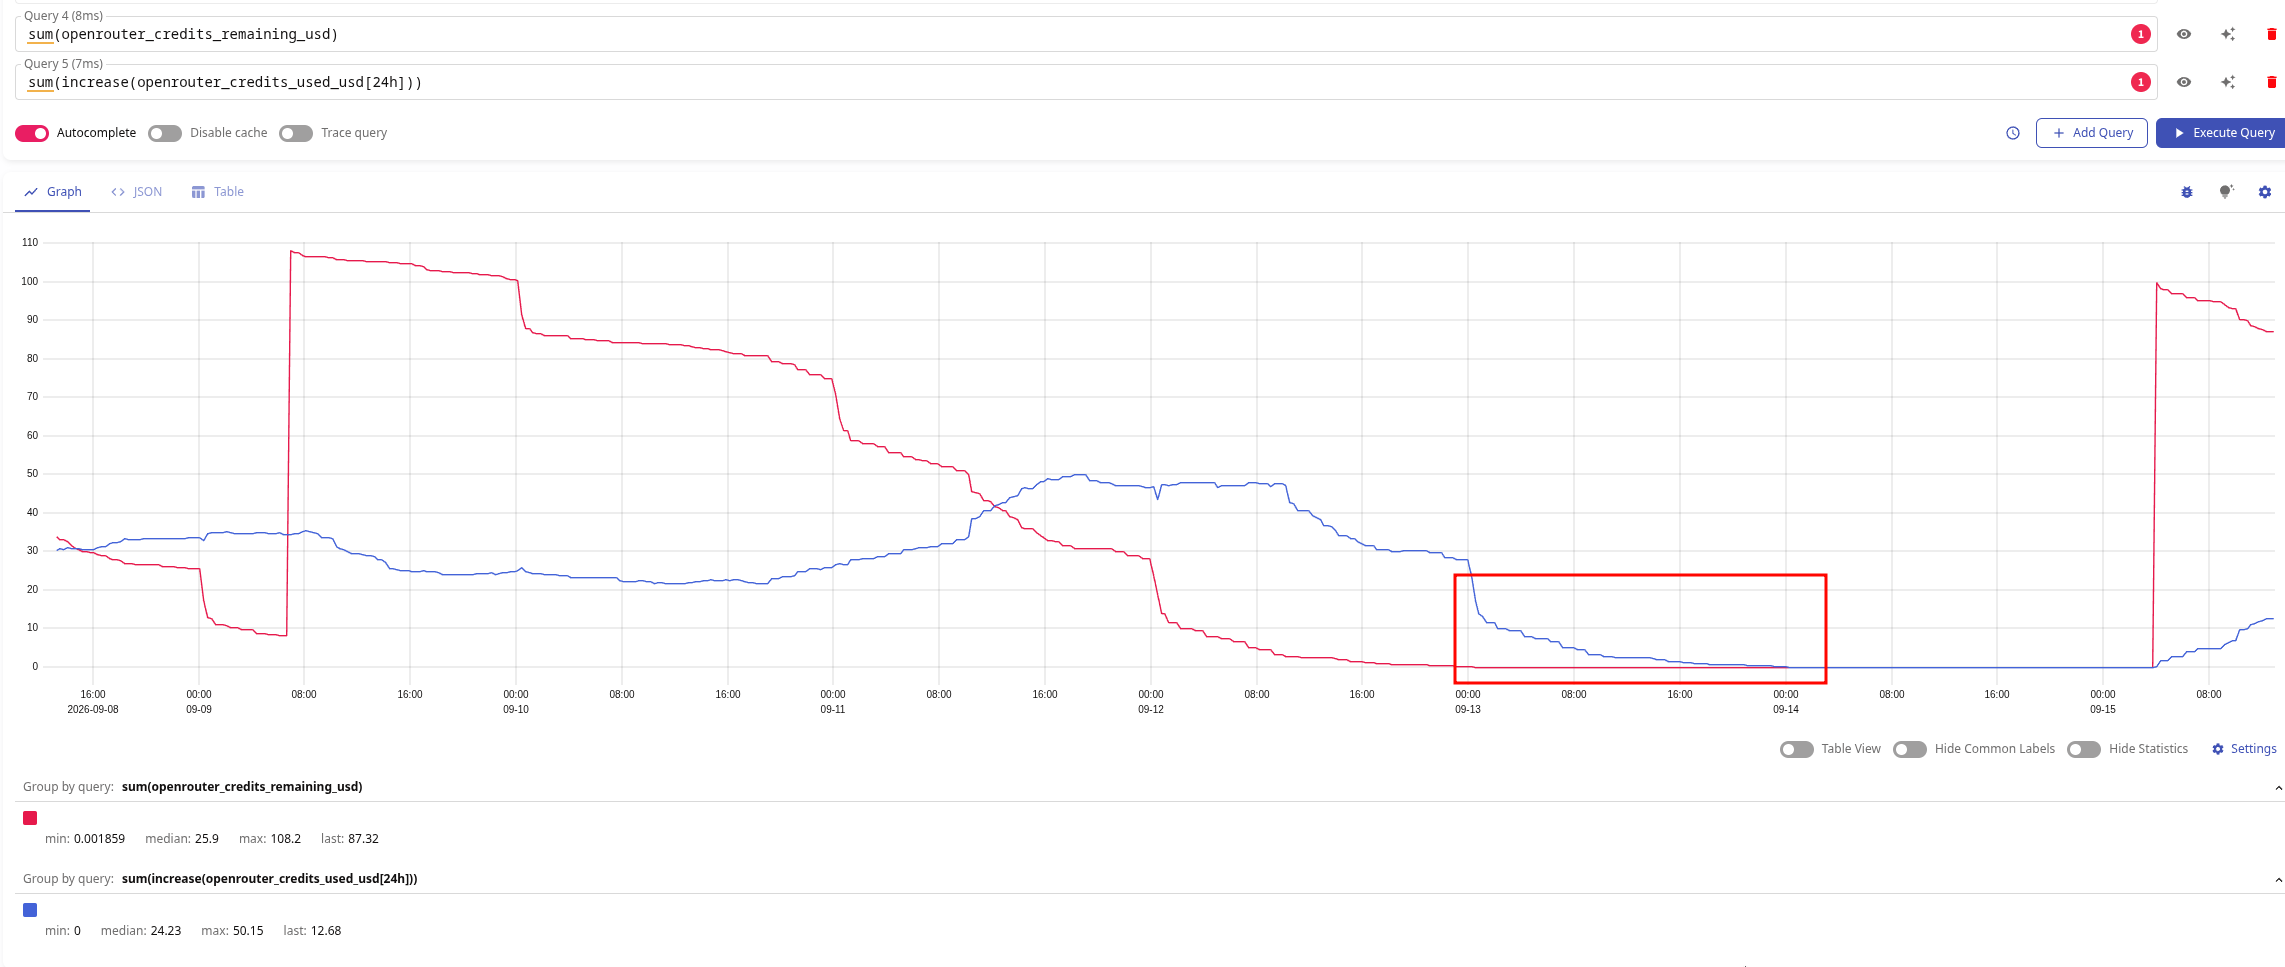
Дійсно – на OpenRouter акаунті у нас просто закінчились гроші.
Цікаво, що алерти-то були – але ми їх успішно про*бали.
Note: це, звісно, не ок, але один з плюсів роботи в стартапі, який ще не в маркеті: critical алерти на Production – “не справжні” critical. У нас навіть нема бота, який в таких випадках дзвонить на телефон – тільки алерти в Slack.
The Current Summary
Аби простіше було рухатись далі – підсумок того, що виявлено на даний момент:
- в LiteLLM спайк витрат з 10-12 доларів до 40-45 на день, почався 13-го числа
- кількість токенів і реквестів росте – але набагато менше (це чисто робота сервісу)
- виявили, що LiteLLM почав перенаправляти всі запити на OpenAI fallback models – бо на OpenRouter закінчились гроші, і в LiteLLM постійно працює fallback
Йдемо далі.
Перше питання: то це дійсно якийсь неочікуваний спайк використання LLM-провайдерів – чи ми і раніше стільки витрачали?
На спайк використання не схоже, бо ми вже перевірили реквести і токени – там все виглядає адекватно.
Друге питання: чому в LiteLLM ми бачимо спайк витрат саме з 13-14 числа?
Checking LLM Providers Spending vs LiteLLM reported
Вже робили вище, але тут я дійшов як раз до питання “то це дійсно якийсь неочікуваний спайк використання LLM-провайдерів – чи ми і раніше стільки витрачали?” – і зібрав все до купи.
Отже, у нас є дані по витратам від самого LiteLLM, і є дані від OpenAI та OpenRouter – і те, що ми збираємо власними експортерами через API, і те, що можемо просто побачити в адмінках провайдерів.
Перевіряємо OpenAI:
max(
  max_over_time(
    openai_cost_usd_today_total{
      project="litellm-prod"
    }[1d]
  )
)
Перевіряємо OpenRouter:
max(
  increase(
    openrouter_credits_used_usd[1d]
  )
)
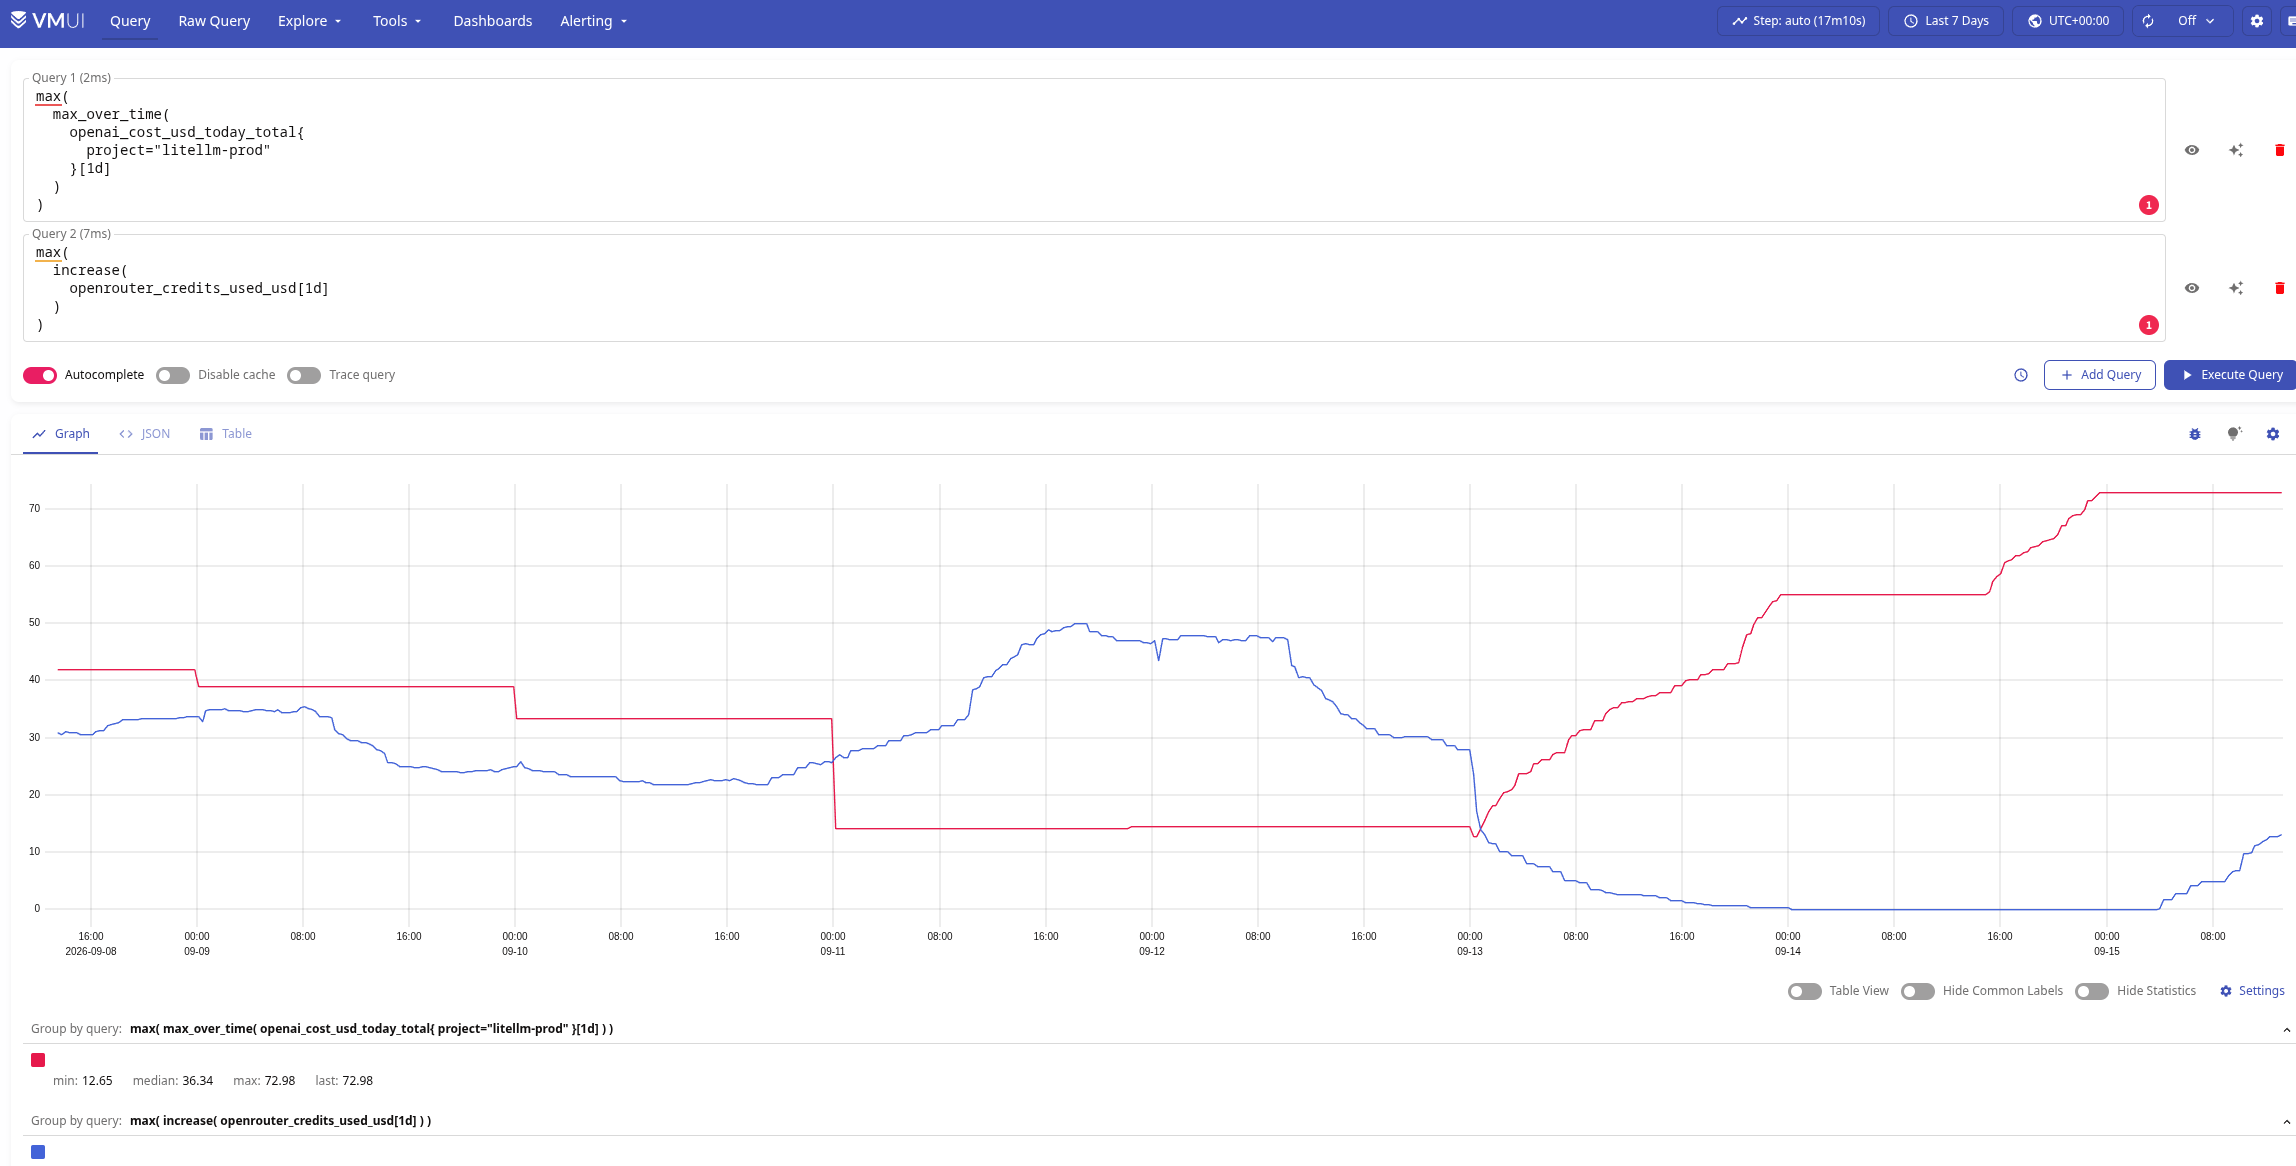
Не довіряємо собі і своєму моніторингу – може, експортери десь криво збирають інформацію? – і йдемо “подивитись власними очима” в адмін-панелях провайдерів.
OpenAI вже бачили вище:
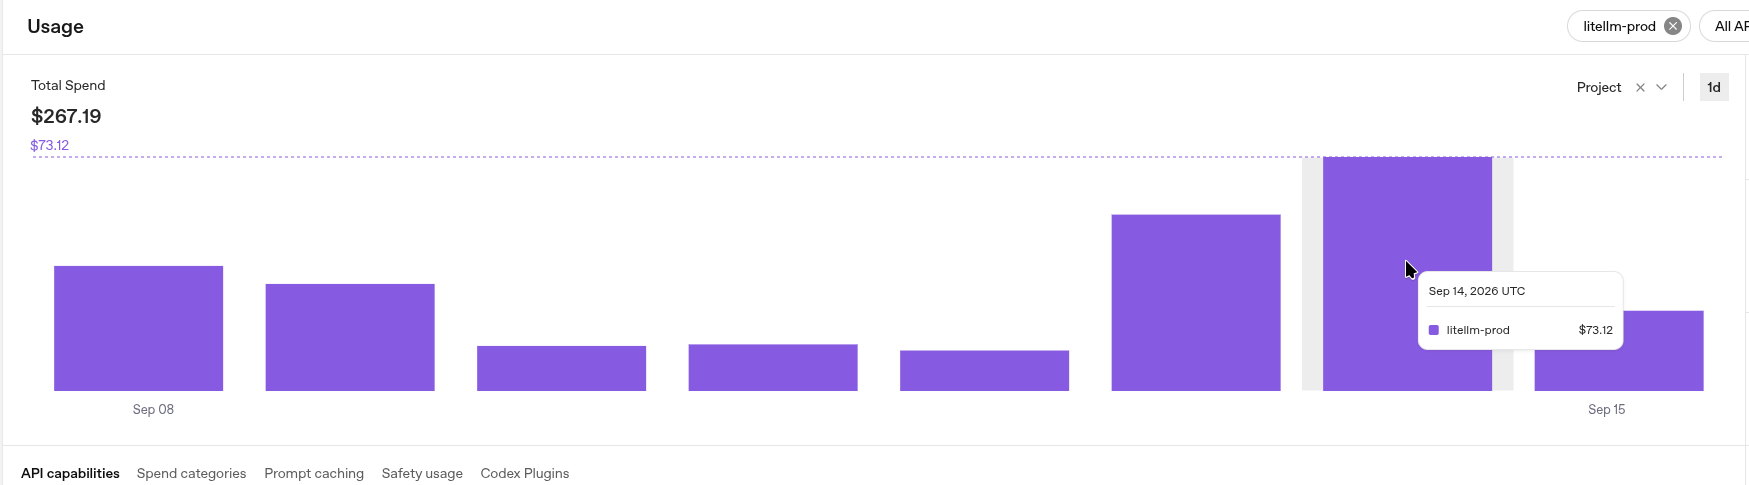
На OpenAI і раніше були витрати, наприклад, 8-9 вересня – бо частина наших сервісів ходила напряму. Але з 13-14 ще додались клієнти, які раніше ходили на OpenRouter – і витрати зросли майже вдвічі.
Перевіряємо дані в OpenRouter:
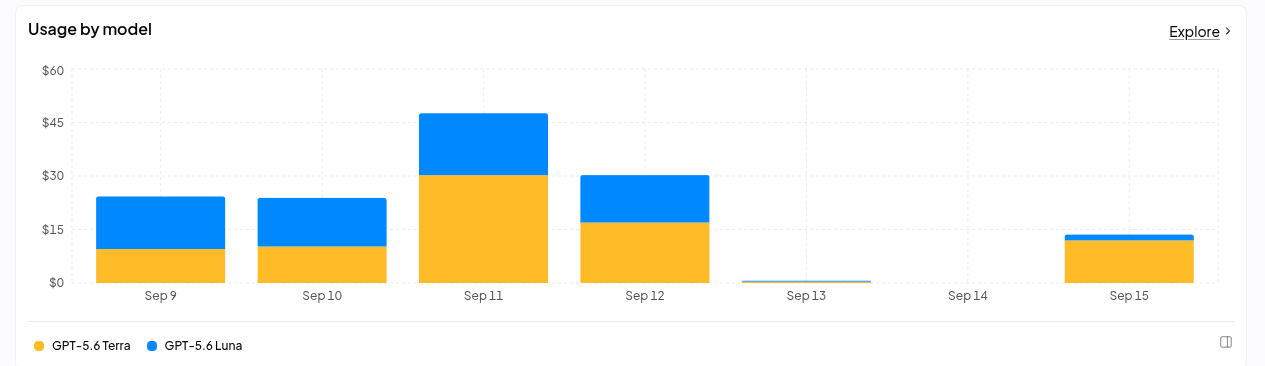
Тут все сходиться з тим, що ми бачили з наших метрик (кольори, до речі, чудові 🙂 )
Але ж – в LiteLLM ми бачимо зовсім іншу картину:
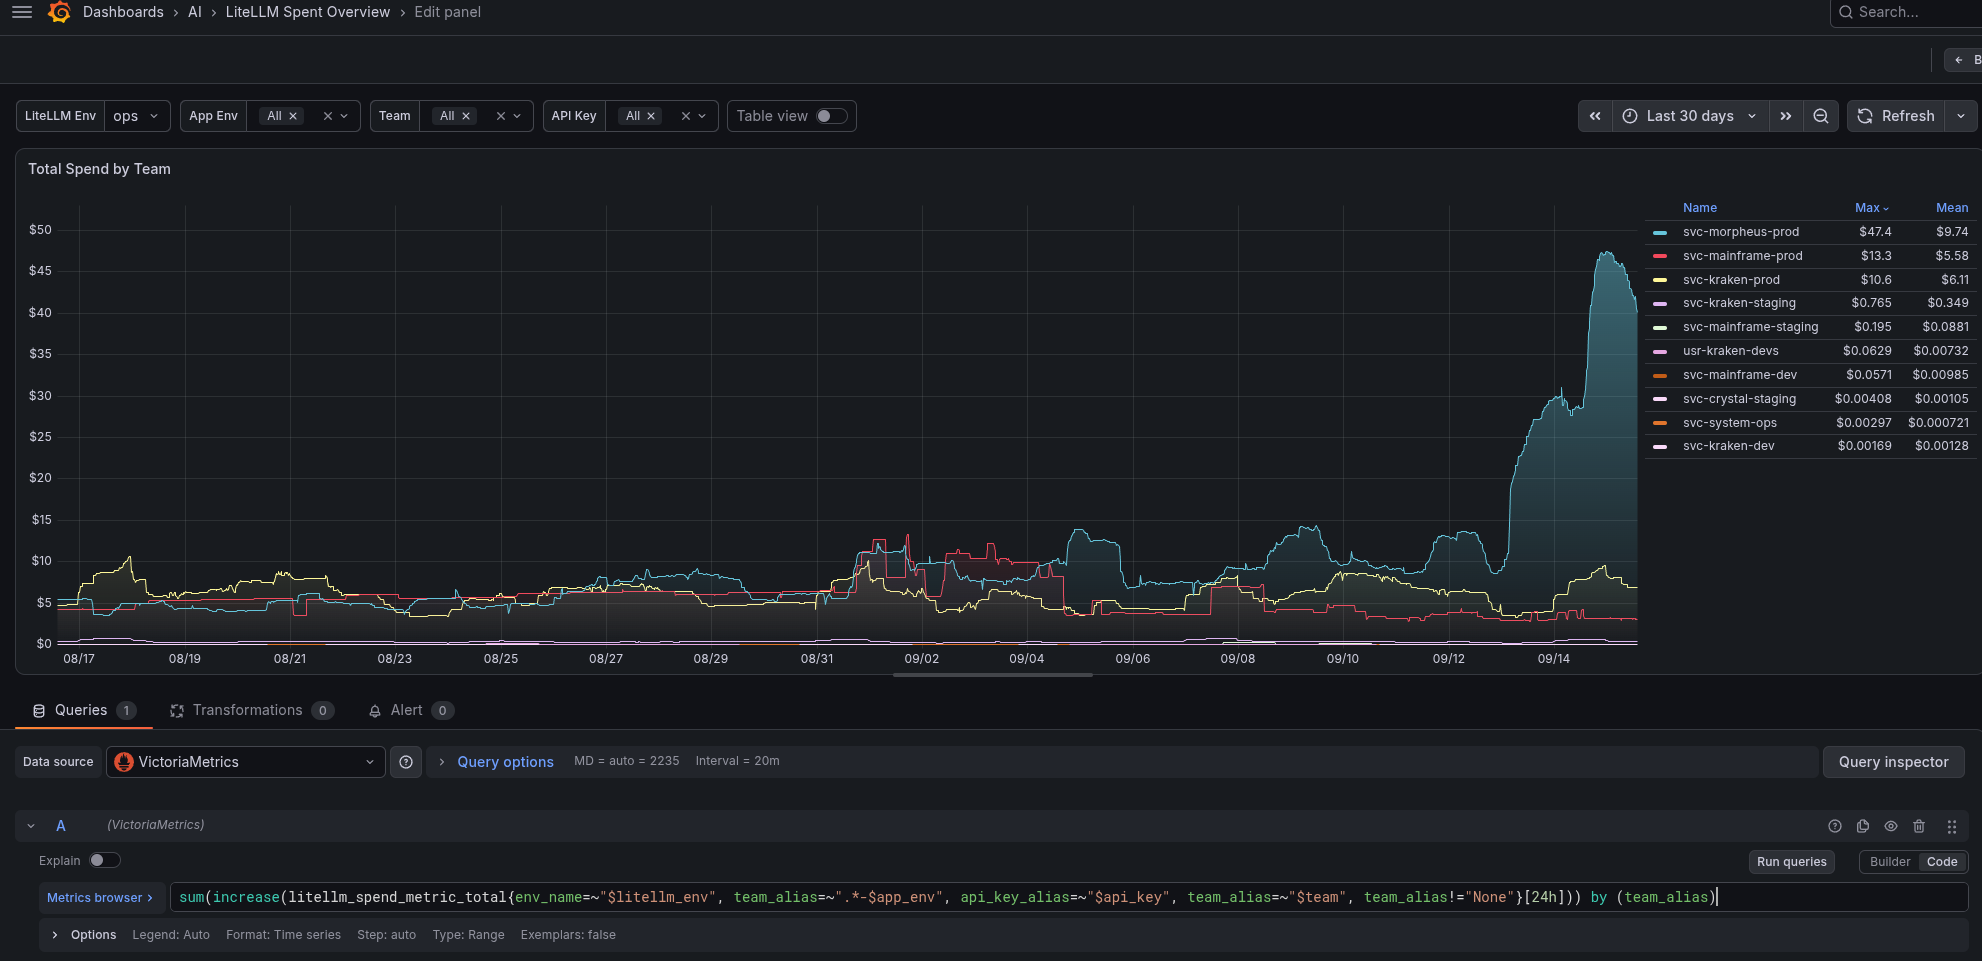
Дуже різкий спайк – майже в 5 разів!
І, як ми вже впевнились в тому, що метрики провайдерів у нас повертають правильні значення – глянемо всі три графіки разом:
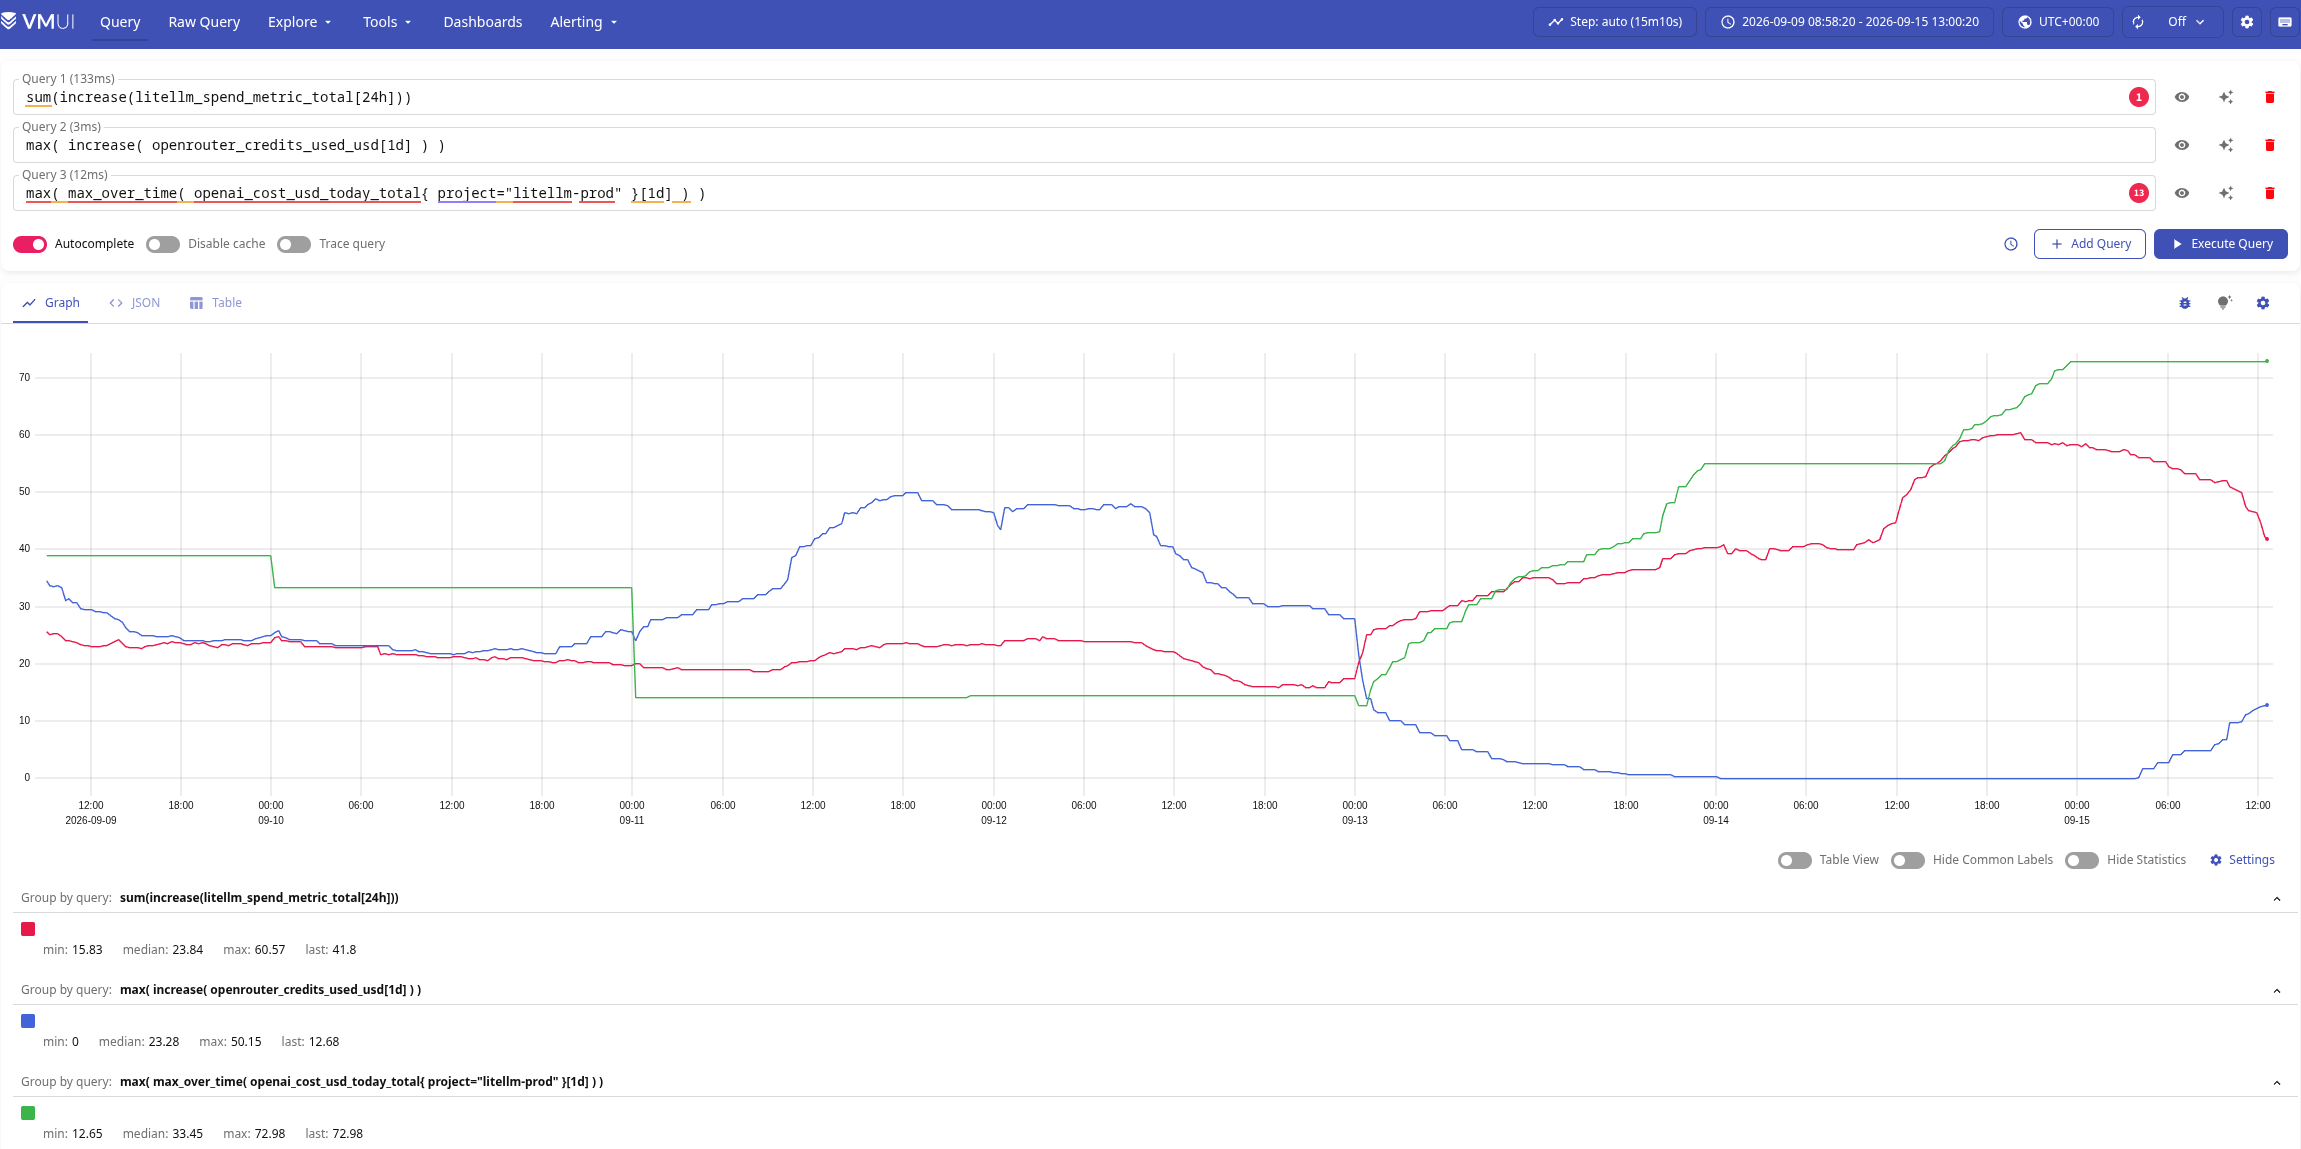 Тут:
- синя лінія – OpenRouter, до 13-го числа середнє значення 20-50 доларів
- зелена лінія – OpenAI, до 13-го числа середнє значення 20-40 доларів
- червона лінія – LiteLLM, до 13-го числа середнє значення 15-20 доларів
Тобто сумарно OpenRouter + OpenAI ну ніяк не міг бути в межах 15-20 USD, які нам бодро рапортує LiteLLM!
OpenRouter, Responses API та LiteLLM Bug
Що дуже добре видно на графіку вище – це те, шо до 13-го числа головна розбіжність в даних від LiteLLM і провайдерів – саме між LiteLLM та OpenRouter.
Моделі на OpenRouter у нас використовуються тільки одним сервісом, власне тим самим api_key_alias="svc-morpheus-prod" в прикладах запитів вище, а цей сервіс використовує Responses API – і ось тут і знайшлась причина цієї розбіжності.
Є відкрита GitHub Issue – OpenRouter Responses API (aresponses) never tracks cost — spend logged as $0 despite real usage, є PR з фіксом – fix(openrouter): track cost for Responses API requests, але на даний момент він ще не змержений.
До Responses API і OpenRouter докопався, коли аналізував трейси від LiteLLM – перевіряв значення атрибуту litellm.cost.total і звернув увагу на те, що в трейсах від Morpheus атрибут litellm.call_type всюди має значення “aresponses“.
Далі просто дивимось як LiteLLM рахує витрати для OpenAI та OpenRouter.
Запит до VictoriaTraces:
{
  resource_attr:service.name="litellm",
  name=~"^chat gpt-5.6-(luna|terra)(-openai)?$"
}
_time:7d
"span_attr:litellm.metadata.user_api_key_alias":="svc-morpheus-prod"
"span_attr:litellm.call_type":="aresponses"
"span_attr:gen_ai.usage.total_tokens":*
| stats by (
    name,
    "span_attr:litellm.provider.model",
    "span_attr:litellm.call_type"
  )
    count() as completed_requests,
    sum("span_attr:gen_ai.usage.input_tokens") as input_tokens,
    sum("span_attr:gen_ai.usage.output_tokens") as output_tokens,
    sum("span_attr:gen_ai.usage.total_tokens") as total_tokens,
    sum("span_attr:litellm.cost.total") as recorded_cost
| math
    1000000 * recorded_cost / total_tokens
    as cost_per_million_tokens
| sort by (completed_requests) desc
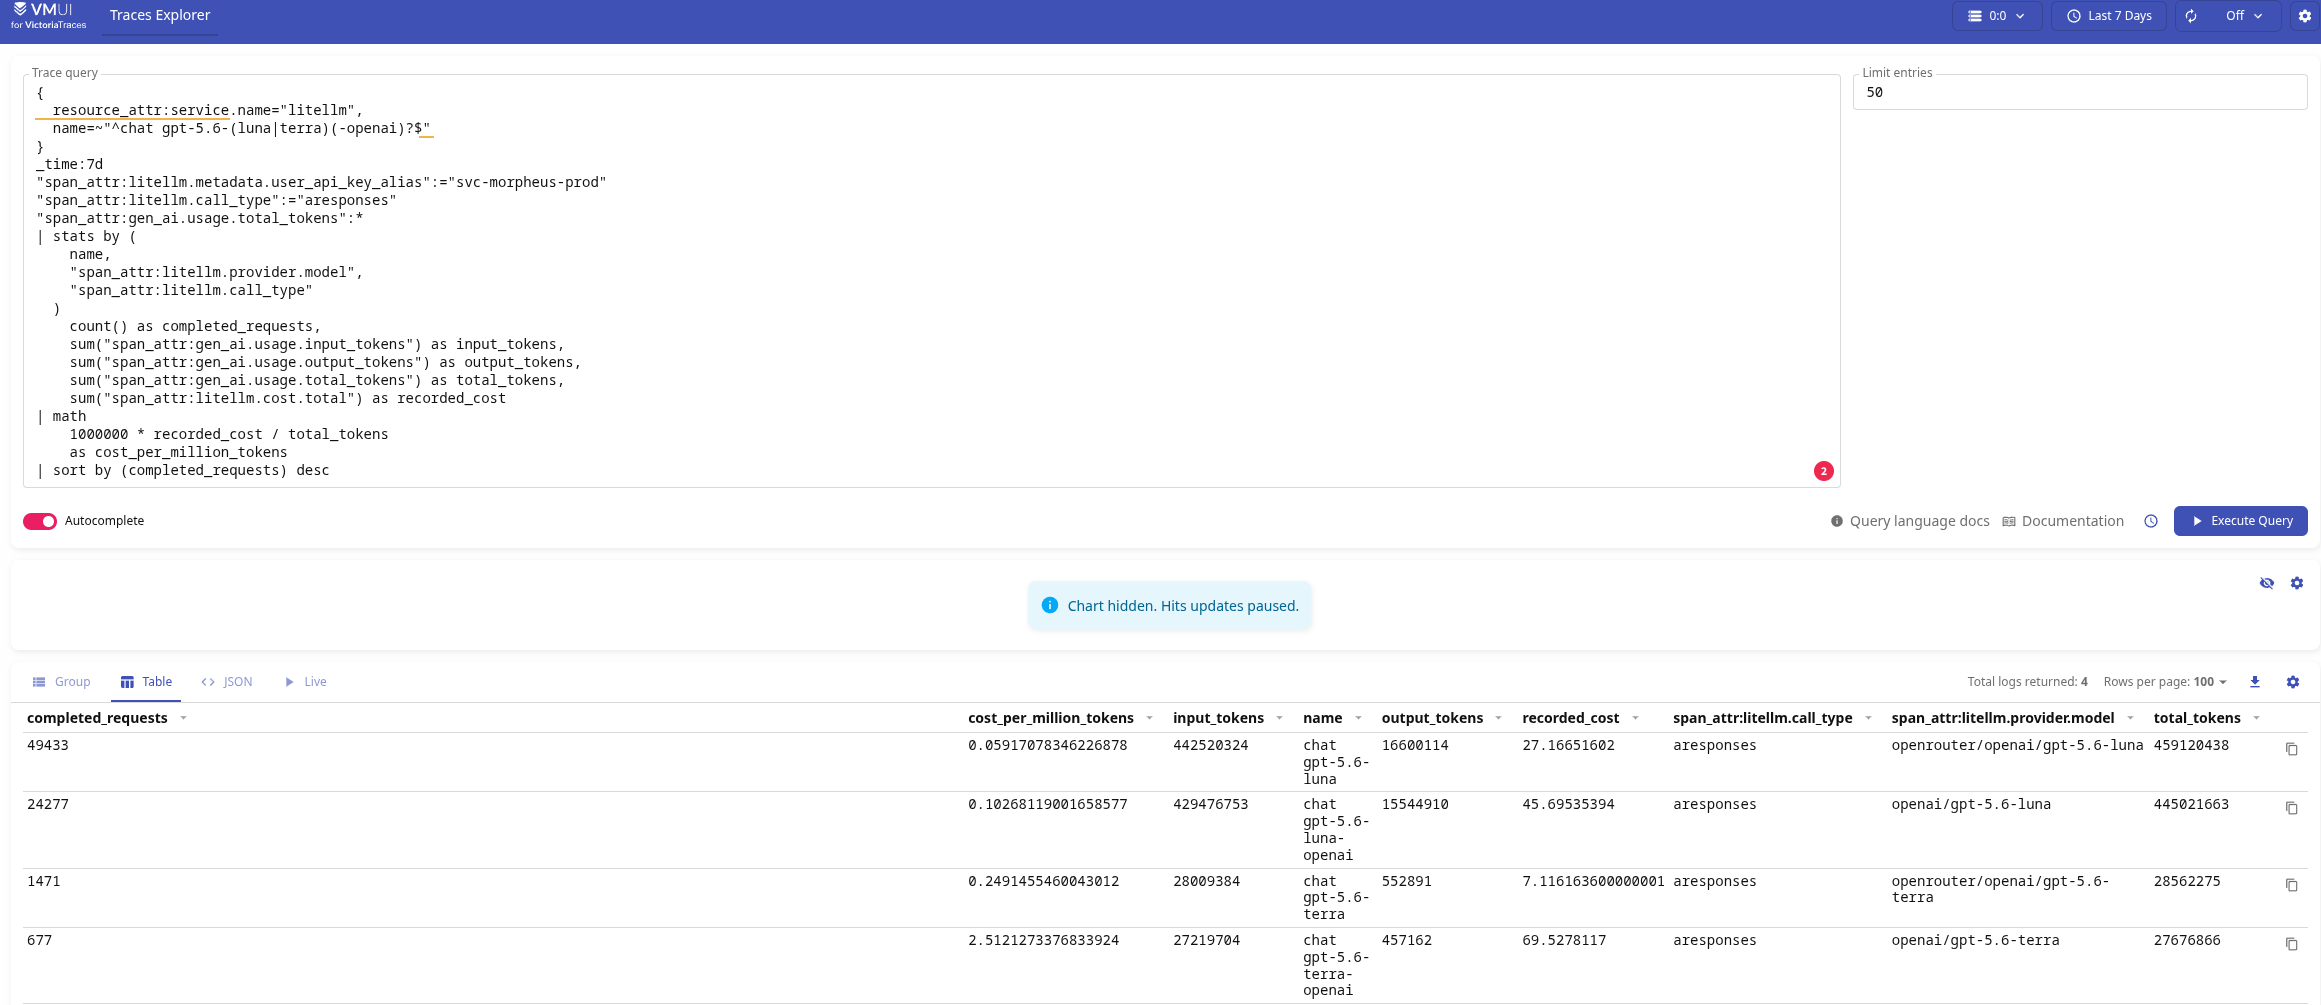
Де бачимо, що для gpt-5.6-luna та gpt-5.6-terra при приблизно однаковій кількості токенів – значення recorded_cost відрізняється в рази:
- gpt-5.6-luna:
total_tokens:- OpenRouter: 459M
- OpenAI: 445M
recorded_cost:- OpenRouter: $27
- OpenAI: $ 45
- gpt-5.6-terra:
total_tokens:- OpenRouter: 28M
- OpenAI: 27M
recorded_cost:- OpenRouter: $7
- OpenAI: $69
Або інакше, трохи простіше – і заодно перевірити, чи використовує Morpheus Chat Completion API взагалі – чи тільки Responses API:
{
  resource_attr:service.name="litellm",
  name=~"^chat .*"
}
_time:7d
"span_attr:litellm.metadata.user_api_key_alias":="svc-morpheus-prod"
"span_attr:litellm.call_type":in("aresponses", "acompletion")
"span_attr:gen_ai.usage.total_tokens":*
| stats by (
    "span_attr:llm.provider",
    "span_attr:litellm.call_type"
  )
    count() as requests,
    sum("span_attr:gen_ai.usage.input_tokens") as input_tokens,
    sum("span_attr:gen_ai.usage.output_tokens") as output_tokens,
    sum("span_attr:litellm.cost.total") as recorded_cost
| sort by (requests) desc
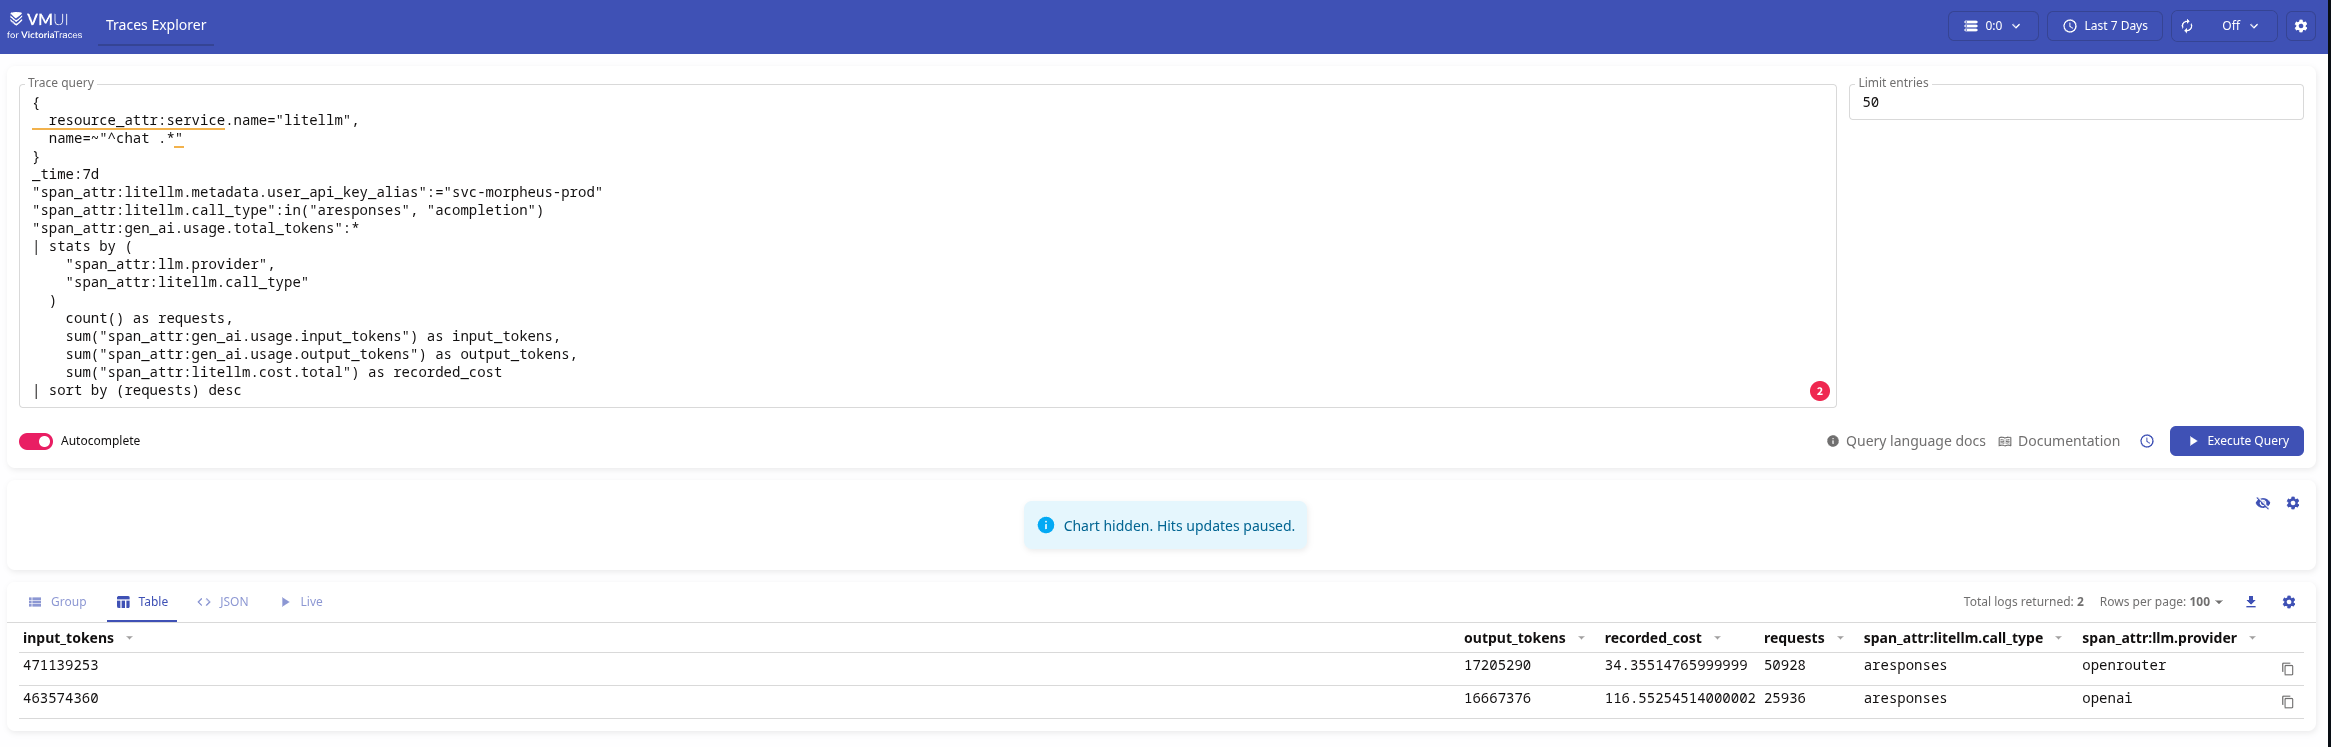
бачимо, що всі запити на Responses API, і при цьому:
- OpenRouter реквестів – 50928, вартість – 34.3
- OpenAI реквестів – 25936, вартість – 116.5
Final Summary: The Root Cause
Спайк витрат в litellm_spend_metric_total після 13-го числа не означав, що загальні витрати на LLM раптово виросли, і я зря напряг девелоперів – “Що ви там вже навайбокодили?”: сумарні витрати OpenAI та OpenRouter залишалися приблизно на попередньому рівні.
Причина спайку на графіках в Grafana була через кілька причин:
- OpenRouter вичерпав доступні кредити і почав повертати помилку 402
- ми успішно профукали цей алерт
- LiteLLM використав налаштовані fallbacks напряму на OpenAI
- всі запити від всіх клієнтів, включно з Morpheus, почали йти на OpenAI
- Для OpenAI LiteLLM коректно розраховував вартість
- для OpenRouter через
aresponsesLiteLLM враховував лише частину фактичної вартості - а для OpenAI все рахувалось правильно – і, відповідно, в Grafana ми побачили різкий спайк витрат
- для OpenRouter через
Отже, головне – не покладатись тільки на LiteLLM і моніторити кости напряму з провайдерів.
Ну і звертати увагу на алерти 🙂
Monitoring Improvements – Grafana та алерти
Частина у нас на проекті є, частину треба буде доробити.
Ну і просто як ще один summary – чого не вистачало в моніторингу.
LiteLLM Fallback Monitoring
Треба слідкувати за фолбеками – і в Grafana, і в алертах.
В Grafana dashboards у нас цього не було, але є алерт:
- alert: LiteLLM Too High Fallback Rate
  expr: |
    sum by (namespace, requested_model, fallback_model, api_key_alias, team_alias, exception_class, exception_status) (
      increase(litellm_deployment_successful_fallbacks_total[5m])
    ) > 300
  for: 5m
  labels:
    component: devops
    environment: ops
    severity: warning
    ilert_routingkey: devops-ops-warning
  annotations:
    summary: LiteLLM Too High Fallback Rate
    description: |-
      LiteLLM has rerouted more than 300 requests to fallback models per 5-minute window for more than `{{ "{{" }} $for }}`.
      This indicates sustained primary model or provider failures and may increase latency, change model behavior, or increase cost.
      *Namespace*: `{{ "{{" }} $labels.namespace }}`
      *Fallbacks during the last 5 minutes*: `{{ "{{" }} $value }}`
      *Requested model*: `{{ "{{" }} $labels.requested_model }}`
      *Fallback model*: `{{ "{{" }} $labels.fallback_model }}`
      *API key alias*: `{{ "{{" }} $labels.api_key_alias }}`
      *Team alias*: `{{ "{{" }} $labels.team_alias }}`
      *Exception class*: `{{ "{{" }} $labels.exception_class }}`
      *Exception status*: `{{ "{{" }} $labels.exception_status }}`
      <https://{{ $.Values.monitoring.root_url }}/d/adtt9jj/adrmshg/litellm-system-overview |:grafana: LiteLLM System overview>
Request rate: LiteLLM total vs OpenRouter vs OpenAI
Якщо OpenRouter є основним провайдером – може мати сенс слідкувати за тим, яка частина загального трафіку LiteLLM йде на нього – а яка на OpenAI.
Приклад запиту для відсотків:
100 *
sum(
  rate(
    litellm_requests_metric_total{
      api_key_alias="svc-morpheus-prod",
      api_provider="openai"
    }[15m]
  )
)
/
clamp_min(
  sum(
    rate(
      litellm_requests_metric_total{
        api_key_alias="svc-morpheus-prod"
      }[15m]
    )
  ),
  0.001
)
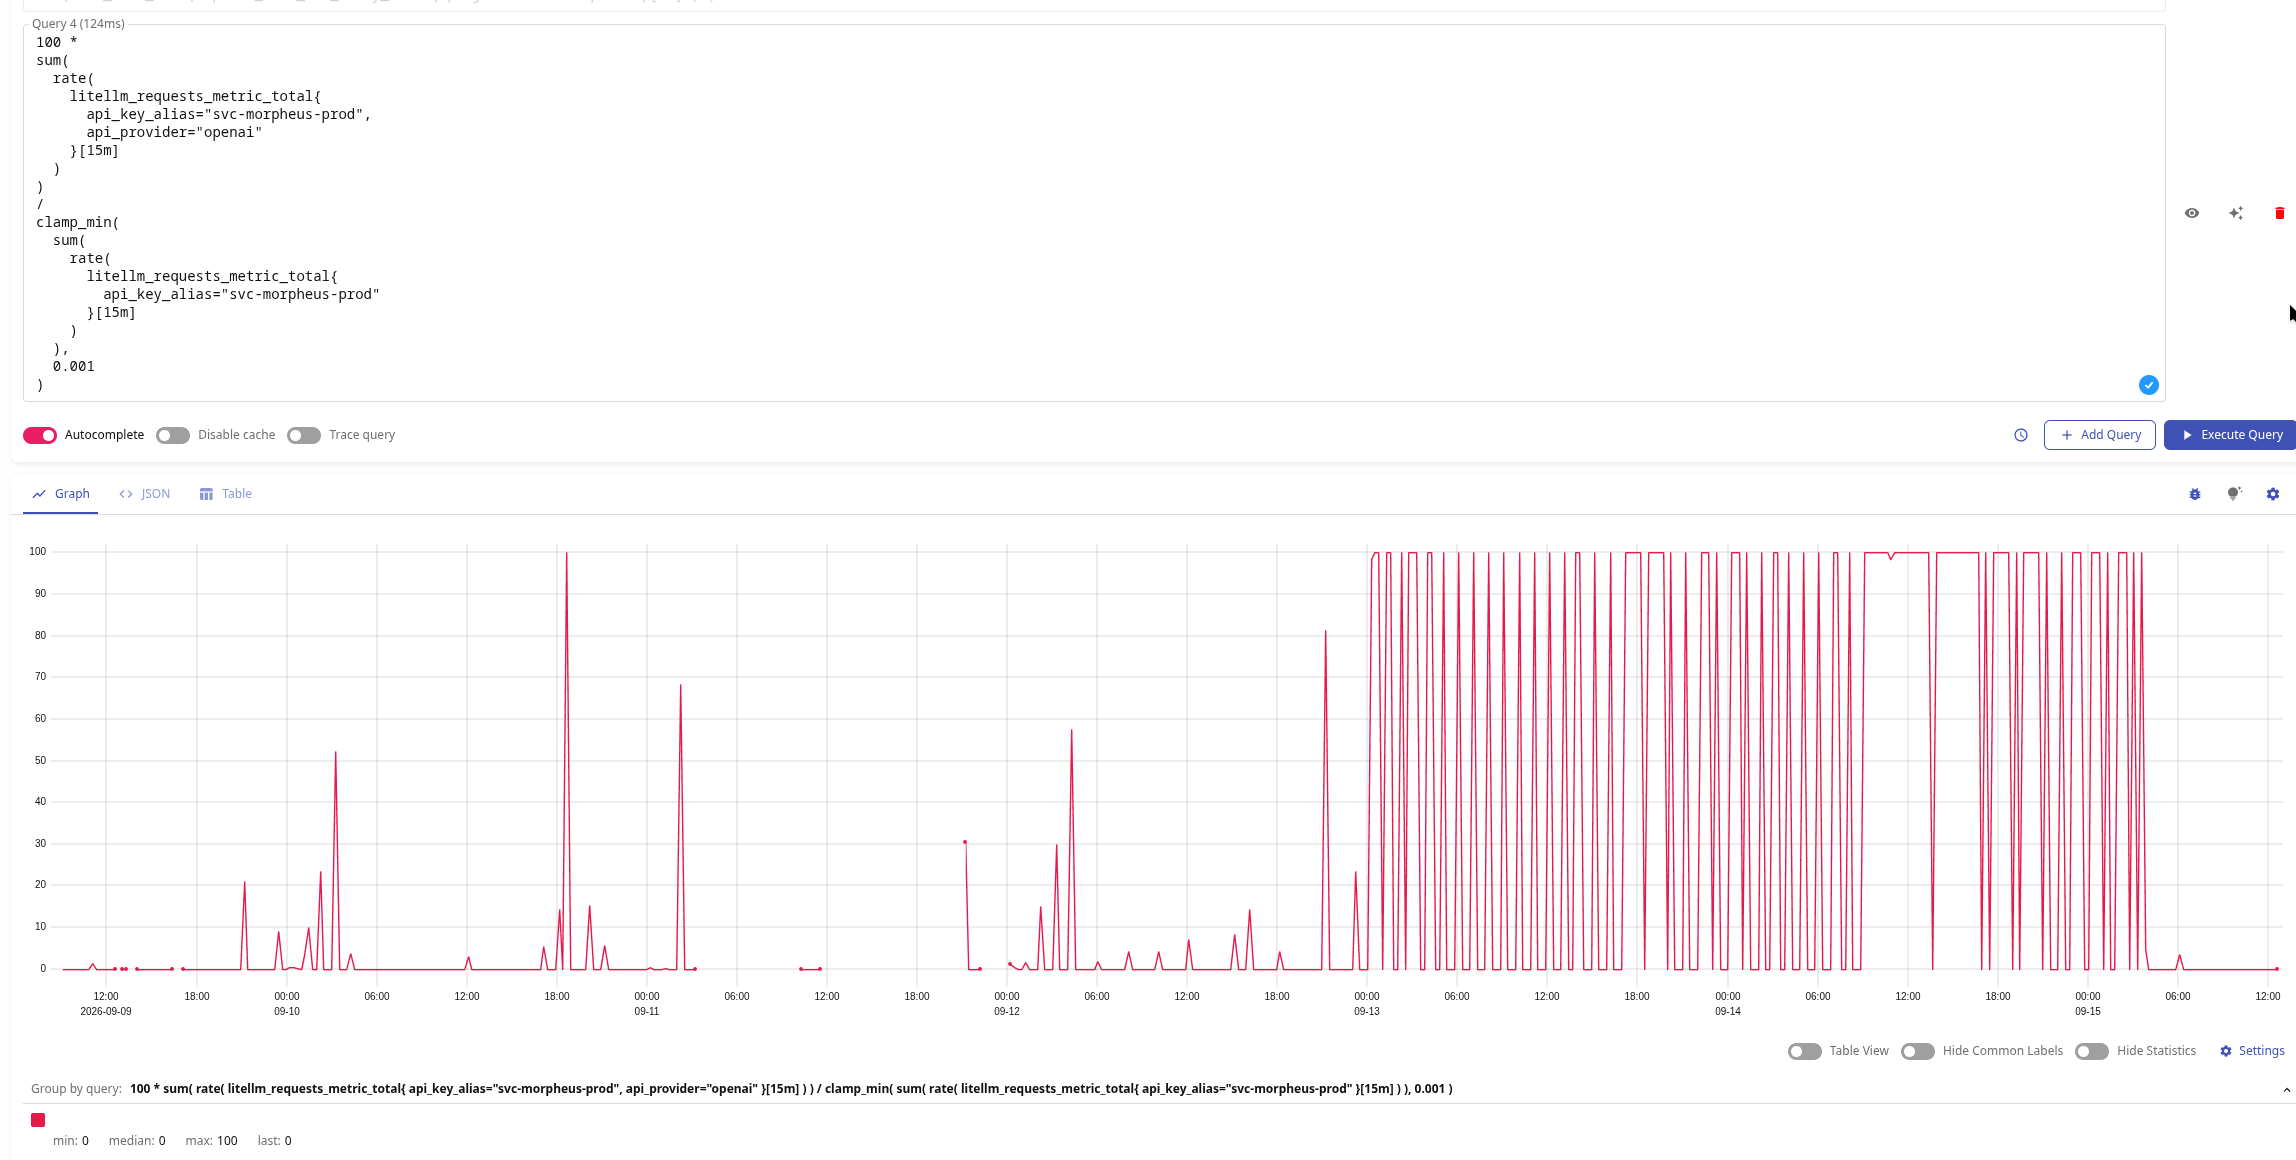
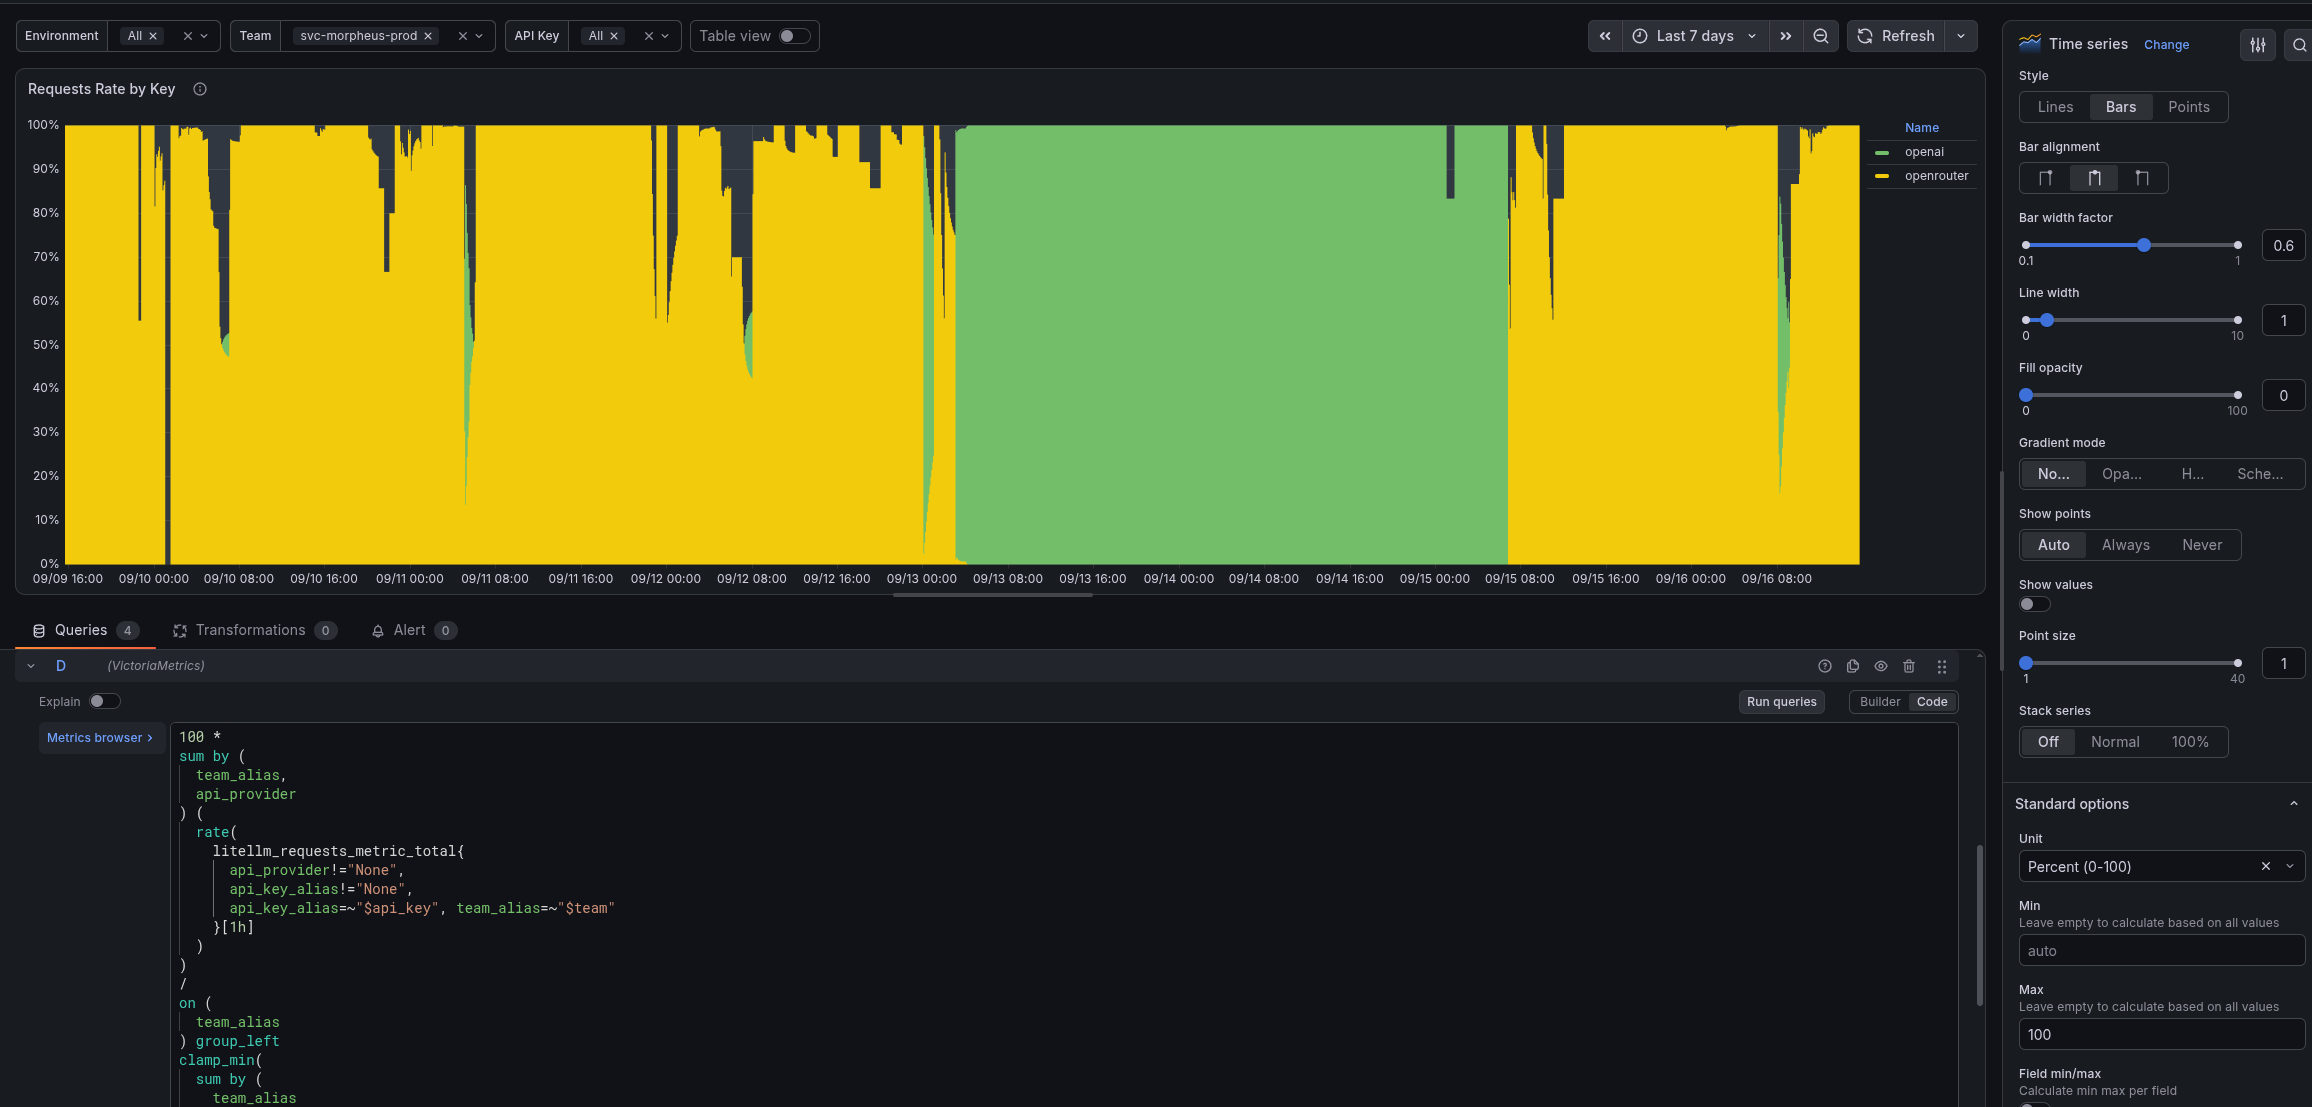
Для Grafana можна додати візуалізацію – але з фільтрами (із Grafana variables), бо інакше на графіку буде total mess:
100 *
sum by (
  team_alias,
  api_provider
) (
  rate(
    litellm_requests_metric_total{
      api_provider!="None",
      api_key_alias!="None",
      api_key_alias=~"$api_key", team_alias=~"$team"
    }[1h]
  )
)
/
on (
  team_alias
) group_left
clamp_min(
  sum by (
    team_alias
  ) (
    rate(
      litellm_requests_metric_total{
        api_provider!="None",
        api_key_alias!="None",
        api_key_alias=~"$api_key", team_alias=~"$team"
      }[1h]
    )
  ),
  0.001
)
Anomalous Spend Alerts
У нас на це алерт є, корисна штука: порівнює витрати за останню добу із середнім значенням за попередні 7 днів. Тригериться, якщо значення стає х2 від цього середнього:
# Alert when spend during the last rolling 24 hours exceeds 200% of the daily
# average from the preceding 7 days. The 1d offset excludes the current
# 24-hour window from the baseline; ignore API keys whose spend is $10 or less.
- alert: LiteLLM API Key Spend Spike
  expr: |
    (
      sum by (namespace, api_key_alias) (increase(litellm_spend_metric_total[1d]))
        > 2 * (sum by (namespace, api_key_alias) (increase(litellm_spend_metric_total[7d] offset 1d)) / 7)
    )
    and
    sum by (namespace, api_key_alias) (increase(litellm_spend_metric_total[1d])) > 10
  for: 1h
  labels:
    severity: warning
  annotations:
    summary: "LiteLLM API Key Spend Spike"
    description: |-
      *Namespace*: `{{ "{{" }} $labels.namespace }}`
      *API key alias*: `{{ "{{" }} $labels.api_key_alias }}`
      *Spend (last 24h)*: `${{ "{{" }} $value | printf "%.2f" }}`
      *Previous 7-day daily average*: `${{ "{{" }} with printf "sum(increase(litellm_spend_metric_total{namespace=%q,api_key_alias=%q}[7d] offset 1d))/7" $labels.namespace $labels.api_key_alias | query }}{{ "{{" }} . | first | value | printf "%.2f" }}{{ "{{" }} else }}n/a{{ "{{" }} end }}`
      *Alert threshold (200% of daily average)*: `${{ "{{" }} with printf "2*(sum(increase(litellm_spend_metric_total{namespace=%q,api_key_alias=%q}[7d] offset 1d))/7)" $labels.namespace $labels.api_key_alias | query }}{{ "{{" }} . | first | value | printf "%.2f" }}{{ "{{" }} else }}n/a{{ "{{" }} end }}`
      <https://{{ $.Values.monitoring.root_url }}/d/adtt9jj/adrmshg/litellm-system-overview|:grafana: LiteLLM System overview>
Important: Alert on OpenAI or OpenRouter Low Credits
Ми ці метрики збираємо самі, але, мабуть, є готові експортери – можна використати їх.
Ці алерти, звісно, мають бути з severity="critical".
Приклади на алертах OpenRouter.
Перший – алертимо, якщо на акаунті залишилось менше 20 доларів:
- alert: OpenRouter Credits Low
  expr: |
    openrouter_credits_remaining_usd > 0
    and
    openrouter_credits_remaining_usd < 20
    and
    openrouter_exporter_scrape_success == 1
  for: 10m
  labels:
    severity: critical
    component: devops
    environment: ops
    ilert_routingkey: devops-ops-critical
  annotations:
    summary: "OpenRouter credits are running low"
    description: |-
      OpenRouter has less than ${{ .Values.openrouter_exporter.low_credits_threshold_usd }} in credits remaining for more than `{{ "{{" }} $for }}`.
      *Credits remaining*: `${{ "{{" }} printf "%.2f" $value }}`
І другий – коли грошей вже нема взагалі:
- alert: OpenRouter Credits Exhausted
  expr: |
    openrouter_credits_remaining_usd <= 0
    and
    openrouter_exporter_scrape_success == 1
  for: 5m
  labels:
    severity: critical
    component: devops
    environment: ops
    ilert_routingkey: devops-ops-critical
  annotations:
    summary: "OpenRouter credits are exhausted"
    description: |-
      OpenRouter credits have been exhausted for more than `{{ "{{" }} $for }}`.
      *Credits remaining*: `${{ "{{" }} printf "%.2f" $value }}`
Provider Spend vs LiteLLM in Grafana
Корисно відображати витрати реальні, які отримуємо експортерами з API провайдерів – і витрати, які рахує LiteLLM.
Мабуть, робити два графіки – LiteLLM vs OpenAI з двома запитами, другий – LiteLLM vs OpenRouter.
OpenAI: Actual vs LiteLLM
Для “LiteLLM vs OpenAI” перший query – що ми бачимо від OpenAI API з нашим експортером:
max(
  max_over_time(
    openai_cost_usd_today_total{
      project="litellm-prod"
    }[1d]
  )
)
Другий – що нам “малює” LiteLLM:
sum(
  increase(
    litellm_spend_metric_total{
      namespace="ops-litellm-ns",
      api_provider="openai"
    }[1d]
  )
)
Картина приблизно однакова, графік за місяць з Interval та Step в 1d:
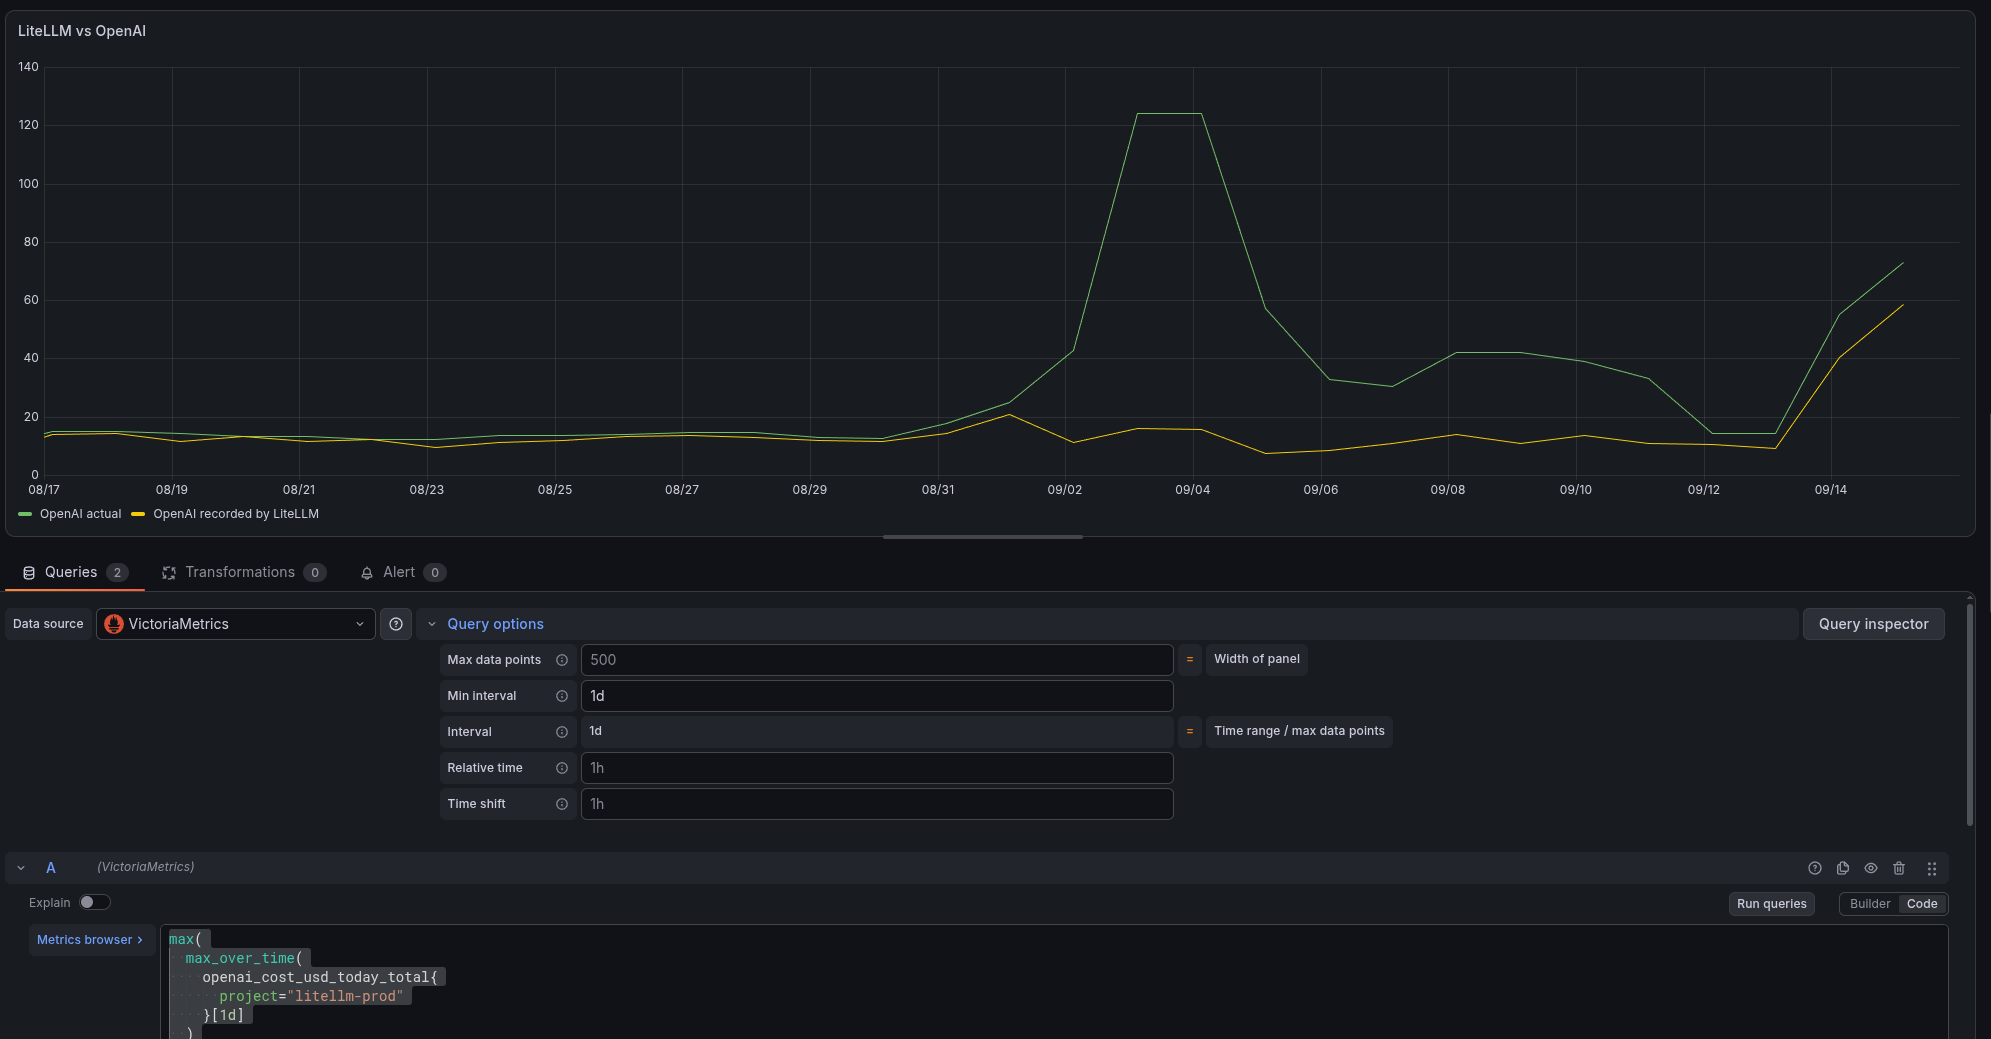
Тут 2-4 вересня і кілька днів далі є спайк, який не співпадає з даними від LiteLLM – але це expected, бо в цей час я тестував наш LLM Evaluations, який на окремому OpenAI API Key – але в тому самому проекті (див. LiteLLM: Custom Callback та LLM Evaluations з Judge LLM).
OpenRouter: Actual vs LiteLLM
Запит для витрат OpenRouter:
max(
  increase(
    openrouter_credits_used_usd[1d]
  )
)
І дані, які рахує LiteLLM:
sum(
  increase(
    litellm_spend_metric_total{
      namespace="ops-litellm-ns",
      api_provider="openrouter"
    }[1d]
  )
)
Результат:
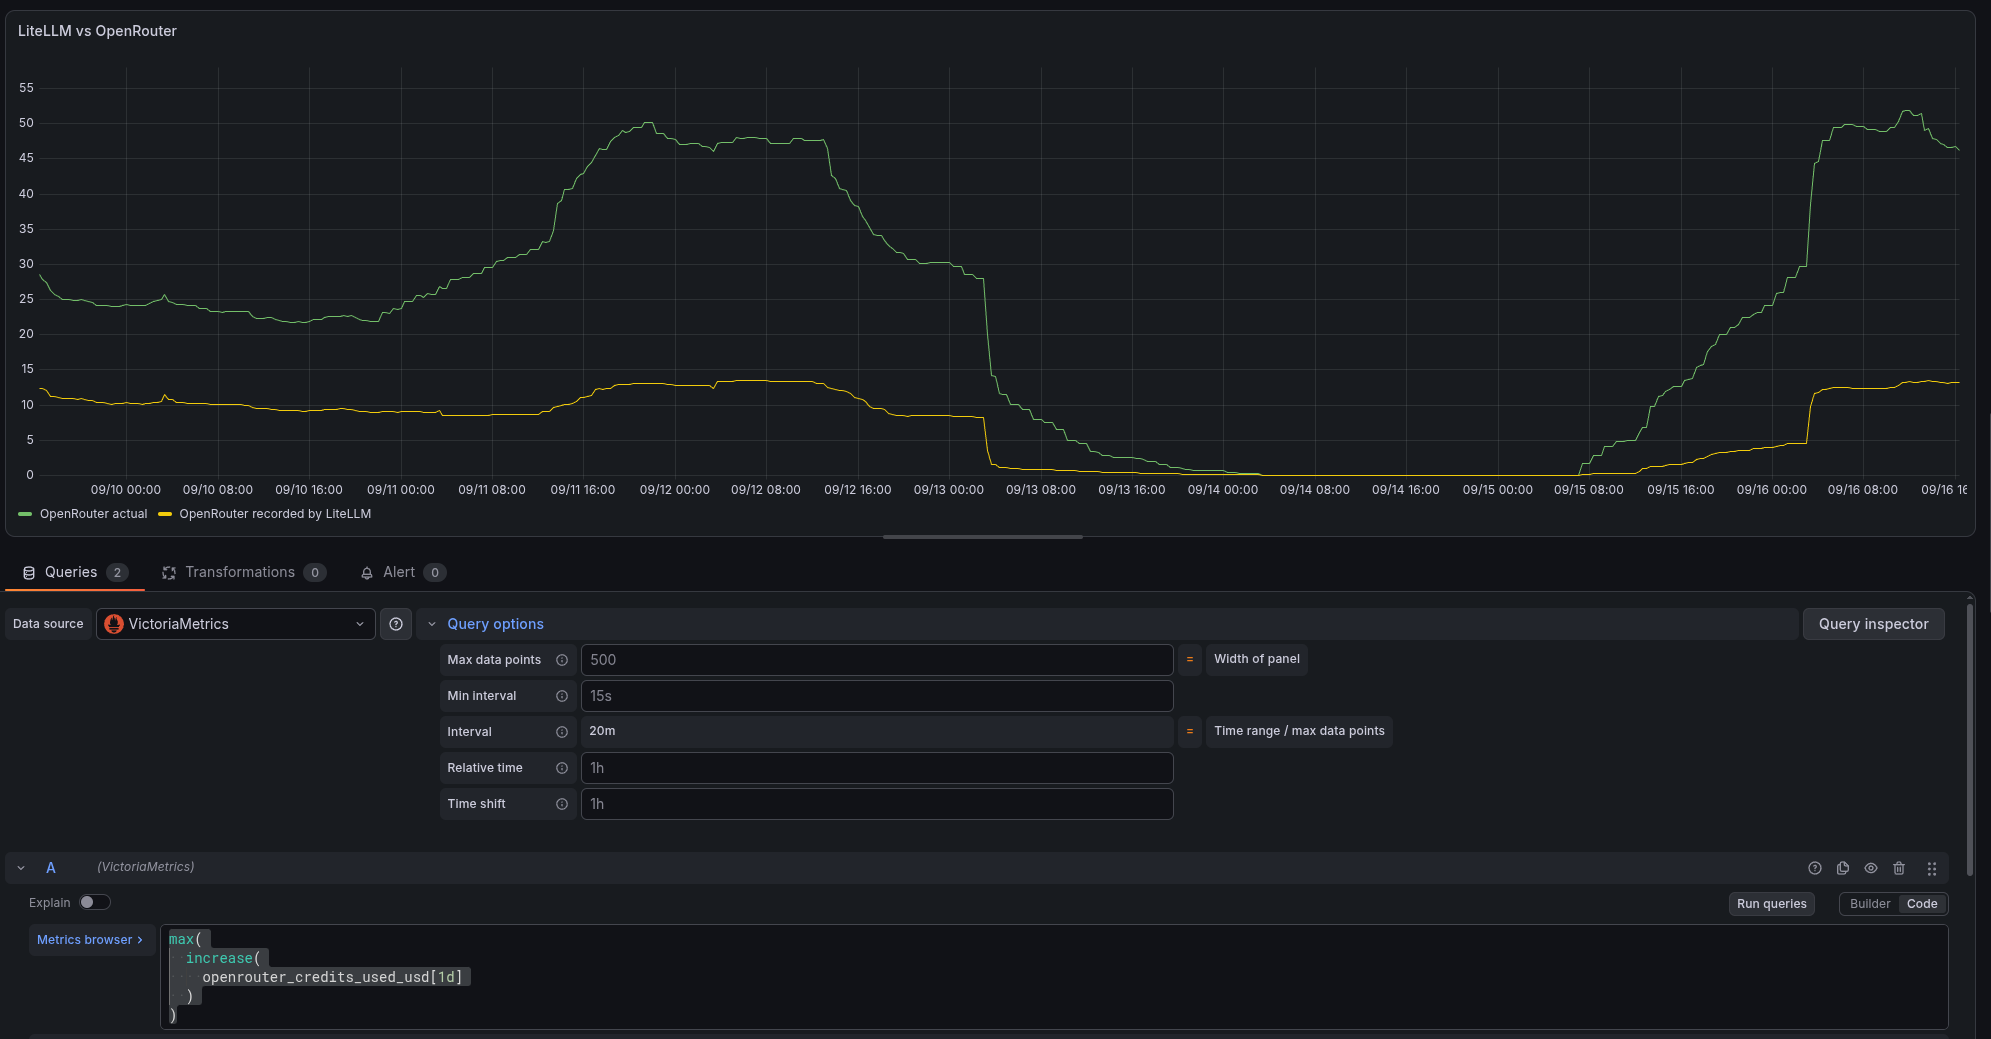
Тут вже очікувано бачимо розбіжність через той самий баг з OpenRouter usage.cost для Responses API .
Наче все…
Ну і наостанок повторю – не довіряти одному джерелу, в даному випадку LiteLLM.
Мати додатковий контроль напряму з провайдерів – must have.
