 Спіймали стандартну помилку з OOM Killer в Kubernetes, думав швиденько гляну – але якось “раптом” вийшов непоганий такий матеріал.
Що особливо непогано – що дуже давно не копався сам в таких штуках, як Linux OOM Killer та cgroups, типи пам’яті та Kubernetes limits – а тому було прям приємно знов поринути в цей чудовий світ і трохи згадати, що я не тільки “оператор Codex” – а ще і трошки сам інженер.
Сам пост вийшов без якось фінального “ось, де була проблема” – але по ходу діла довелось трохи покопатись в метриках і механізмах ядра Linux, тому детектив вийшов цікавий.
А почитати його варто просто через те, що буде багато про Linux cgroups, memory та метрики cAdvisor.
До речі, див. також Kubernetes: Pod resources.requests, resources.limits та Linux cgroups.
Зміст
The Issue
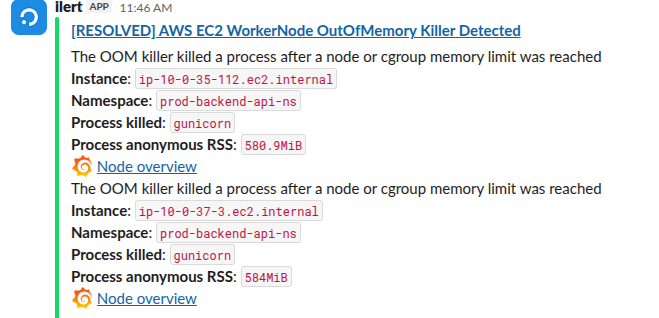
Дійсно прям стандартна проблему яку всі ми ловили не один раз – контейнер вбивається з OOM Killer:
І після цього – 502 помилки на Load Balancer, що, вцілому, було очікувано (btw, див. Kubernetes: помилки 503 з AWS ALB – можливі причини та рішення):
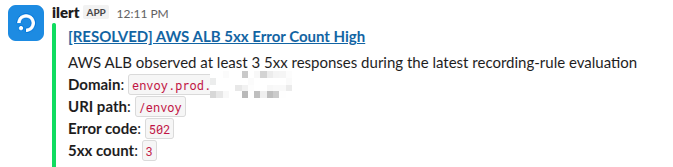
Так як сам ендпоінт “envoy.prod.example.co” – новий сервіс, то вирішив глянути що ж там було, бо в більшості наших сервісів ми значення Kubernetes resources.requests та resources.limits вже “підтюнили”, там проблем нема – а в новому сервісі варто було швиденько глянути.
“Швиденько” не вийшло – бо якось занурився в цю тему і трохи позгадував те, як працюють механізми лімітів та Linux OOM Killer.
Investigating: Grafana та логи OOM Killer
Перше, на що звернув увагу – що наша Grafana для цього Pod не показувала якихось великих спайків:
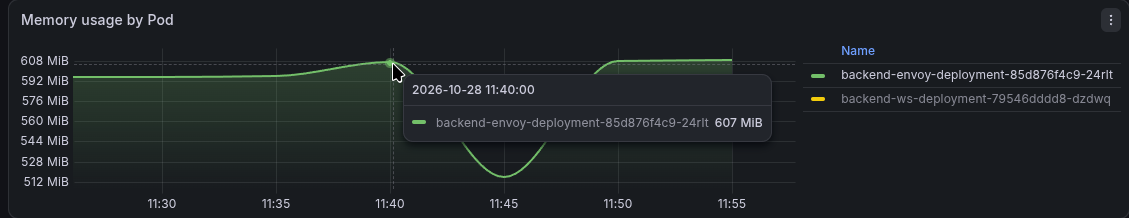
Був трохи ріст до ~607 мегабайт – але ж limits ми задавали з запасом, до 1 GB:
deployment_envoy:
  # sized to the API tier: 2 Pods x 2 gunicorn workers, every endpoint is sync/GIL-bound
  replicas: 2
  resources:
    requests:
      memory: 640Mi
      cpu: 100m
    limits:
      memory: 1Gi
Перевіряємо логи в цей час:
"Killed process" "gunicorn" hostname:="ip-10-0-35-112.ec2.internal"
І дійсно – бачимо 4 вбитих процеси gunicorn:
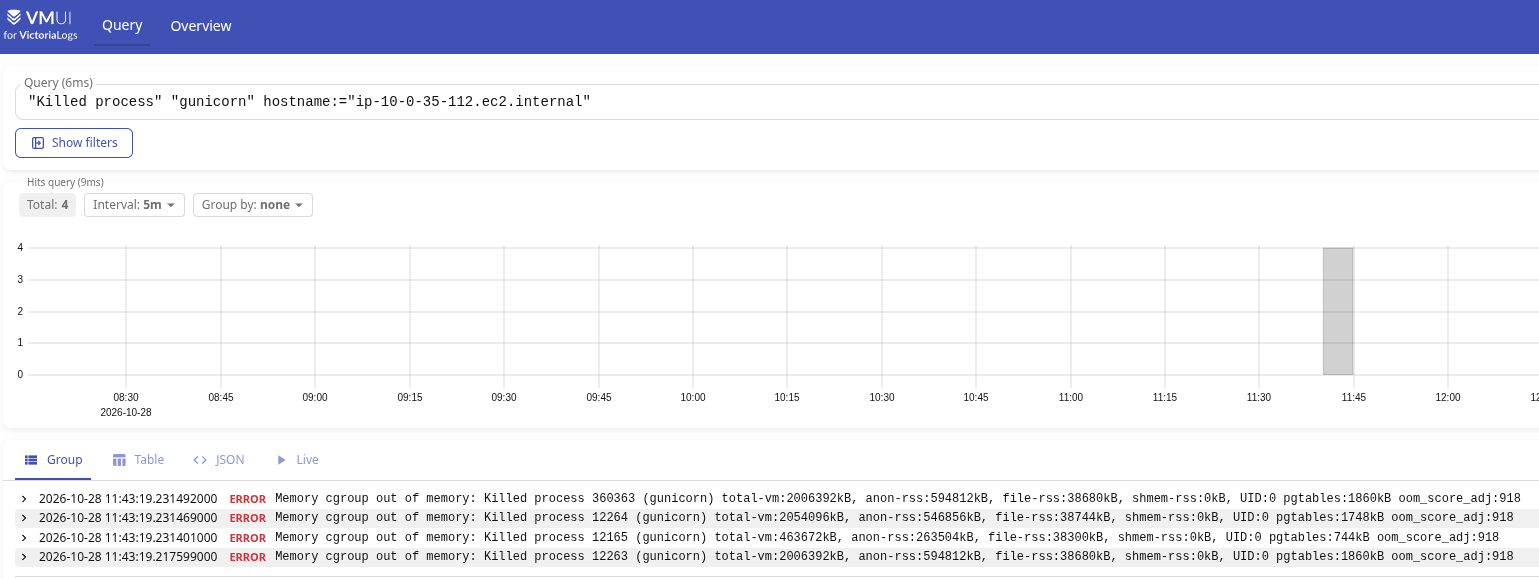
- Killed process 360363 – rss:594812kB (580.9 MiB)
- Killed process 12264 – rss:546856kB (534.0 MiB
- Killed process 12165 – rss:263504kB (257.3 MiB)
- Killed process 12263 – rss:594812kB (580.9 MiB)
Чому вбило відразу кілька процесів – бо в кожному поді є один gunicorn master + 2 gunicorn workers (тут приклад з поки що живого поду):
root@backend-envoy-deployment-fc8c468d-frn4l:/app# ps aux | grep gun
root           1  0.0  3.8 463672 302348 ?       Ss   Oct28   0:17 /app/.venv/bin/python /app/.venv/bin/gunicorn envoy.run_api:app -c gunicorn.conf.py --bind 0.0.0.0:8000 -w 2 -k uvicorn.workers.UvicornWorker --log-level debug --keep-alive 75
root           8  0.5  5.1 1889828 406744 ?      Sl   Oct28   6:07 /app/.venv/bin/python /app/.venv/bin/gunicorn envoy.run_api:app -c gunicorn.conf.py --bind 0.0.0.0:8000 -w 2 -k uvicorn.workers.UvicornWorker --log-level debug --keep-alive 75
root           9  0.4  5.0 1955844 399948 ?      Sl   Oct28   5:20 /app/.venv/bin/python /app/.venv/bin/gunicorn envoy.run_api:app -c gunicorn.conf.py --bind 0.0.0.0:8000 -w 2 -k uvicorn.workers.UvicornWorker --log-level debug --keep-alive 75
root         543  0.0  0.0   3760  1972 pts/0    S+   10:50   0:00 grep gun
А от про четвертий процес буде окремо.
Повертаючись до самої проблеми: маємо три вбитих процеси, у кожного було від 257 до 581 MB RSS.
Всі процеси були вбиті разом – бо всі належали одному контейнеру, але ми словам не віримо – а перевіримо, і заодно подивимось як взагалі все відбувалось.
OOM Killer та containerd: як все відбувалось
Розширюємо запит:
hostname:="ip-10-0-35-112.ec2.internal" job:="systemd-journal" ("memory: usage" OR "Memory cgroup stats" OR "oom-kill" OR "Tasks in" OR "Killed process" OR "TaskOOM" OR "ContainerDied" OR "exit_status:137")
Тепер бачимо повну картину того, що було:
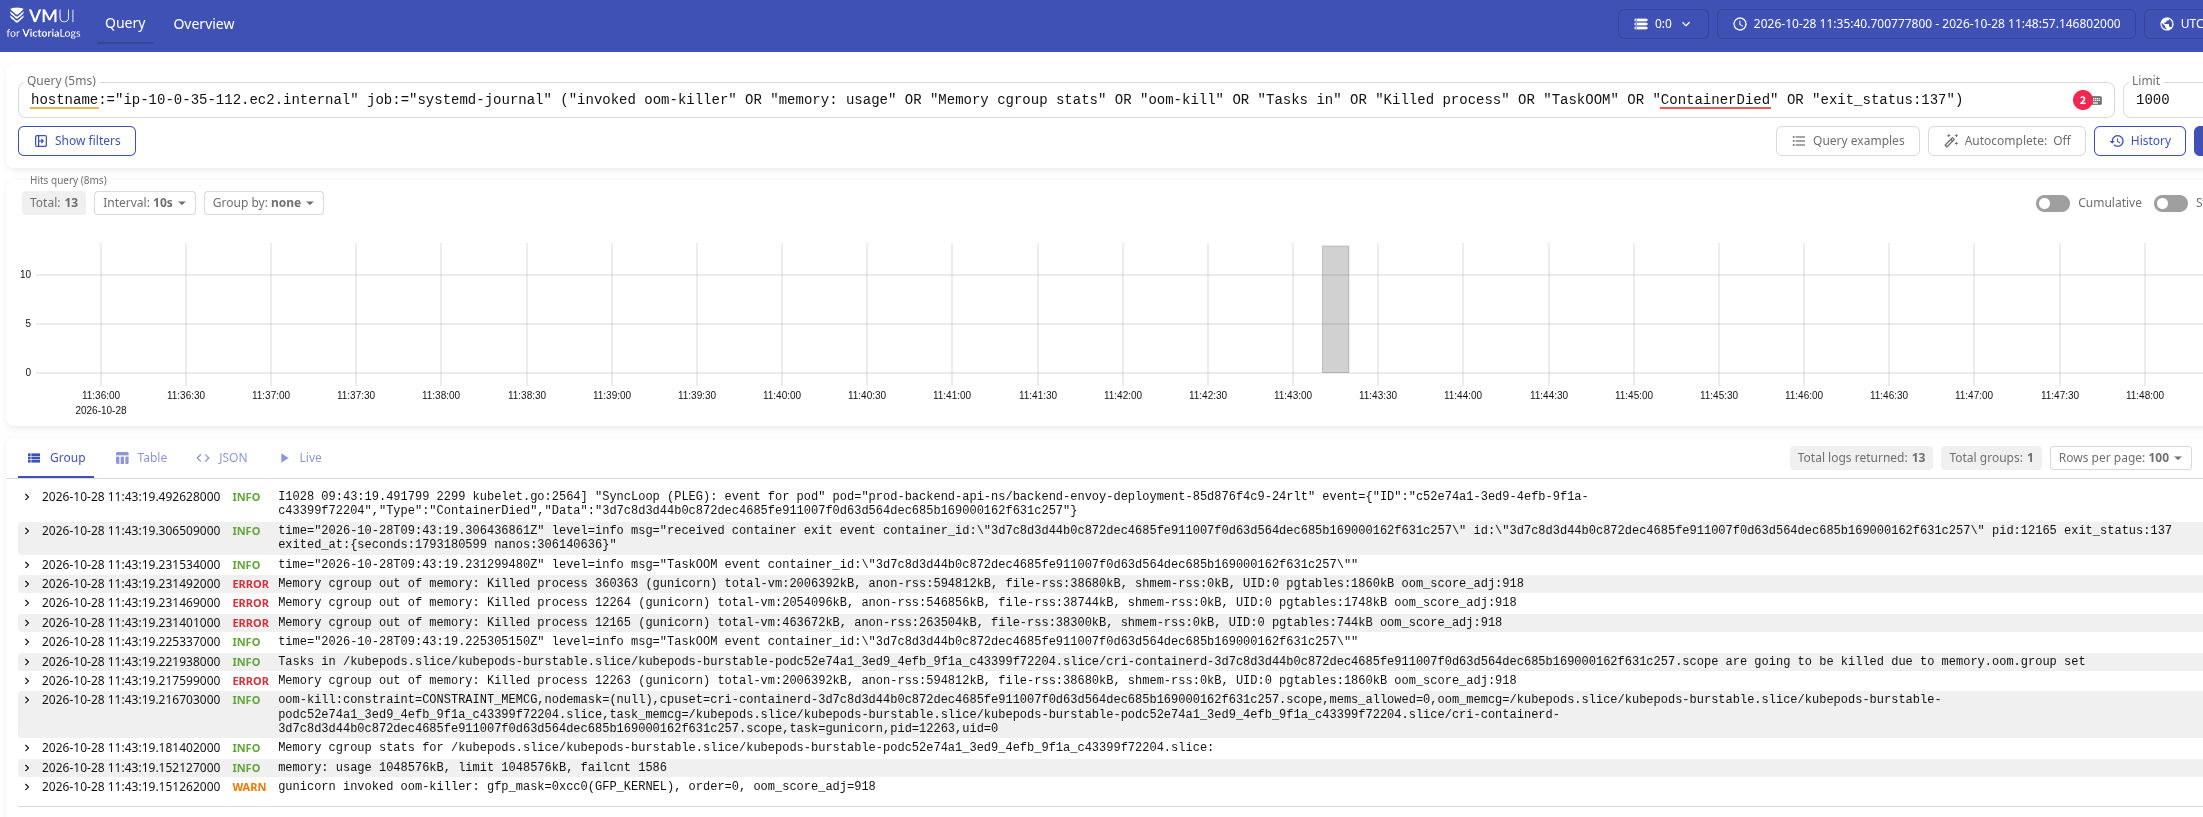
Читаємо знизу, з першого по часу повідомлення:
- 11:43:19.151262: процес
gunicornвикликав спрацюванняoom-killer- причина –
memory: usage 1048576kBприlimit 1048576kB
- причина –
- 11:43:19.216703: визначається кого вбивати:
- була визначена cgroup, яка “порушила ліміт пам’яті” (
oom_memcg– Out Of Memory Control Group) – Pod з ID 52e74a1…204:oom_memcg=/kubepods.slice/***/kubepods-burstable-pod52e74a1...204.slice
- була визначена дочірня cgroup з контейнерами в цьому Pod – тут контейнер був один, з ID 3d7c8d…257
task_memcg=/kubepods.slice/***/kubepods-burstable-pod52e74a1...204.slice/cri-containerd-3d7c8d...257.scope
- і, власне, сам процес в цій групі, який споживав більше всього пам’яті –
task=gunicorn,pid=12263
- була визначена cgroup, яка “порушила ліміт пам’яті” (
- 11:43:19.217599: вбивається перший процес, той самий, який споживав більше всього пам’яті:
Memory cgroup out of memory: Killed process 12263 (gunicorn)
- 11:43:19.221938000: але OOM Killer працює на всі tasks (процеси) в групі із
task_memcg, тому до всіх PIDs ізtask_memcgбуло передано “Kill’em All!” черезmemory.oom.group:Tasks in /kubepods.slice/***/kubepods-burstable-pod52e74a1...204.slice/cri-containerd-3d7c8d...257.scope are going to be killed due to memory.oom.group set
- вбиваються решта PIDs, які в цей момент були в цій групі – 12264 та 12165
- 11:43:19.306509: так як всі процеси в контейнері завершились – включно з init PID 12165, то containerd відрапортував, що робота контейнеру завершена, але з помилкою 137:
msg="received container exit event container_id:\"3d7c8d...257\" ... pid:12165 exit_status:137 ...
Тобто картина доволі чітка:
- була cgroup
kubepods-burstable-pod52e74a1***204.sliceз limit 1 GB - в цьому Pod був контейнер із
cri-containerd-3d7c8d***257.scopeз трьома процесами – 12165 (gunicorn master), та двома workers – 12263 і 12264 - всі процеси були вбиті
Але на скріншоті об 11:43:19.231492000 є ще один загадковий Killed process 360363 (gunicorn).
Загадка перша: “містичний” PID 360363
Якщо процеси 12263, 12264 та 12165 вкладаються в загальну картину – один gunicorn master та два workers і всі троє були вбиті – то процес з PID 360363 трохи випадає з цієї логіки, хоча він теж мав comm == gunicorn.
А єдине, що збереглось в логах по PID 360363 – це запис:
11:43:19.151428000 warn CPU: 0 UID: 0 PID: 360363 Comm: gunicorn Tainted: G OE 6.12.111-136.204.amzn2023.x86_64 #1
Моє перше припущення – що 12165 gunicorn отримав SIGHUP (reload) і запустив нового воркера з PID 360363 – бо Gunicron при HUP спочатку запускає новий процес – Gunicorn signal handling.
Потім PID 360363 після запуску з’їв 594812kB – і це триггернуло подію OOM на весь слайс.
Але parent 12165 був вбитий об 11:43:19.231401, а 360363 – об 11:43:19.231492 – після нього.
Крім того, якщо в логах знайти “Tasks state (memory values in pages)” – то далі виводиться список процесів в cgroup, бо це “Memory cgroup stats for /kubepods.slice/kubepods-burstable.slice/kubepods-burstable-podc52e74a…204.slice” (це було нижче в логу):

І PID 360363 серед них нема.
Але бачимо інше цікаве – дивимось на інформацію в “логах вбивства” по вбитим процесам.
У 360363 маємо total-vm:2006392kB, anon-rss:594812kB, file-rss:38680kB:
Killed process 360363 (gunicorn) total-vm:2006392kB, anon-rss:594812kB, file-rss:38680kB, ... pgtables:1860kB
І точно така ж картина була у 12263:
Killed process 12263 (gunicorn) total-vm:2006392kB, anon-rss:594812kB, file-rss:38680kB, ... pgtables:1860kB
Тому друге припущення – можливо, 360363 – це просто thread в процесі 12263 – бо по пам’яті обох PID дуже схоже на використання єдиного mm_struct, який використовується parent PID та всіма його threads – а тому їхні total-vm, anon-rss, file-rss і pgtables будуть однаковими.
Just a note: Kubernetes, containerd та пошук PID а TID
Це просто як нотатка, та і взагалі для кращого розуміння того, як система працює “під капотом”.
Отже, якби контейнер ще був живий – то могли б перевірити всі його PID та TID.
Для цього по імені Kubernetes Pod знаходимо його ID:
$ kk -n prod-backend-api-ns get pod backend-envoy-deployment-fc8c468d-frn4l -o jsonpath='{.metadata.uid}'
2ced21f3-265b-440c-ba59-ba0ff7b8991a
Та ID контейнера в ньому:
$ kk -n prod-backend-api-ns get pod backend-envoy-deployment-fc8c468d-frn4l -o jsonpath='{.status.containerStatuses[?(@.name=="backend-envoy-container")].containerID}'
containerd://908251abc04b5e7d23cb7e3d8f8e112df43ddcb23e0ac1c569398ca7e4afc950
Далі підключаємось на його WorkerNode і перевіряємо файл cgroup.procs:
[root@ip-10-0-47-179 ~]# cat /sys/fs/cgroup/kubepods.slice/kubepods-burstable.slice/kubepods-burstable-pod2ced21f3_265b_440c_ba59_ba0ff7b8991a.slice/cri-containerd-908251abc04b5e7d23cb7e3d8f8e112df43ddcb23e0ac1c569398ca7e4afc950.scope/cgroup.procs
3970
4228
4229
614309
А всі threads – в файлі cgroup.threads:
[root@ip-10-0-47-179 ~]# cat /sys/fs/cgroup/kubepods.slice/kubepods-burstable.slice/kubepods-burstable-pod2ced21f3_265b_440c_ba59_ba0ff7b8991a.slice/cri-containerd-908251abc04b5e7d23cb7e3d8f8e112df43ddcb23e0ac1c569398ca7e4afc950.scope/cgroup.threads
3970
4228
...
683930
Загадка друга: Grafana, container_memory_working_set_bytes та memory.max
Ще одне відкрите питання – чому в Grafana відображалось використання пам’яті на рівні ~600 MB – а OOM Killer спрацював на over 1 GB? Бо в логах ми бачили запис “memory: usage 1048576kB, limit 1048576kB“.
Значення memory: usage 1048576kB береться із memory.current, а limit 1048576kB – значення з memory.max.
А що входить в memory.current?
Див. Control Group v2:
- memory.current: The total amount of memory currently being used by the cgroup and its descendants
- memory.stat: breaks down the cgroup’s memory footprint into different types of memory
- memory.max: Memory usage hard limit. This is the main mechanism to limit memory usage of a cgroup. If a cgroup’s memory usage reaches this limit and can’t be reduced, the OOM killer is invoked in the cgrou
Якщо глянути опис memory.stat – то бачимо:
anon: heap, Python objects, stackfile: page cache файлівshmem: tmpfs, shared memorykernel: slab, kernel stacks, pagetables, per-CPU structures, vmallocsock: network buffers
Отже, якийсь процес в cgroup запросив у ядра більше пам’яті => ядро спробувало додати пам’яті і збільшити значення у memory.current => це перевищило значення memory.max => був викликаний OOM Killer.
А чому цього нема в Grafana?
cAdvisor та container_memory_working_set_bytes: а що, власне, показує?
В Grafana у нас використовується метрика container_memory_working_set_bytes від cAdvisor:
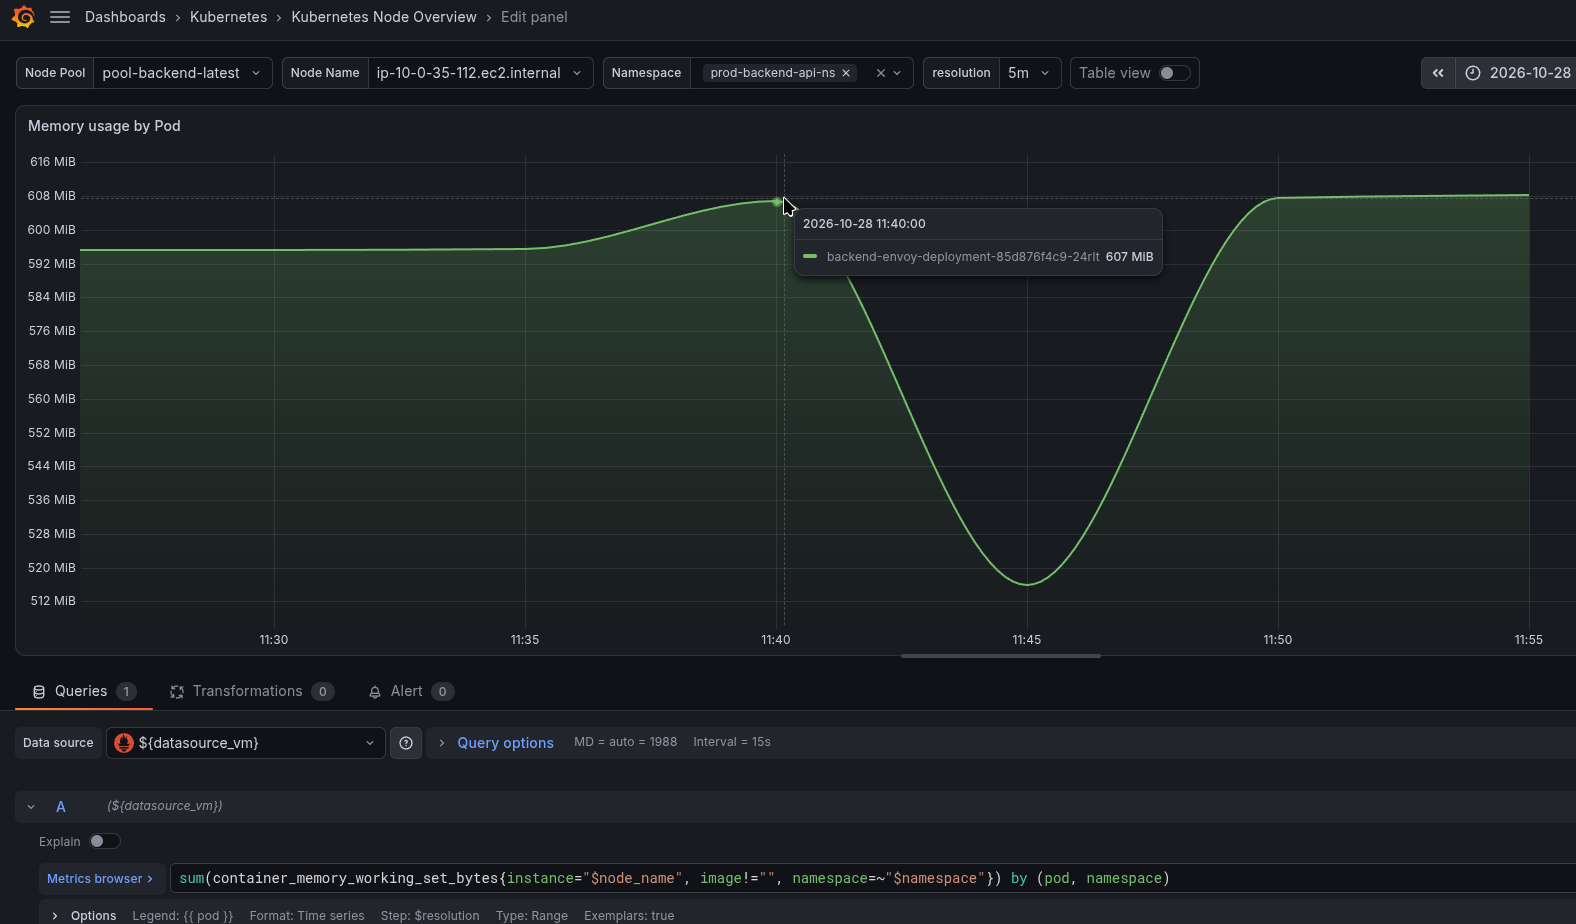
І логічно, що в container_memory_working_set_bytes ми повинні були бачити приблизно 1 GB – бо OOM Killer був викликаний, коли memory.current намагався стати більшим за memory.max.
container_memory_working_set_bytes, memory.current та код cAdvisor
Насправді, container_memory_working_set_bytes може бути трохи меншим за memory.current, бо container_memory_working_set_bytes – це (memory.current – inactive_file):
workingSet = (Memory.Usage - MemoryStats.Stats[inactiveFileKeyName])
Або весь код з файлу handler.go:
  workingSet := ret.Memory.Usage
  if v, ok := s.MemoryStats.Stats[inactiveFileKeyName]; ok {
    ret.Memory.TotalInactiveFile = v
    if workingSet < v {
      workingSet = 0
    } else {
      workingSet -= v
    }
  }
  ret.Memory.WorkingSet = workingSet
}
А ret.Memory.Usage – це значення MemoryStats.Usage.Usage – див. memory.go:
ret.Memory.Usage = s.MemoryStats.Usage.Usage
А MemoryStats.Usage.Usage бере значення із memory.current – див getMemoryDataV2():
usage := moduleName + ".current"
Тобто значення в container_memory_working_set_bytes мало б бути меншим за memory.current, який використовується при OOM Killer – але тільки за рахунок розміру inactive_file.
І теоретично – Grafana з метрикою container_memory_working_set_bytes могла показувати менше, ніш було враховано при OOM Kill як раз через розмір inactive_file.
Але перевіряємо значення метрики container_memory_total_inactive_file_bytes:
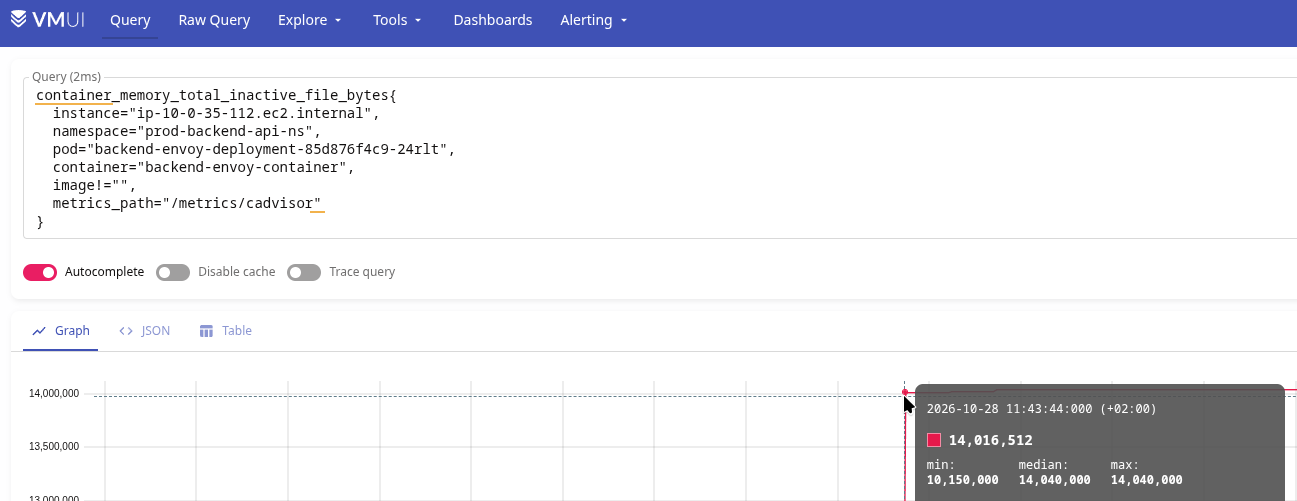
~ 14 мегабайт.
Не сходиться.
Крім того, маємо метрику container_memory_usage_bytes, яка включає в себе container_memory_working_set_bytes + container_memory_total_inactive_file_bytes – і вона репортить лише ~645 MB:
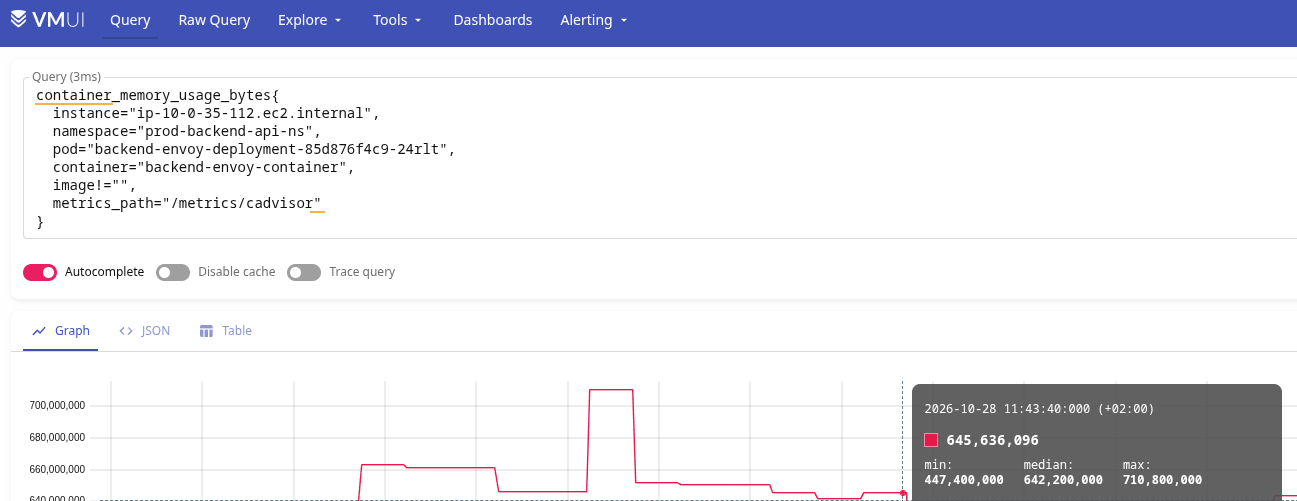
“То де мегабайти, Білл?”
Єдине припущення, яке в мене тут є – що спайк використання пам’яті стався настільки раптово, що cAdvisor просто не встиг це записати в метрики.
Але ядро Linux цей спайк (а саме запит на додаткову пам’ять) звісно побачило – і викликало OOM Kill на всю групу процесів в контейнері.
One more note: Linux RSS Total vs memory.current
І на останок – чому сума RSS процесів більша за memory.current?
Тобто, якщо порахувати всі anon-rss + file-rss з логу (навіть без “містичного” PID 360363) – то сума вийде взагалі біля 1.4 GB – що набагато більше, ніж memory.current або memory.max (які буди приблизно рівні, коли був викликаний OOM Killer).
Чому: бо RSS кожного процесу – це пам’ять, mapped у virtual address space конкретного процесу, і може дублювати shared pages між процесами.
Тобто загальний RSS процесів може бути більшим, ніж значення memory.current їхньої cgroup.
А значення RSS в логах береться із файлу /proc/<PID>/status і полів RssAnon та RssFile.
Замість висновків
Насправді – залишилось незрозумілим чому саме контейнер був вбитий.
Точно був спайк памяті вище 1 GB, але чому… Ну – це Python. А profiling у девелоперів не включений.
До того ж це поки єдиний випадок OOM Kill цього сервісу – тому окей. Подивимось, як буде далі.
Але особисто для мене саме цікаве в цій історії був сам процес – коли нарешті це не запит до Claude/Codex в стилі “Альо, там алерт, йди розберись і пофіксь, make no mistakes” – а сидиш, колупаєшся сам, згадуєш, думаєш.
І це саме те, про я писав у AI: LLM, агенти, робота і ми – інженери. Особисті думки в частині “Роздум третій: лінь!“:
Агент не просто дозволяє нам не знати – агент привчає нас не намагатися згадати взагалі.
Раніше ми спочатку хвилину напрягали мозок – “Блін, avg чи sum – як воно там працює, в чому різниця?” – і паралельно це тригерило ті області пам’яті, ті нейрони, де ми зберігаємо знання про метрики, тайм-серії, формати даних.
І тільки після того, як ми подумали і згадали хоча б частину цього – ми йшли в документацію, але навіть тоді, використовуючи документацію – ми думали і згадували ще якісь релевантні деталі.
Треба включати – по можливості – власний мозок.
Нам це і корисно – і приємно, бо дофамінчік.
Дофаміну було б більше, якби знайшов причину – але і сам процес особисто мені подобається.
