 Головна ціль, для якої ми на проекті запроваджували LiteLLM AI Gateway (див. LiteLLM: AI Gateway для LLM – overview можливостей) – це контроль доступів і витрат, бо зараз ми не можемо включити автопоповнювання нашого акаунту в OpenAI або OpenRouter: наш стартап в стадії розробки і експериментів, девелопери активно використовують AI-агентів для роботи – можуть щось навайбокодити та почати занадто активно використовувати LLM. Та і самі наші сервіси зав’язані на LLM – і вони теж можуть “зійти з глузду” і почати витрачати забагато кредитів на провайдері.
Якщо не мати обмежень на ці витрати – одного ранку можемо “зрадіти” рахунку за попередню добу, і зараз це вирішується тим, що ми просто “дозовано” поповнюємо рахунки провайдерів, але часто зтикаємося з тим, що гроші закінчились (навіть попри алерти) – і сервіси отримують 429 та Openai.RateLimitError.
Тим більш, що алерти не завжди допомагають – бо OpenAI API просто не надає можливості отримати стан поточного залишку кредитів (дічь якась насправді, бо OpenRouter це чудово віддає).
Основний провайдер у нас (принаймні сьогодні) – OpenAI, плюс є моделі в OpenRouter – але OpenRouter використовується як fallback на випадок, якщо на OpenAI закінчились гроші (див. LiteLLM: OpenRouter та налаштування Fallbacks).
Отже, кінцева мета налаштувань LiteLLM Budgets – мати кредити в OpenAI постійно через автопоповнення, а контроль витрат перекласти на LiteLLM.
На додачу, на самому OpenAI будуть власні ліміти, бо в нього є можливість налаштувати Organization limits та Project limits – але там обмеження задаються тільки на місяць (“budget reset window”), а я хочу мати добові обмеження.
Тому ми будемо будувати такий собі “дворівневий захист”: нашим “головним контроллером” буде LiteLLM – а Limits самого OpenAI будуть в ролі “запобіжника”.
Крім того, мати налаштування і контроль на LiteLLM – це простіше, ніж налаштовувати це на різних провайдерах, особливо з врахуванням того, що пізніше можуть додатись моделі від Anthropic.
Ну і враховуємо те, що LiteLLM може некоректно рахувати витрати, наприклад – див. LiteLLM: дебаг AI Cost Monitoring з VictoriaMetrics, а тому мати “другий рівень безпеки” – це must have опція.
Отже сьогодні поговоримо про LiteLLM Budgets, коротко – про OpenAI Limits, про дуже важливу частину – моніторинг цього всього – VictoriaMetrics, grafana, алерти, і про деякі нюанси налаштування бюджетів в LiteLLM – бо там виявились деякі неочевидні моменти.
Зміст
LiteLLM Budgets
Документація – Budgets, Rate Limits.
В LiteLLM маємо два механізми обмеження використання – Budgets, які визначають якийсь максимум для використання, та ліміти – Tokens Per Minute (TPM) і Requests Per Minute (RMP).
Ми зараз почнемо саме з Budgets, а TPM && RMP ліміти при потребі налаштуємо пізніше, бо поки що з цим проблем не виникало – тому в тексті цього матеріалу термін “ліміт” буду використовувати в контексті саме бюджетів, а не TPM/RPM limits.
Важливий нюанс: для роботи бюджетів LiteLLM потрібна база даних, бо LiteLLM там зберігає і рахує spend – див. What is stored in the DB та Spend Tracking.
Якщо LiteLLM запущений з replicas, тобто має більше одного Kubernetes Pod – потрібен Redis для синхронізації даних.
LiteLLM має концепт “Team soft budget” – може відправляти повідомлення, якщо Team Budget скоро закінчиться. Але це Enterprise фіча, а у нас і так є алерти на відсоток використання бюджетів – далі поговоримо про моніторинг і алерти.
Типи бюджетів LiteLLM
Бюджети можна задавати на різних “рівнях”:
- Global Proxy Budget: один загальний бюджет для всіх запитів через LiteLLM
- Team Budget: спільний бюджет для всіх API keys (Virtual Keys), створених із відповідним
team_id- тут є один нюанс: якщо юзер включений в Team, але має права на створення ключа і створює його без прив’язки до Team – то ліміти команди на цей ключ не застосовуються
- Team Member Budget: персональний ліміт юзера всередині бюджету Team
- Internal User Budget: бюджет користувача для всіх його ключів, створених без
team_id- при цьому якщо ключ належить Team – персональний бюджет його власника не застосовується, а рахується тільки бюджет Team або Team Member
- Virtual Key Budget: окремий бюджет конкретного API key
- Customer / End User Budgets: бюджет для юзера, переданого в полі
userзапиту (user_id)- діє глобально для цього customer ID по всьому LiteLLM, незалежно від API key або Team
- Tag Budget: аналогічно до End User budget – загальний бюджет для запитів із певним тегом, який задається в параметрах API key або передається з клієнта (скрипта/сервіса)
- Model Access Group Budget: загальний бюджет для групи моделей для, наприклад, обмеження витрати на якісь дорогі premium-моделі
- Agent / Session Budget: бюджети для агентів та окремих agent sessions
Ще цікава можливість – Fallback to ‘free’ models: можна налаштувати моделі з “0” cost, встановити їх як fallback options, і тоді запити будуть направлятись на них навіть у випадках, коли Global Proxy Budget вже вичерпано. Але для цих моделей треба задавати в нуль і input_cost_per_token і output_cost_per_token.
У LiteLLM бюджети не наслідуються і не об’єднуються в один effective limit – тобто кожен бюджет перевіряється окремо, і запит блокується, щойно вичерпано хоча б один із них.
Планування: LiteLLM Teams та Budgets
Що ми маємо зараз організаційно: основне групування – це Teams. Наші Teams діляться на два “типи” – ServiceAccount Teams, та Users Teams.
Кожен наш сервіс має власну окрему Team на кожен environment, і в кожній такій Team може бути кілька різних API Keys (Virtual Keys в термінах LiteLLM) – бо в одному сервісі типу Backend API можуть бути різні фічі, які використовують різні API-ключі – і для кращого контролю витрат, і для моніторингу – аби мати метрики і графіки по окремим таким фічам.
Наприклад:
- Team:
svc-kraken-prod: наш Backend API, в ньому різні “feature services”, у кожного такого сервіса/фіча власний API Key:- ключі:
svc-kraken-chat-prod,svc-kraken-knowledge-base-prod
- ключі:
- Team:
usr-kraken-devs: тут ключі наших бекенд-девелоперів- ключі:
usr-andriy-dev,usr-dima-dev
- ключі:
- Team:
svc-system-ops: Ops team, тут в основному різні testing keys- ключі:
svc-system-testing-ops
- ключі:
Бюджети для початку будемо робити саме на рівні Teams – далі подивимось на моніторинг, на те, хто і скільки з бюджетів витрачає, і про потребі вже будемо задавати ліміти на конкретні Virtual Keys або конкретних юзерів.
Budget reset в LiteLLM зробимо раз на добу, по UTC – див. Budget Reset Times and Timezones.
Загальна схема обмежень LiteLLM та OpenAI
Отже, все разом буде виглядати так:
LiteLLM:
- має Global budget для всіх витрат
- має різні Teams, у кожної свої бюджети
- кожен наш сервіс використовує API Keys, які прив’язані до конкретної Team
OpenAI:
- має глобальний Organization Limit
- має ліміти на Organization Projects
- в Projects маємо окремий
litellm-project– там API ключ самого LiteLLM - маємо декілька додаткових Projects – бо деякі сервіси використовують OpenAI напряму, а не через LiteLLM
- в Projects маємо окремий
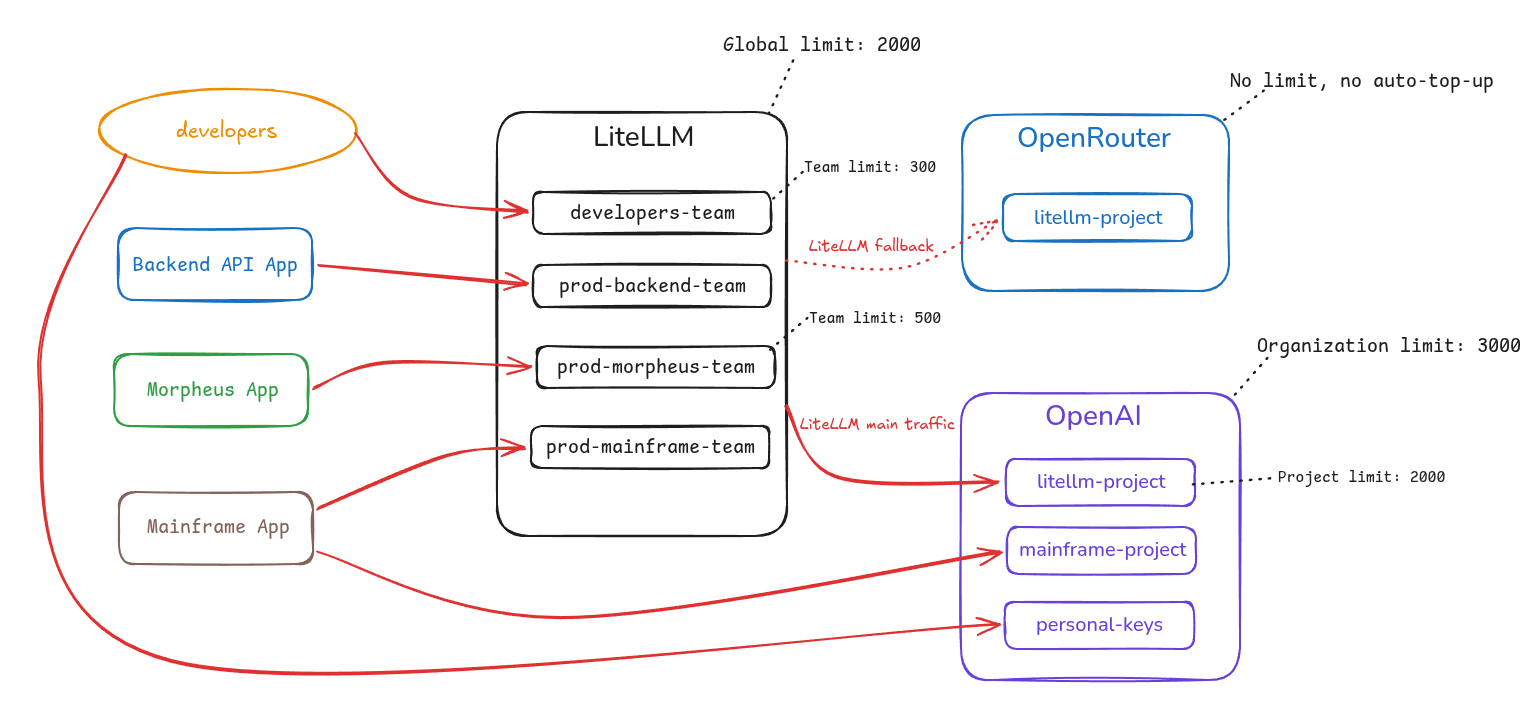
На схемі нижче маємо чотири групи “клієнтів” LiteLLM – девелопери, наш Backend API сервіс, та два інших наших сервіси – Morpheus та Mainframe.
Кожна група клієнтів використовує власні LiteLLM API Keys, які прив’язані до конкретної LiteLLM Team – але Mainframe App та девелопери роблять запити як через LiteLLM, так і до OpenAI напряму.
LiteLLM має налаштований Global Budget, і окремі бюджети на кожну Team, а LiteLLM використовує OpenAI API ключ із litellm-project в OpenAI.
В OpenAI маємо OpenAI Organization Limit з загальним лімітом на витрати – і окремі ліміти по кожному OpenAI Project:
 Моніторинг
Оце, мабуть, сама складна частина всієї системи.
По-перше – OpenAI повертає метрики не так, як хотілося б, по-друге – дані з LiteLLM можуть не співпадати з даними від OpenAI або від OpenRouter. Про це трохи далі.
З головного – що нам взагалі треба моніторити:
- по LiteLLM:
- витрати по Team та API Key
- відсотки використання бюджетів – Global і per Team
- по OpenAI – аналогічно:
- витрати по Project та API Key
- відсотки використання Limits – Organization та per Project
На додачу – я більше не дуже довіряю LiteLLM (після історії з LiteLLM: дебаг AI Cost Monitoring з VictoriaMetrics, про яку вже згадував вище), до того ж витрати рахуються трохи по різному – тому хочеться бачити дані, отримані і від LiteLLM – і від OpenAI (і трохи – від OpenRouter).
Spending metrics – LiteLLM та OpenAI
Для OpenAI є експортер foxdalas/openai-exporter, який повертає метрики по requests/tokens та spend, але в мене на проекті є наш власний експортер, де метрик трохи більше. Про нього варто було б написати окремо, може навіть починав і є чорнетка.
Для OpenRouter у нас є аналогічний експортер – тому маємо метрики витрат і там.
Ну і сам LiteLLM повертає метрики – розбирав в постах LiteLLM: метрики, traces та інтеграція з VictoriaMetrics Stack та LiteLLM: моніторинг з VictoriaMetrics – алерти та Grafana.
Головна проблема, з якою зіткнувся – те, що метрики самого LiteLLM мають тип Counter, а метрики, які віддають мої експортери – Gauge, тому, відповідно – ми не можемо просто мати однакові MetricsQL/PromQL запити і гарантовано бачити однакові результати.
Хоча по факту дані, які повертає OpenAI API поводяться як counter – бо лічильник обнуляється в 00:00 UTC, але саме з цієї причини ми не можемо мати метрику counter у власному експортері – бо тоді треба буде якось враховувати ці добові “скидання” значення.
Тому моя основна метрика – openai_cost_usd_daily з типом Gauge, яка має лейбли date, day_start та project, наприклад:
openai_cost_usd_daily {cluster="eks-ops-1-33",date="2026-06-26",day_start="1782432000",instance="openai-exporter-service:9108",job="openai-exporter",project="morpheus-prod",project_id="proj_Zd1***GOi",prometheus="ops-monitoring-ns/vm-k8s-stack"}
Тут лейбли date і day_start як раз використовуються для того, аби вирішити проблему зі скиданням лічильника на OpenAI на початку нової доби – ми залишаємо тип Gauge для нашої метрики, але як тільки змінюється доба – через оновлення лейбли date VictoriaMetrics починає формувати нову time series з новими значеннями (див. Metric vs Time Series vs Sample).
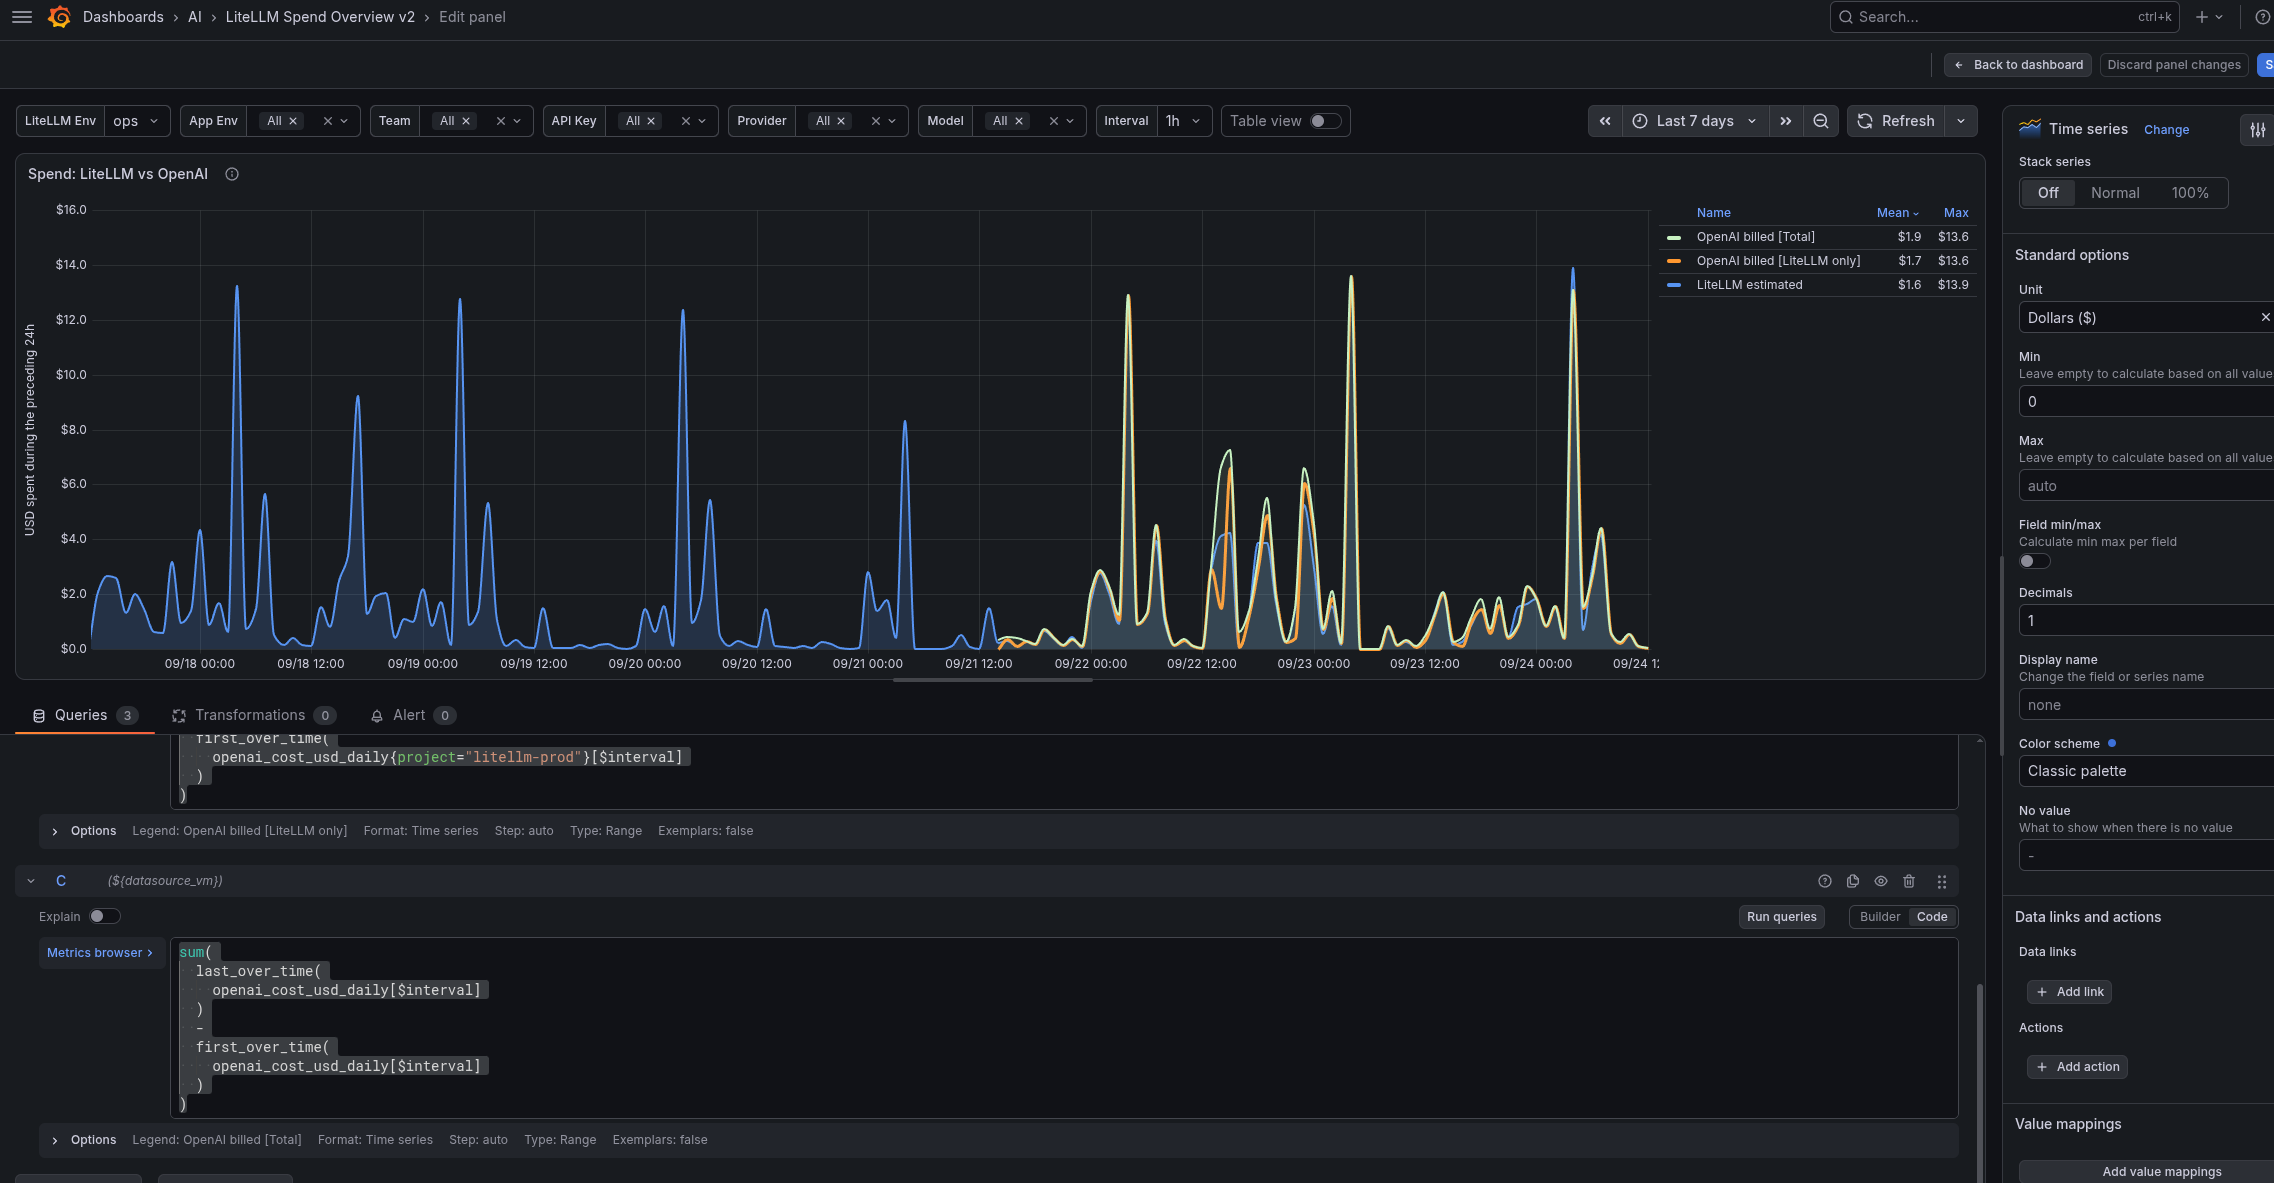
І використовуючи цю метрику і метрику від LiteLLM – Grafana маємо графік з трьома запитами, на якому чудово буде видно різницю між даними від OpenAI та LiteLLM.
Запит для графіку витрат LiteLLM:
sum(increase(
  litellm_spend_metric_total{
    env_name=~"$litellm_env",
    api_provider="openai"
  }[$interval]
))
Запит для графіку витрат OpenAI – але тільки по Project “litellm-prod” (це головне для порівняння з даними витрат, які рахує LiteLLM):
sum(
  last_over_time(
    openai_cost_usd_daily{project="litellm-prod"}[$interval]
  )
  -
  first_over_time(
    openai_cost_usd_daily{project="litellm-prod"}[$interval]
  )
)
І загальні витрати OpenAI – бо, як писав вище, частина запитів йде напряму:
sum(
  last_over_time(
    openai_cost_usd_daily[$interval]
  )
  -
  first_over_time(
    openai_cost_usd_daily[$interval]
  )
)
І все разом на графіку:
OpenAI Project Limit metrics
Аби відобразити дані по використанню лімітів в OpenAI – додавав окремі метрики:
openai_cost_usd_month_total: отримує значення витрат проекту за місяць (бо ліміти OpenAI задаються на місяць), тип Gauge (документація – GET /v1/organization/costs)openai_spend_limit_usd: значення soft limit по проектам (документація – GET /v1/organization/projects/{project_id}/spend_alerts)- береться саме soft limit – бо не для всіх проектів включаємо Hard Limit
- для hard limits – ендпоінт
/v1/organization/projects/{project_id}/spend_limit
Додатково маємо метрики, де експортер записує результат перевірки отримання результату openai_spend_limit_collection_success та openai_cost_collection_success: це зроблено на випадок, якщо була проблема з отриманням даних – або якщо для проекту ліміт не налаштований взагалі.
Запит в Grafana:
(
  100 * sum by (project) (openai_cost_usd_month_total)
  / on (project) group_left(project_id)
    max by (project, project_id) (
      openai_spend_limit_usd{scope="project", limit_type="soft"}
    )
)
and on() (min(openai_spend_limit_collection_success) == 1)
and on() (min(openai_cost_collection_success) == 1)
І сам графік: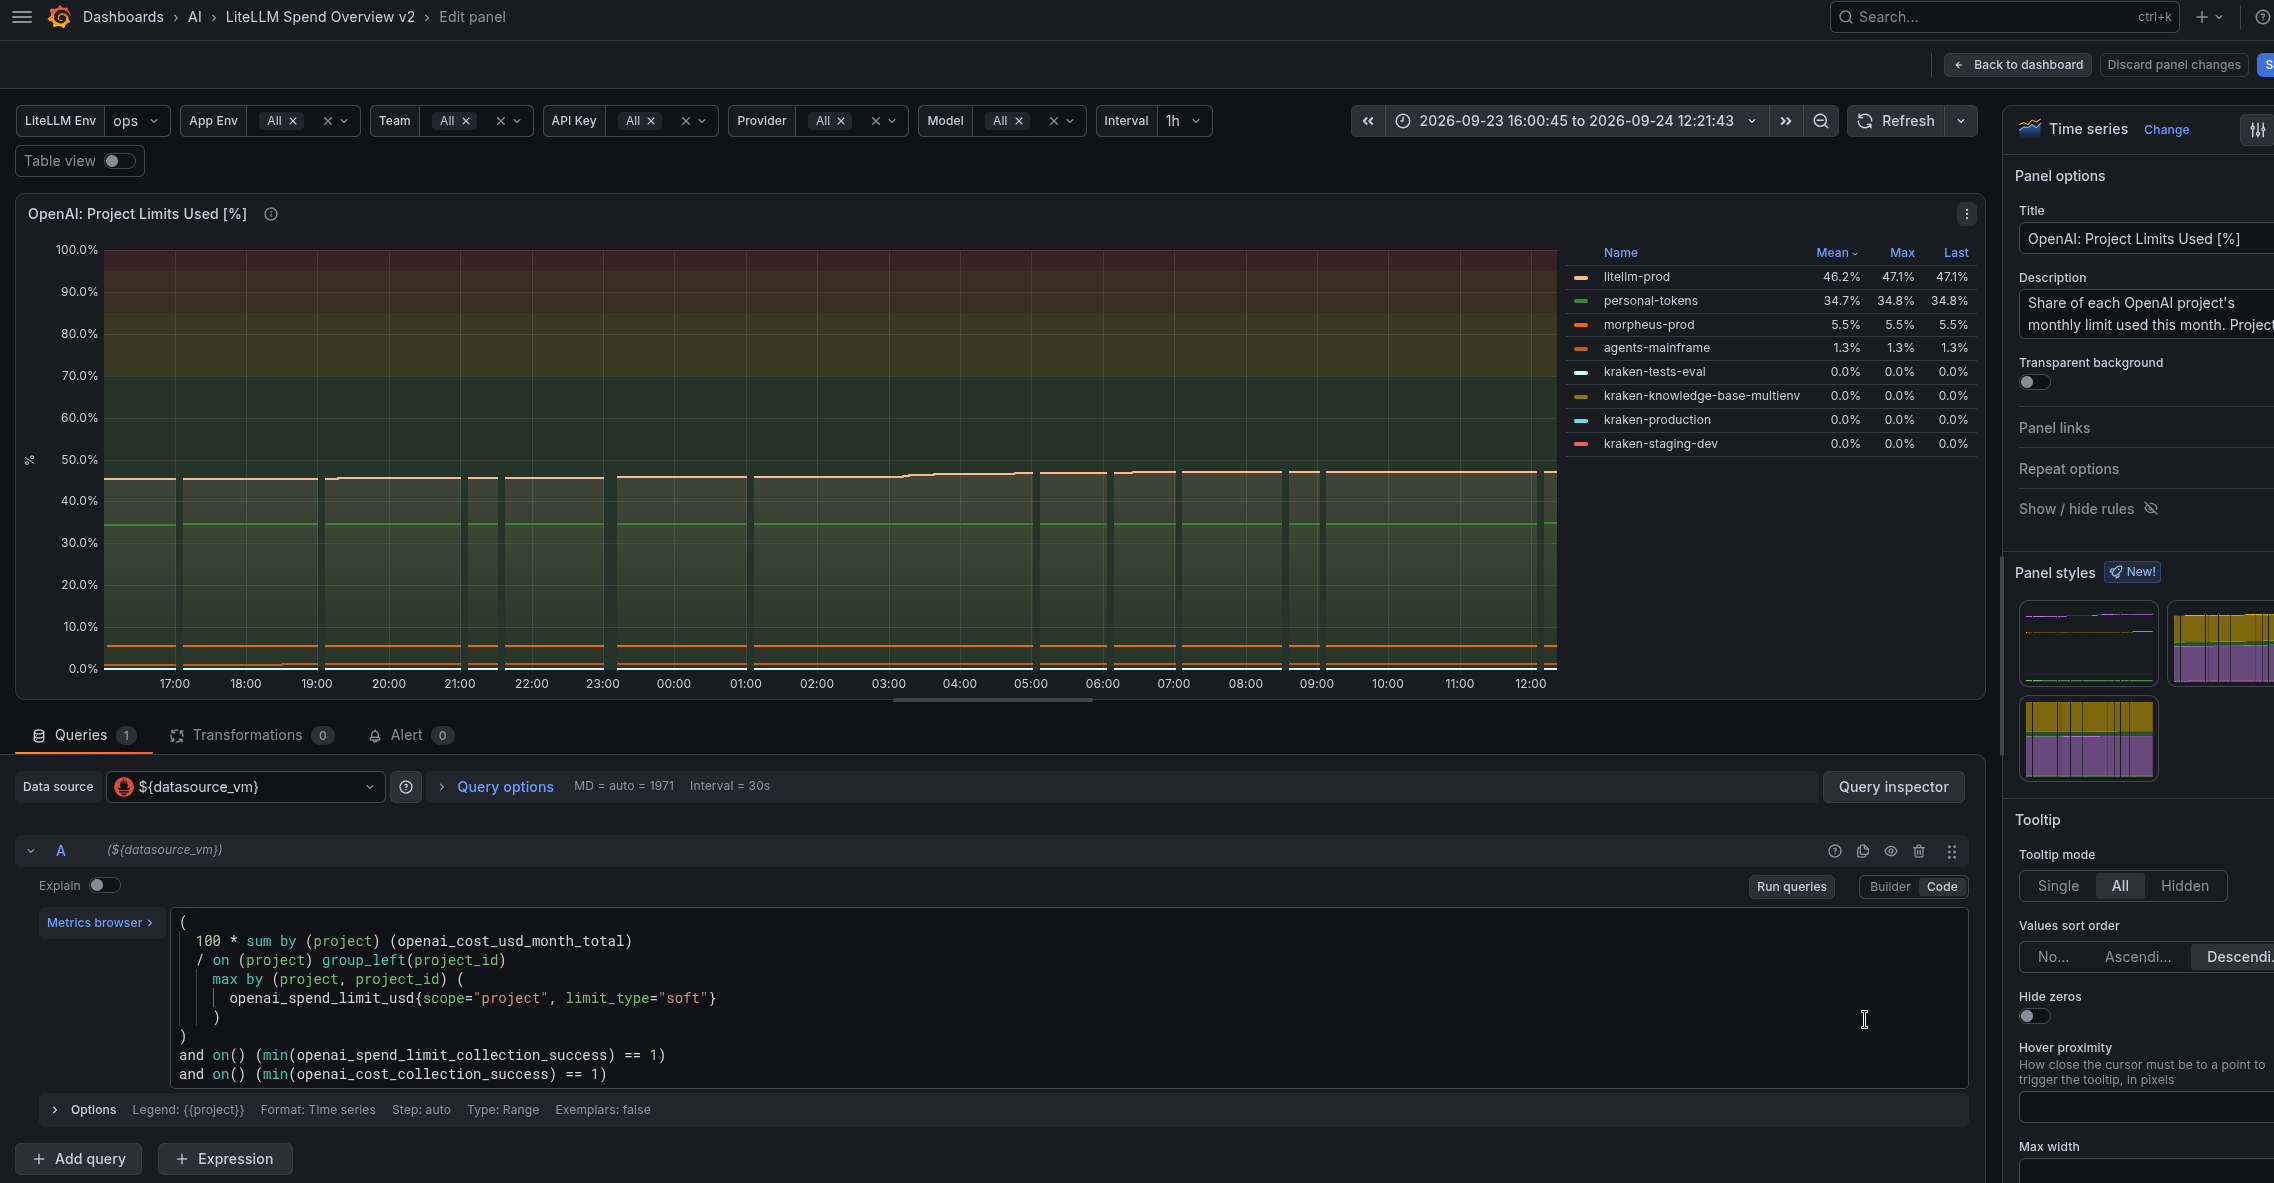
LiteLLM Team Budget metrics
Тут вже простіше – бо це дефолтні метрики LiteLLM.
Сам запит – відображаємо відсоток використання бюджету кожної Team:
100 * (
  1 -
  min by (namespace, team, team_alias) (
    litellm_remaining_team_budget_metric{
      env_name=~"$litellm_env",
      team_alias=~".*-${app_env}",
      team_alias=~"$team",
      team_alias!="",
      team_alias!="None"
    }
  )
  /
  (
    max by (namespace, team, team_alias) (
      litellm_team_max_budget_metric{
        env_name=~"$litellm_env",
        team_alias=~".*-${app_env}",
        team_alias=~"$team",
        team_alias!="",
        team_alias!="None"
      }
    ) > 0
  )
)
І графік:
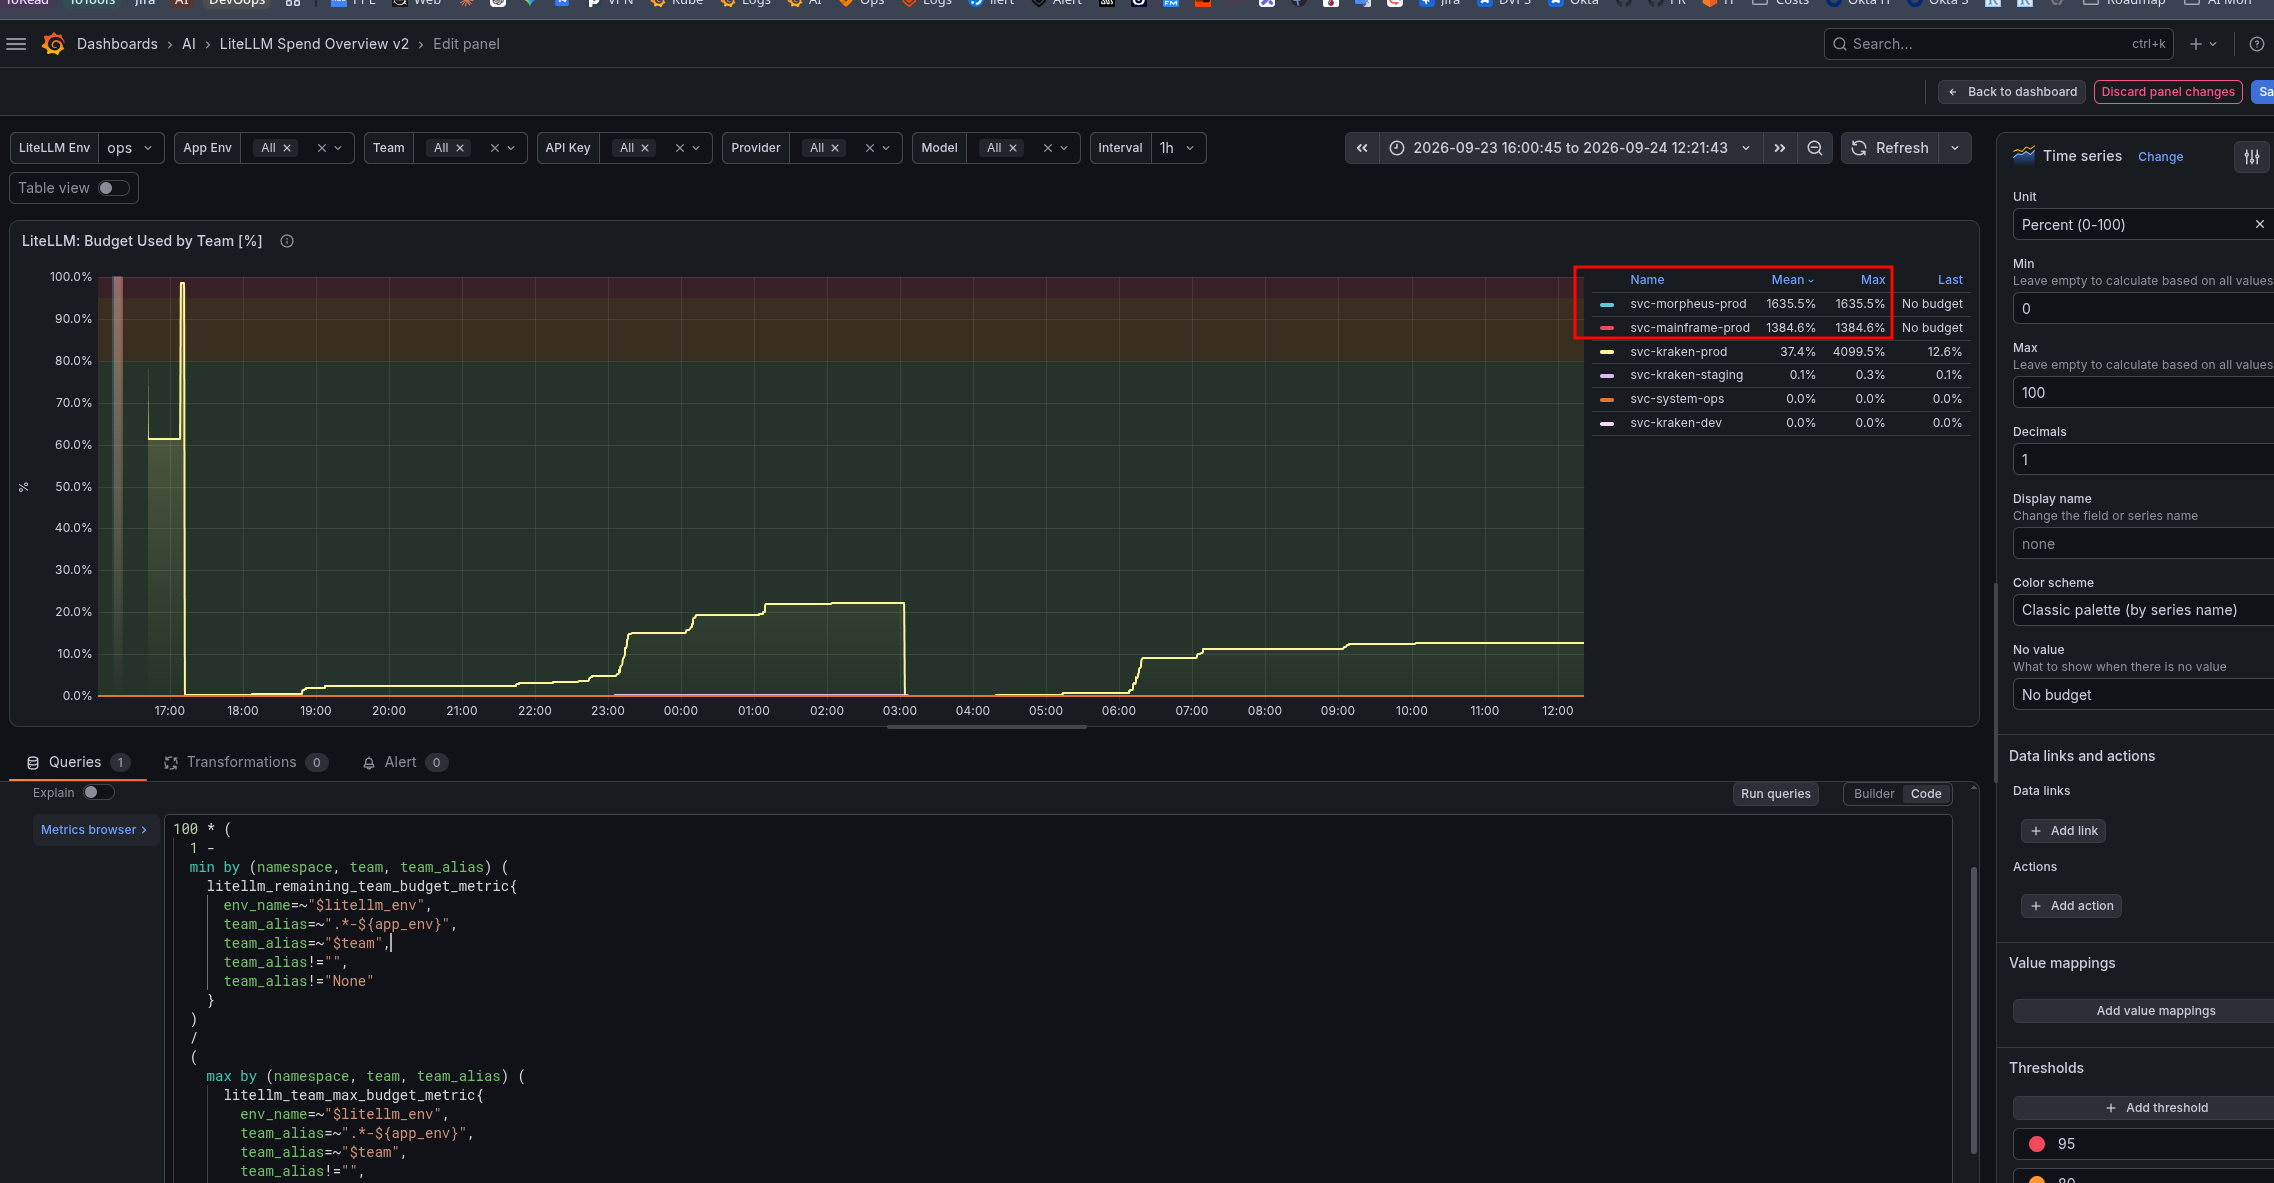
На графіку червоним виділив той самий “цікавий нюанс” з бюджетами LiteLLM, про який говорив на початку – далі про нього напишу окремо.
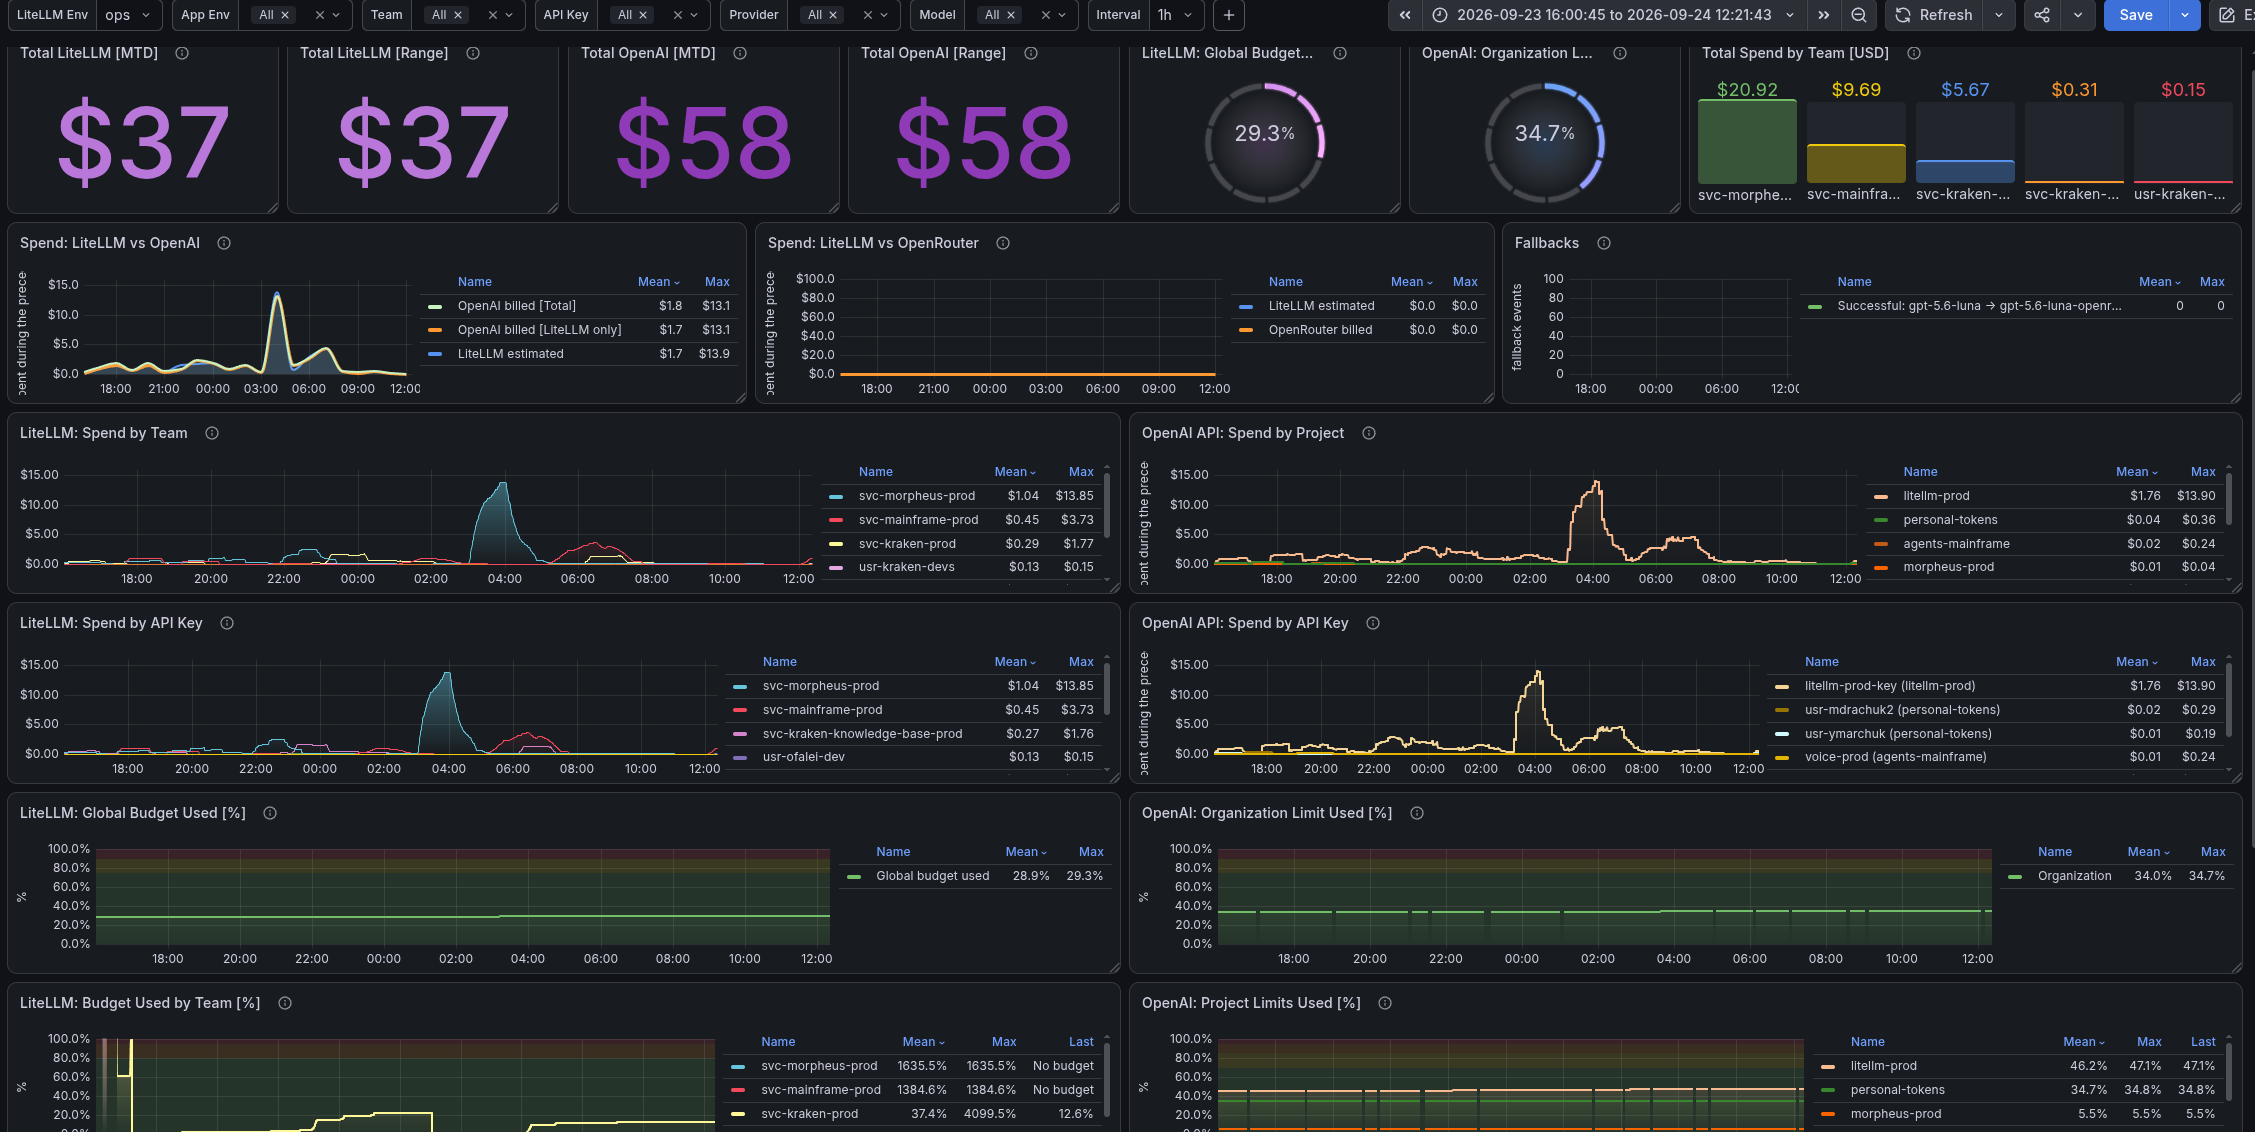
Вся дашборда зараз виглядає так:
Alerting
Коротко – про алерти.
Головне – нам треба повідомляти про те, що OpenAI Limits або LiteLLM Team Budget скоро будуть вичерпані.
Приклади алертів – LiteLLM, відсоток використання бюджету для Team:
# Team budget less than 10% remaining
- alert: LiteLLM Team Budget Low
  expr: |
    (
      min by (namespace, team, team_alias) (litellm_remaining_team_budget_metric)
      /
      (
        max by (namespace, team, team_alias) (litellm_team_max_budget_metric) > 0
      )
    ) * 100 < 10
  for: 5m
  labels:
    component: devops
    environment: ops
    severity: warning
    ilert_routingkey: devops-ops-warning
  annotations:
    summary: LiteLLM Team Budget Low
    description: |-
      LiteLLM team budget is less than 10% remaining
      *Namespace*: `{{ "{{" }} $labels.namespace }}`
      *Team*: `{{ "{{" }} $labels.team_alias }}`
      *Budget left percentage*: `{{ "{{" }} printf "%.0f" $value }}%`
      <https://{{ $.Values.monitoring.root_url }}/d/a24h8k/litellm-spend-overview-v2|:grafana: LiteLLM Spend Overview v2>
І аналогічний – для OpenAI Project Limits, тут є окремий rule, який формує метрику по типу тої, що використовуємо в Grafana:
rules:
  # Calculate current-month spend as a percentage of each project's positive
  # soft limit. The cost metric has the project name, while group_left adds
  # project_id from the limit metric. Health gates suppress stale API data.
  - record: openai:project_spend_limit_used_percent
    expr: |
      (
        100 * sum by (project) (openai_cost_usd_month_total)
        / on (project) group_left(project_id)
          max by (project, project_id) (
            openai_spend_limit_usd{
              scope="project",
              limit_type="soft"
            } > 0
          )
      )
      and on() (min(openai_spend_limit_collection_success) == 1)
      and on() (
        time() - max(openai_spend_limit_last_success_timestamp_seconds) < 900
      )
      and on() (min(openai_cost_collection_success) == 1)
      and on() (
        time() - max(openai_cost_last_success_timestamp_seconds) < 900
      )

  - alert: OpenAI Project Spend Limit Warning
    expr: |
      openai:project_spend_limit_used_percent
        >= 75
      and
      openai:project_spend_limit_used_percent
        < 90
    for: 10m
    labels:
      component: devops
      environment: ops
      severity: warning
      ilert_routingkey: devops-ops-warning
    annotations:
      summary: OpenAI project spend limit usage is high
      description: |-
        OpenAI project spend has used at least 75% of its monthly limit for more than `{{ "{{" }} $for }}`.
        *Project*: `{{ "{{" }} $labels.project }}`
        *Limit used*: `{{ "{{" }} printf "%.1f" $value }}%`
        <https://{{ $.Values.monitoring.root_url }}/d/a24h8k/litellm-spend-overview-v2|:grafana: LiteLLM Spend Overview v2>
Окремо є алерти на те, що LiteLLM Team або OpenAI Project не мають налаштованого Budget/Limit – на випадок, якщо хтось створить нову тіму або проект і не задасть обмежень.
LiteLLM:
# Alert when a team exists but has no positive max budget.
- alert: LiteLLM Team Budget Not Configured
  expr: |
    min by (namespace, team, team_alias) (
      litellm_remaining_team_budget_metric{
        team_alias!="",
        team_alias!="None"
      }
    )
    unless on (namespace, team, team_alias)
    max by (namespace, team, team_alias) (
      litellm_team_max_budget_metric{
        team_alias!="",
        team_alias!="None"
      } > 0
    )
  for: 30m
  labels:
    component: devops
    environment: ops
    severity: warning
    ilert_routingkey: devops-ops-warning
  annotations:
    summary: LiteLLM team budget is not configured
    description: |-
      A LiteLLM team has no positive max budget configured for more than `{{ "{{" }} $for }}`.
      *Namespace*: `{{ "{{" }} $labels.namespace }}`
      *Team*: `{{ "{{" }} $labels.team_alias }}`
      <https://{{ $.Values.monitoring.root_url }}/d/a24h8k/litellm-spend-overview-v2|:grafana: LiteLLM Spend Overview v2>
OpenAI:
- alert: OpenAI Project Spend Limit Not Configured
  expr: |
    (
      max by (project, project_id) (
        openai_project_info{status="active"} > 0
      )
      unless on (project, project_id)
      max by (project, project_id) (
        openai_spend_limit_usd{scope="project"} > 0
      )
    )
    and on() (min(openai_spend_limit_collection_success) == 1)
    and on() (
      time() - max(openai_spend_limit_last_success_timestamp_seconds) < 900
    )
  for: 30m
  labels:
    component: devops
    environment: ops
    severity: warning
    ilert_routingkey: devops-ops-warning
  annotations:
    summary: OpenAI project spend limit is not configured
    description: |-
      An active OpenAI project has no positive spend limit configured for more than `{{ "{{" }} $for }}`.
      *Project*: `{{ "{{" }} $labels.project }}`
      <https://{{ $.Values.monitoring.root_url }}/d/a24h8k/litellm-spend-overview-v2|:grafana: LiteLLM Spend Overview v2>
Визначення розміру OpenAI Limits та LiteLLM Budgets
Взагалі, можна просто руками глянути значення в VictoriaMetrics/Prometheus.
Для LiteLLM я буду робити бюджети per day – тому беремо максимальне значення витрат в день за, наприклад, останній місяць:
max_over_time((
  sum by (team_alias) (
    increase(
      litellm_spend_metric_total{
        env_name="ops",
        team_alias!="",
        team_alias!="None"
      }[1d]
    )
  )
)[30d:1d])
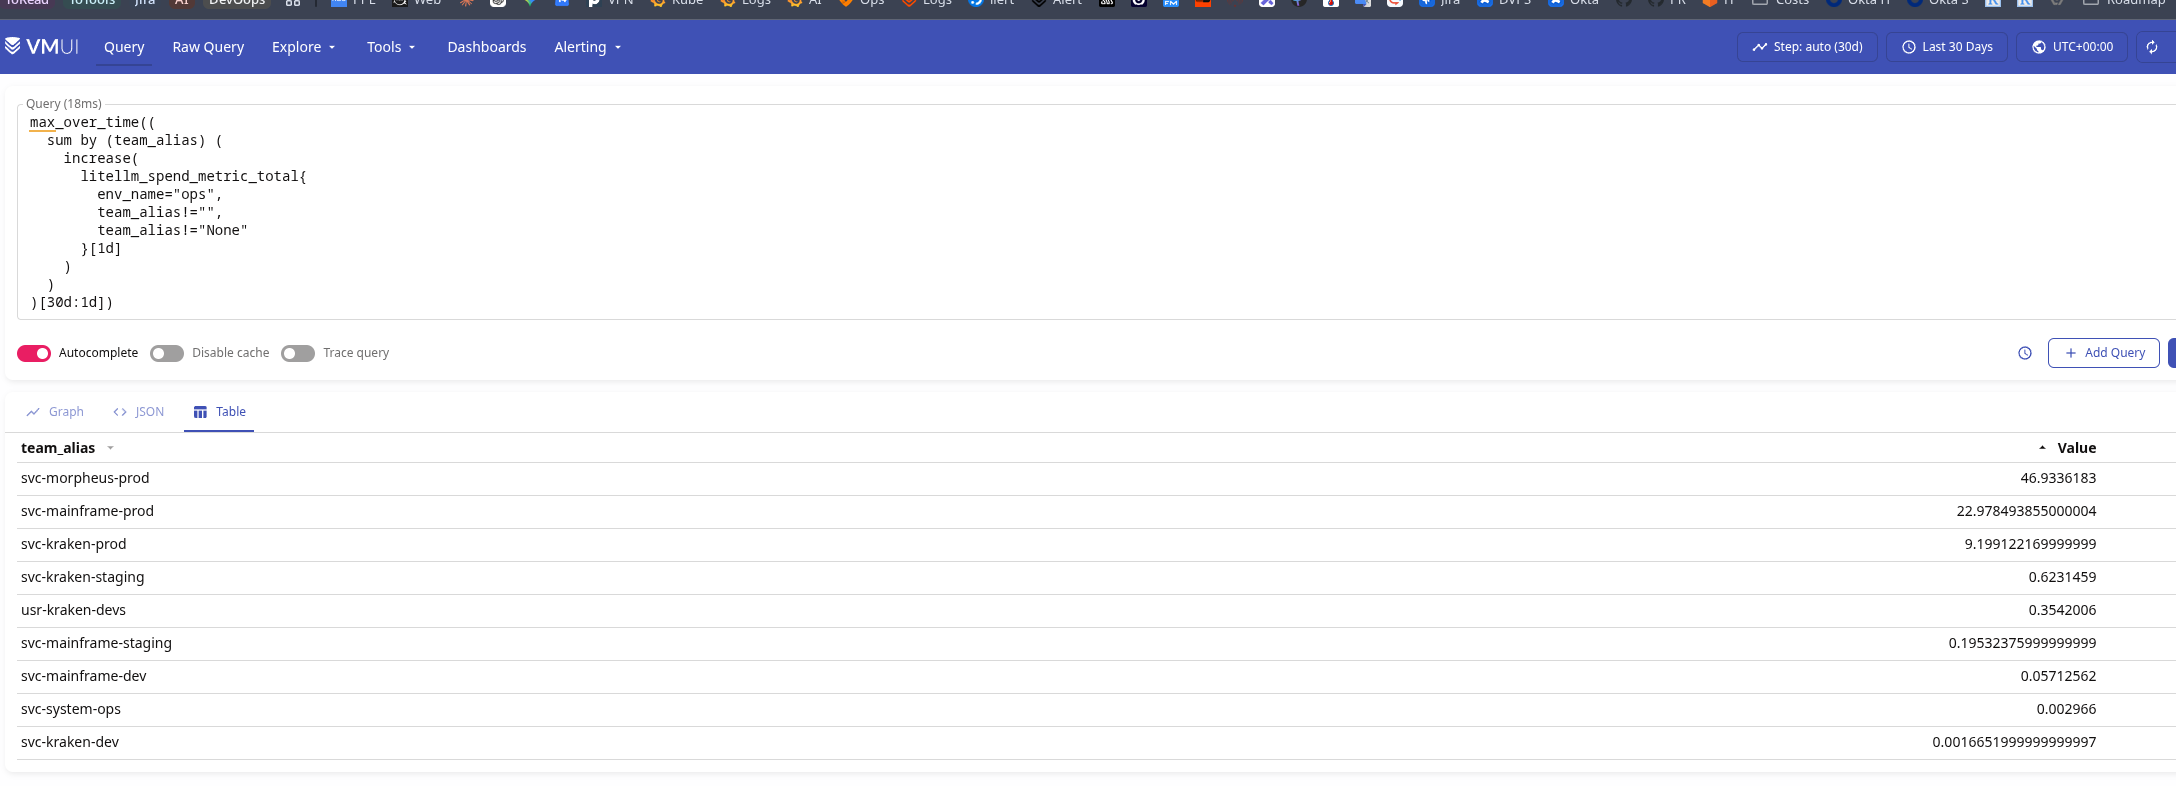
І аналогічно для OpenAI – але тут простіше, бо в мене і так є окрема метрика таких витрат:
max by (project) (
  openai_cost_usd_month_total
)
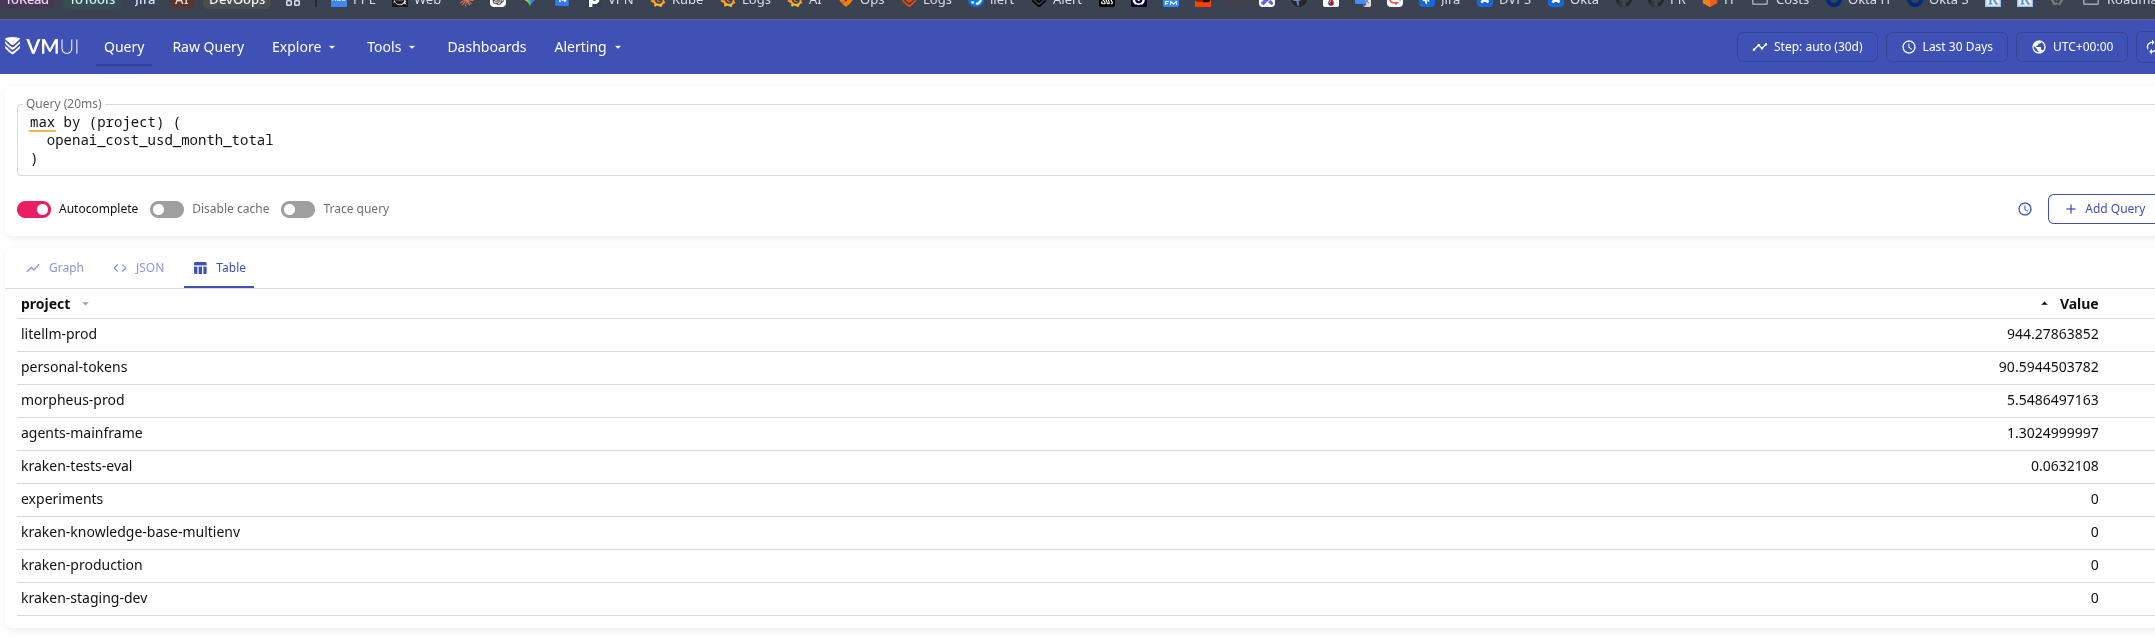
І вже знаючи максимальні значення – можемо прикинути те, які ліміти/бюджети задавати.
Або навіть зробити собі такі таблички в Grafana:
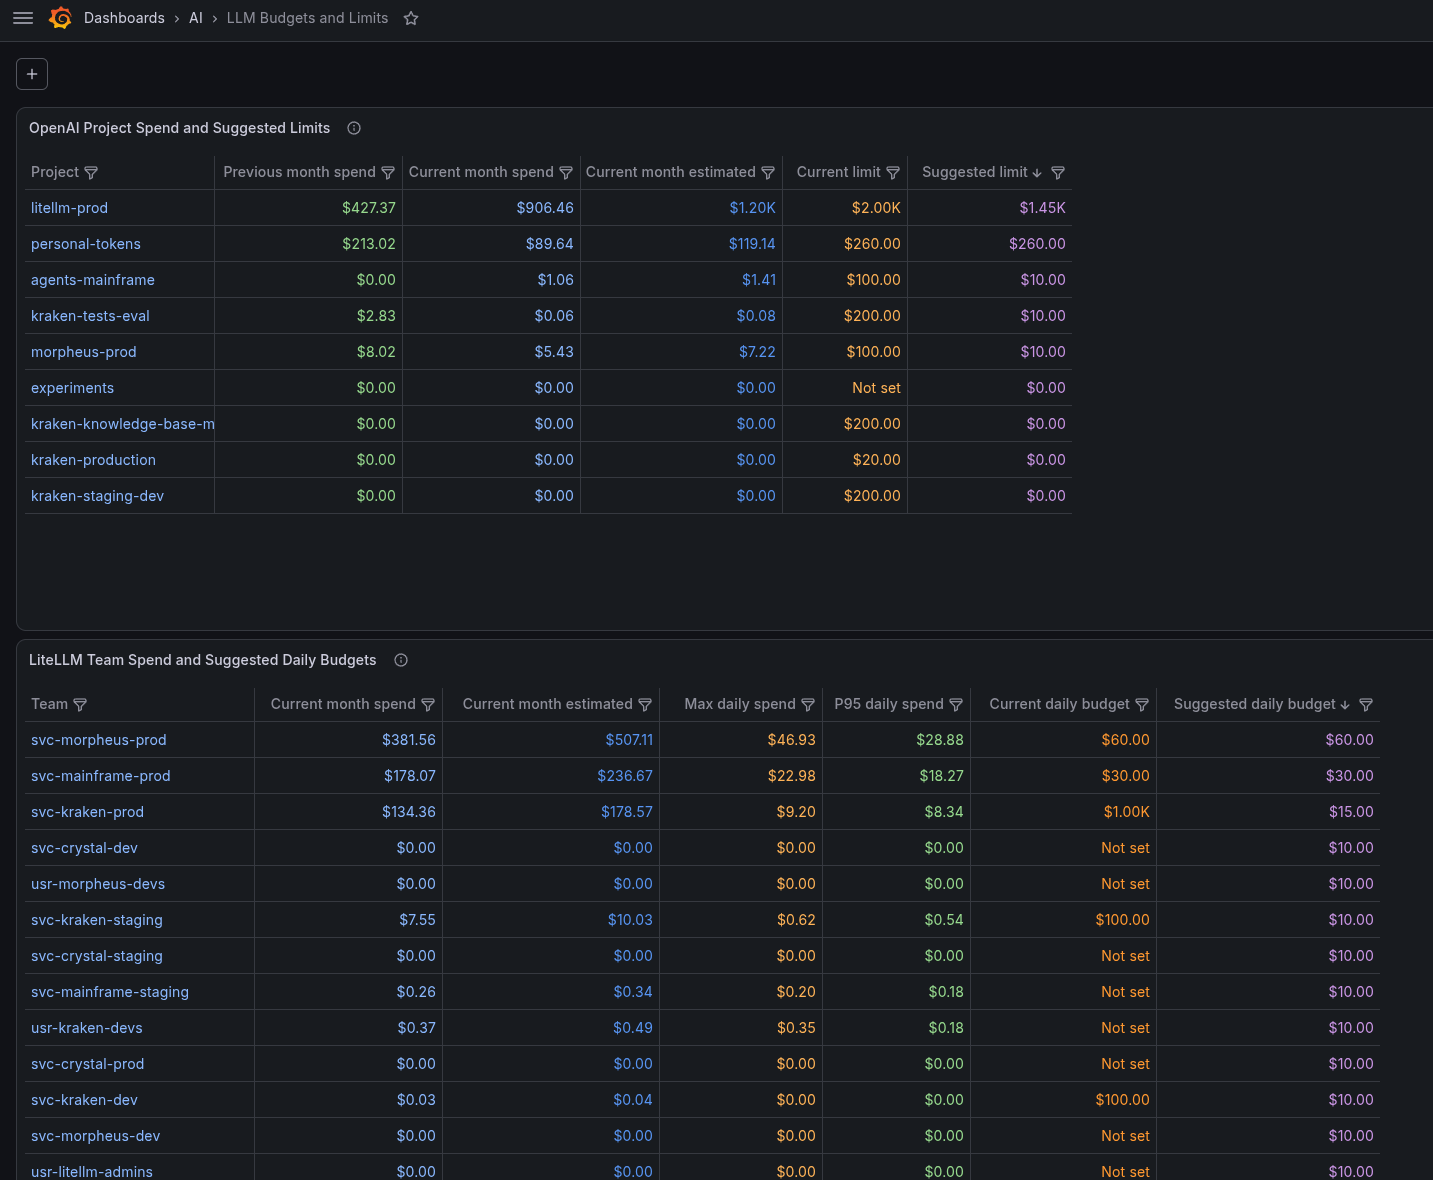
Де “Suggested daily budget” = “Max daily spend” за останні 30 днів помножений на 1.2.
Реальні бюджети і ліміти ставив вже сам, але просто як інформація про те, від цього відштовхуватись – зручно.
LiteLLM Budgets: налаштування та важливий нюанс із Spending та reset window
Якщо в OpenAI ліміти задаються без проблем – то з LiteLLM зловив цікавий момент.
Отже, що треба зробити – задати Daily Spend Budget для LiteLLM Team.
Здавалося б, все просто – перейти в налаштування Team, і задати значення:
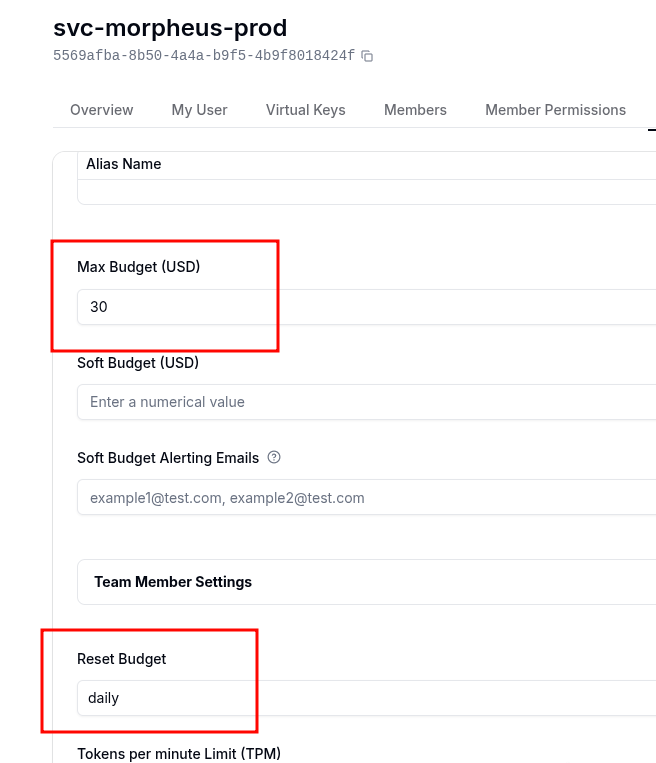
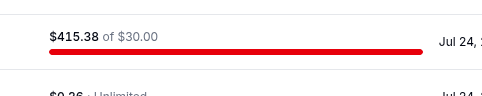
Але, коли я почав встановлювати ці значення для Teams – побачив цікаву картину в самому LiteLLM:
А потім – протестував в production те, як працюють алерти 🙂
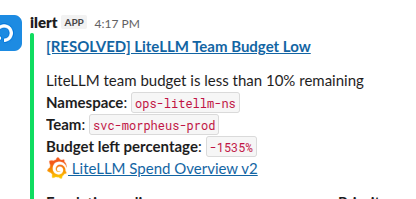
В чому причина: якщо LiteLLM Team була створена без budget reset window – то її Spend рахується від початку створення цієї Team.
Коли ми задаємо max_budget та budget_duration (див. Team) – то в Spend цієї team попадає значення, яке вже нараховано – те саме, яке “від початку створення цієї Team”.
А обнулиться воно тільки тоді, коли настане час чергового budget_duration – в моєму випадку я задавав його раз на добу.
Тому як “workaround” (або не дуже красивий і грязний хак) – спочатку задаємо значення Reset Budget в, наприклад, 1 годину, чекаємо, коли поточний Spend скинеться в нуль – а вже потім задаємо добовий ліміт і Reset Budget в 1 день.
Є схожа GitHub Issue – Applying budget_duration on an existing key/user/team doesn’t reset carried spend.
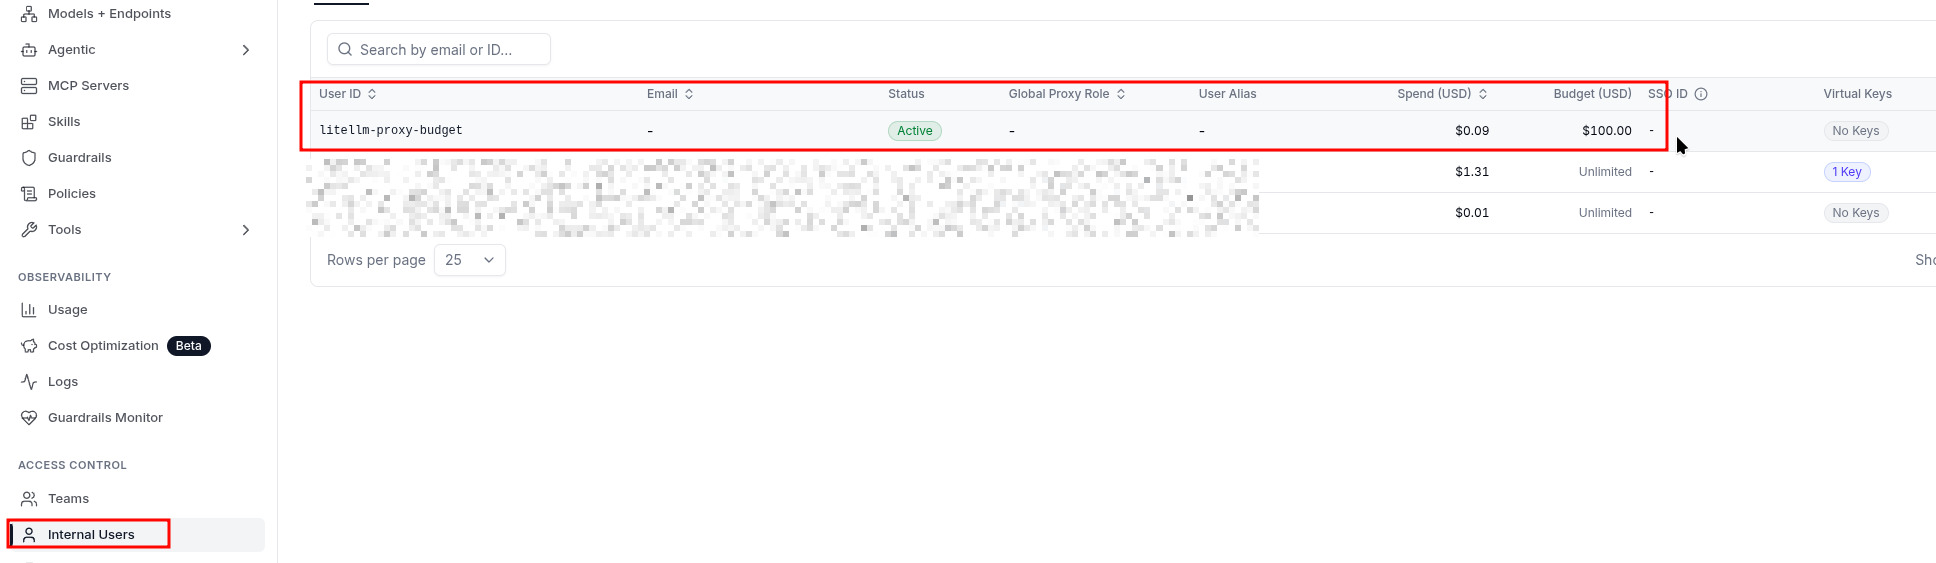
І ще один цікавий момент – шукав, де в UI відображається налаштований Global Proxy Budget.
Сюрпрайз – в Internal Users створюється новий юзер litellm-proxy-budget, і бюджет заданий йому:
 Власне, на цьому поки все.
Всі Limits та Budgets включені – чекаємо, хто впаде першим 🙂
